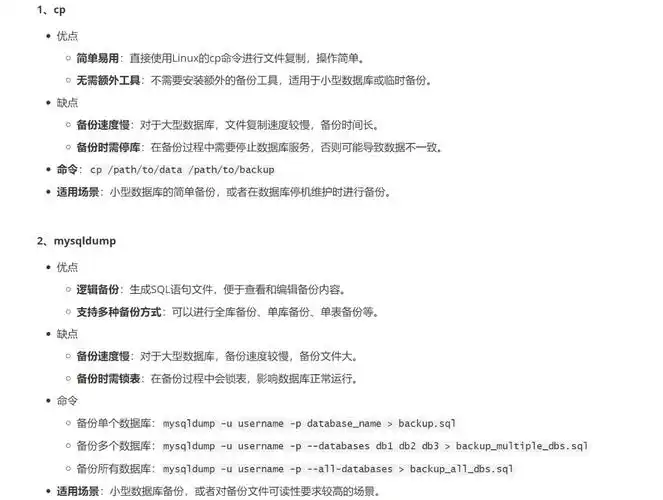
备份先分清两件事:全量能不能恢复到某个时间点,以及增量日志有没有一起留下。mysqldump 加 --single-transaction 能给 InnoDB 一张一致快照,但它只覆盖备份开始那一刻;从备份结束到故障发生之间的数据要靠 binlog 补齐。所以一套能用的备份通常由「全量文件 + 位点或 GTID + 从该位点开始可读的二进制日志」三部分组成,缺任何一项都只能恢复到一半。
备份能不能用,通常取决于三件事:备份时是否留下了 binlog 位点或 GTID、要备份的表是不是 InnoDB、以及这套文件是否在别的实例上真正恢复过一次。建议全量逻辑备份配位点记录,再用 binlog 补增量,最后用行数和校验和比对;没验证过的备份只能算候选文件,不能算可恢复。
MySQL中的一些备份恢复:先把能核对的事实摆清楚
动手前先在目标实例上把这几个值查出来,它们决定了后面能用哪种方式。命令输出的每一行都是可以直接核对的事实,不是经验判断。
SELECT VERSION();
SHOW VARIABLES LIKE 'log_bin';
SHOW VARIABLES LIKE 'binlog_format';
SHOW VARIABLES LIKE 'gtid_mode';
SHOW VARIABLES LIKE 'log_error';
SHOW BINARY LOGS;版本号决定参数名:mysqldump 记录位点的选项在旧版本里叫 --master-data,新版本改成了 --source-data。具体哪个名字在当前实例上生效,用 mysqldump --help | grep -i -E 'source-data|master-data' 确认,不要凭记忆写。同样地,主从状态的命令在 8.0.22 之后由 SHOW SLAVE STATUS 变成 SHOW REPLICA STATUS,两个都可以先试一下看哪个不报错。
存储引擎也要先看清楚:SELECT table_schema, engine, COUNT(*) FROM information_schema.tables WHERE table_schema NOT IN ('mysql','sys','information_schema','performance_schema') GROUP BY table_schema, engine;。如果结果里出现 MyISAM 或 MEMORY,--single-transaction 对它们不产生一致性保证,这类表需要单独安排只读窗口或者换物理备份工具。
错误日志位置由 log_error 给出,恢复失败时先看这个文件里的最后几十行,比在客户端里猜要快。如果是托管数据库的控制台,对应的是「备份列表」里的备份完成时间、备份大小、以及「日志备份」是否开启这几个字段,点开就能看到,不需要登录实例。
MySQL中的一些备份恢复最容易搞错的一点
最常见的误解是把「mysqldump 正常退出、文件大小不为零」当成「这份备份可以恢复」。这两件事之间没有必然关系:导出过程中如果混有非事务表,文件可能完整但内部不一致;如果用 --databases 导出又没注意字符集,恢复到新实例时可能出现乱码或建表失败;如果开了 GTID,导出文件头部的 SET @@GLOBAL.GTID_PURGED 语句在目标实例已有数据时会直接报错中断。
判断分界是一个动作:把备份文件恢复到一个临时实例或者新建的库名里,而不是覆盖原库。只需要改一个目标库名就能区分两种情况——恢复过程零报错、行数和源库对得上,说明这份文件可用;中途出现 ERROR 1418、ERROR 1840 或者 GTID 相关错误,说明文件本身没问题而是导入姿势不对,需要加 --set-gtid-purged=OFF 重新导出或调整导入参数。在源库上反复看文件大小是区分不出来的。
MySQL中的一些备份恢复:一个照着就能做完的做法
下面这条路径适用于单库、表以 InnoDB 为主、数据量在几十 GB 以内的场景。数据量再大或者有大量非事务表时,通常改用物理备份工具(如 Percona XtraBackup)更稳妥,但验证思路是一样的。
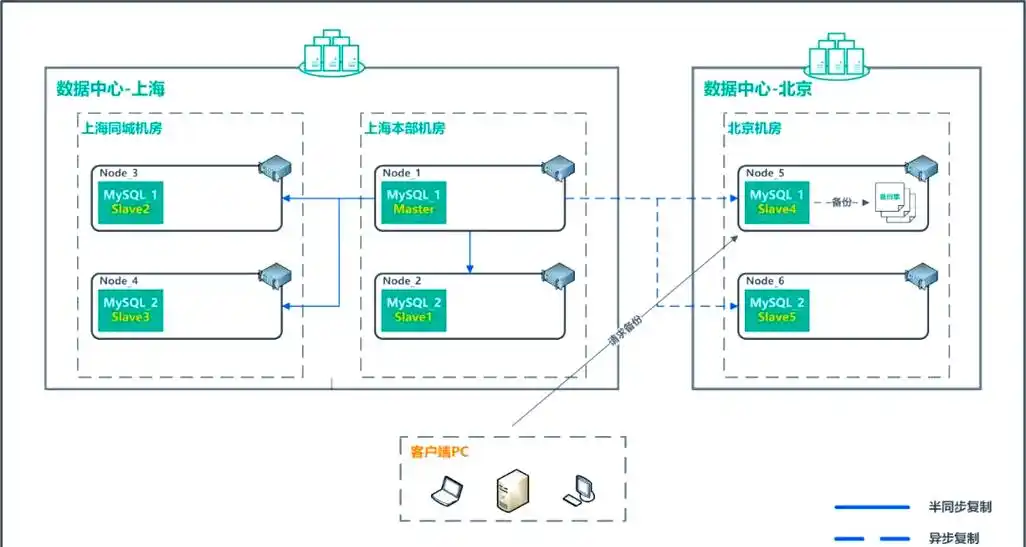
第一步,导出全量并记录位点。注意先确认当前版本支持哪个参数名。
mysqldump -h 127.0.0.1 -uroot -p \
  --single-transaction \
  --source-data=2 \
  --routines --triggers --events \
  --default-character-set=utf8mb4 \
  --databases appdb \
  > /backup/appdb_$(date +%F_%H%M).sql
这一步该看到什么:命令结束时退出码为 0;文件头部有一段被注释起来的位点信息,形如 -- CHANGE MASTER TO MASTER_LOG_FILE='mysql-bin.000123', MASTER_LOG_POS=456789;(新版本写作 CHANGE REPLICATION SOURCE TO SOURCE_LOG_FILE=...)。把这一行连同文件名单独记一份,后面补增量全靠它。
第二步,恢复到新库验证。先建空库再导入,避免动到原数据。
mysql -uroot -p -e "CREATE DATABASE appdb_restore CHARACTER SET utf8mb4"
mysql -uroot -p appdb_restore < /backup/appdb_20240101_0300.sql
这一步该看到什么:导入过程中没有 ERROR 输出;结束后 SHOW TABLES 能列出源库的全部表名。-p 与密码之间不加空格,写成 -p密码 或走 ~/.my.cnf,否则会卡在交互输入上。
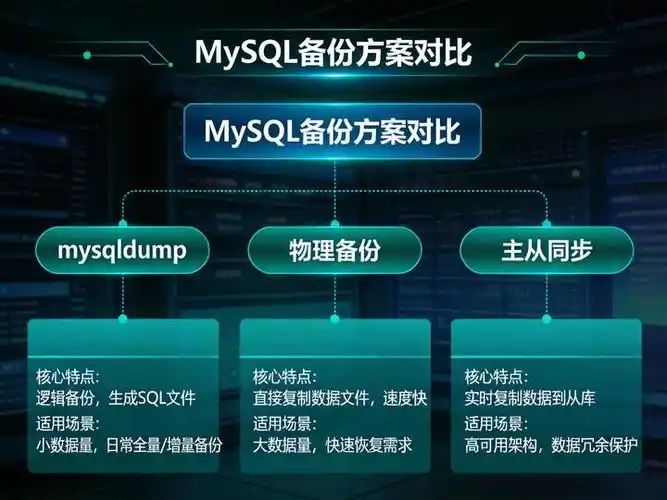
第三步,用 binlog 补到故障前一刻。以时间点为例:
mysqlbinlog --start-datetime='2024-01-01 03:00:00' \
  --stop-datetime='2024-01-01 09:30:00' \
  /var/lib/mysql/mysql-bin.000123 \
  | mysql -uroot -p appdb_restore
用 GTID 环境时改为按 GTID 区间提取,可先用 mysqlbinlog --base64-output=decode-rows -v 把文件解码成可读文本,确认起止位置对不对再执行重放。这一步该看到什么:解码输出里能看到每一行变更的前后值,说明 binlog_format 是 ROW 且文件未被截断。
MySQL中的一些备份恢复:怎么验证结果对不对
验证分两层,先比结构再比数据,最后核对位点。
- 表数量一致:
SELECT COUNT(*) FROM information_schema.tables WHERE table_schema='appdb_restore';与源库同名查询对比。 - 行数一致:对核心表逐个执行
SELECT COUNT(*) FROM appdb_restore.orders;,与源库同一张表比较。 - 内容一致:
CHECKSUM TABLE appdb_restore.orders, appdb.orders;正常情况下两张表的 Checksum 值相同;出现 NULL 或数值不同说明数据或引擎不一致。 - 位点一致:恢复完成后在目标实例执行
SHOW MASTER STATUS;,文件号和位置应当与 binlog 重放到的终点吻合;用 GTID 的话执行SELECT @@GLOBAL.gtid_executed;,集合应当包含到故障点为止的事务。
正常结果长什么样:CHECKSUM 两张表数值相同且非 NULL,行数差为零,导入日志里只有 Warning 没有 Error,错误日志在恢复时间段内没有出现表损坏或崩溃恢复提示。只要有一项对不上,就退回上一步确认是备份文件不完整还是重放区间选错,不要在已经恢复出来的库上继续追加变更。建议把每次恢复演练的 CHECKSUM 输出和位点一起存档,下次真正需要恢复时,这份记录就是最直接的对照物。