搭建一套 AI 知识库,卡住的地方通常不在选模型,而在文档进来之后的三处:文件有没有被解析出正文、切出来的片段有没有真的写进向量库、检索回来的那几条是不是用户问的那一段。这三处任何一处断了,接口照样返回 200,回答却是编的。下面按排查顺序写,先给能直接跑的命令和能对上的字段,再讲三个前提和一条最短路径。
判断一套 AI 知识库是否真的搭起来,看三个可核对点:向量表里有 chunk 行数、检索接口返回体里带 sources 原文片段、拿一篇没见过的文档提问能命中对应段落。适用场景是自建或半自建的检索增强方案;托管型产品的解析和索引过程不可见,这套核对方法用不上。风险边界:embedding 模型一旦更换,历史向量需要整体重算,否则检索结果不可信。
AI知识库怎么搭建和使用
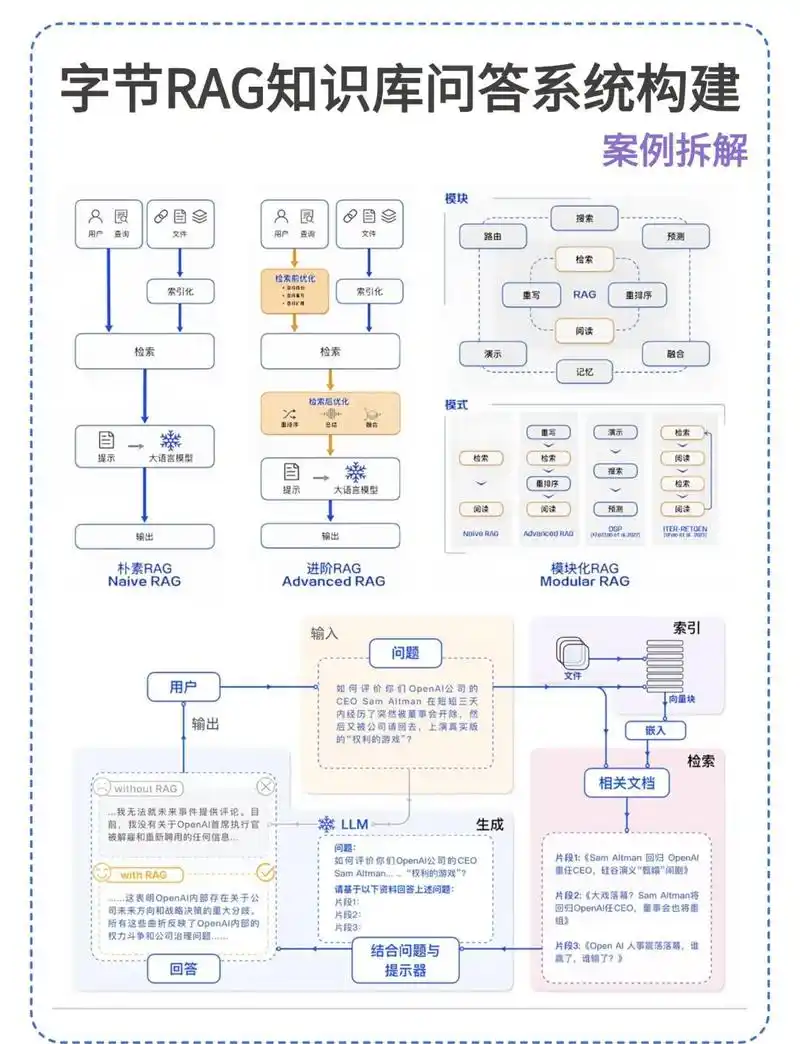
「使用」在整条链路里对应检索这一段,不是入库。它跑通的标志是:用户提问 → 走同一套 embedding → 向量库里取 top_k → 返回的片段里能看到原文。判断是不是卡在这一步,看接口返回体有没有 sources 或 citations 字段,以及日志里 retrieval 阶段有没有打出命中条数和分数。
先单独验证 embedding 服务,不经过业务代码:
curl -s http://127.0.0.1:8080/v1/embeddings \
  -H 'Content-Type: application/json' \
  -H "Authorization: Bearer $EMBED_KEY" \
  -d '{"model":"bge-m3","input":["服务器登录不上怎么办"]}'
期望看到 data[0].embedding 是一个浮点数组,长度等于建表时写的 vector 维度(bge-m3 通常是 1024)。长度对不上,后面插入会直接报错;长度对得上但检索总返回同一批结果,多半是索引没建或向量全是零。
再确认索引侧有数据、能算距离。在 psql 里执行,表名按自己环境替换:
SELECT count(*) FROM chunks;
SELECT doc_id, seq, left(content, 60) AS head,
       round((embedding <=> (SELECT embedding FROM chunks ORDER BY id LIMIT 1))::numeric, 3) AS dist
FROM chunks
ORDER BY embedding <=> (SELECT embedding FROM chunks ORDER BY id LIMIT 1)
LIMIT 5;
能出 5 行、head 是可读中文、dist 之间有差异,说明存储和检索这一段是通的。dist 全部相同或 head 是乱码,问题在入库侧,不在检索侧。
AI知识库怎么搭建和运营
「运营」对应的是增量与下线,不是再搭一遍。文档改了要不要重切、删掉的文档还能不能被召回、换 embedding 模型后旧向量怎么处理,这三件事决定知识库能不能长期用。可核对的位置是入库任务日志里的成功/失败条数、documents 表的 updated_at,以及 chunks 表里同一 doc_id 的切片是否连续。
-- 按文档看 chunk 数与最后写入时间
SELECT doc_id, count(*) AS chunks, max(updated_at) AS last_write
FROM chunks GROUP BY doc_id ORDER BY last_write DESC LIMIT 20;

-- 抽查一篇文档的切片是否连续、有没有串行
SELECT seq, left(content, 80) FROM chunks WHERE doc_id = 1024 ORDER BY seq LIMIT 5;
删除类操作要验证得笨一点:删掉一篇文档后,拿它的标题原文去检索,确认召回里不再出现这篇的片段。这一步建议每次都做,因为向量库删除失败不会报错给前端,只会在检索结果里悄悄留下已经作废的内容。
评测集先攒小而具体的:把日常最常问的 20 个问题记下来,每次换切分参数或换 embedding 模型,把这 20 个问题跑一遍,人工看命中片段对不对。不需要先上评测框架,有一个能重复跑的列表就够。
AI知识库之前先确认这三件事
版本、权限、入口位置,缺一个都会卡在很莫名的地方。
- 版本(模型与向量维度):embedding 模型名要和建表维度对得上,并且写入时把 model 名字记到行里。看的地方是
\d chunks里的embedding vector(1024),以及SELECT DISTINCT model FROM chunks;。两个模型混写进一张表,明显更难召回,而且不报错。 - 权限:入库账号要有 chunks 表的 INSERT,查询账号只需要 SELECT;embedding 服务的 key 在环境变量里,用
env | grep -i embed确认容器里真的有值。授权用\dp chunks看,别只看配置文件写没写。 - 入口位置:文档从哪里进来要具体到目录或接口,看
ls -l /data/kb/docs/markdown | wc -l的数量和 sources 配置是否一致。扫到的是空目录,是最常见的一种「跑通了但没有数据」。
AI知识库:最短可用路径
- 起库并开扩展:
docker run -d --name kbpg -e POSTGRES_PASSWORD=**** -p 5432:5432 pgvector/pgvector:pg16,连上后执行CREATE EXTENSION IF NOT EXISTS vector;,看到CREATE EXTENSION即成功。 - 建两张表:documents 存来源,chunks 存片段和向量,doc_id 上做
ON DELETE CASCADE,之后下线文档才干净。 - 先只灌一篇文档:写个最小脚本按 800 字符切、重叠 100,调 embedding 后批量 INSERT。执行完执行
SELECT count(*) FROM chunks WHERE doc_id = 1024;,应该是一个大于 0 的具体数字,不是 0。 - 接检索:接口收问题 → 同模型 embed →
ORDER BY embedding <=> $1 LIMIT 6,把结果拼进提示词的资料段。 - 验证:问一个只有这篇文档里才有的问题,返回体 sources 里应该出现该文档的 path 和对应原句。
CREATE TABLE documents (
  id bigserial PRIMARY KEY,
  path text UNIQUE NOT NULL,
  updated_at timestamptz DEFAULT now()
);

CREATE TABLE chunks (
  id bigserial PRIMARY KEY,
  doc_id bigint REFERENCES documents(id) ON DELETE CASCADE,
  seq int NOT NULL,
  model text NOT NULL,
  content text NOT NULL,
  embedding vector(1024) NOT NULL
);

CREATE INDEX ON chunks USING hnsw (embedding vector_cosine_ops);
AI知识库:一个真实场景的完整做法
场景设定:一个约 40 人的内部 IT 运维团队,知识库对象是 900 篇 Markdown 运维手册(合计约 260 万字符)加 120 份双栏 PDF 变更单(约 1100 页);问答的人是值班人员,问的是「某系统重启流程」「某告警怎么处理」。这个体量单机可以撑住,不必先上分布式向量库。
配置集中在一个文件里,取值如下,文件位置 /opt/kb/config.yaml:
embedding:
  base_url: http://127.0.0.1:8080/v1   # 与 curl 验证时同一个地址
  model: bge-m3
  dim: 1024
  batch: 16
chunk:
  size: 800          # 字符数,不是 token
  overlap: 100
  splitter: markdown # PDF 先用 pdfplumber 按页抽文本,再按页切
store:
  dsn: postgresql://kb@127.0.0.1:5432/kb
  table: chunks
retrieve:
  top_k: 6
  min_score: 0.35    # 低于该值的片段不拼进提示词
sources:
  - /data/kb/docs/markdown
  - /data/kb/docs/pdf
按这个取值跑完,chunks 表落在万级行数,具体数字以 SELECT count(*) FROM chunks; 为准,别拿别人的数字当验收线。min_score 在 retrieve 段,改完要重启入库和查询进程才生效;这个阈值偏低容易答非所问,偏高会让回答频繁说「没找到」,建议先用那 20 个常见问题跑一轮再定。
这个场景最容易踩的坑是 PDF:双栏排版的变更单用默认抽取顺序会串行,左右栏的句子被拼到一起,切出来的 chunk 看着有字,语义是断的。规避方式是抽完先看一眼再入库——SELECT seq, left(content, 120) FROM chunks WHERE doc_id = 1024 ORDER BY seq LIMIT 3;。前三段读起来通顺、能对上 PDF 首页内容,再批量灌剩下的;不通顺就改成按栏坐标切,别指望后面的模型把断句补回来。