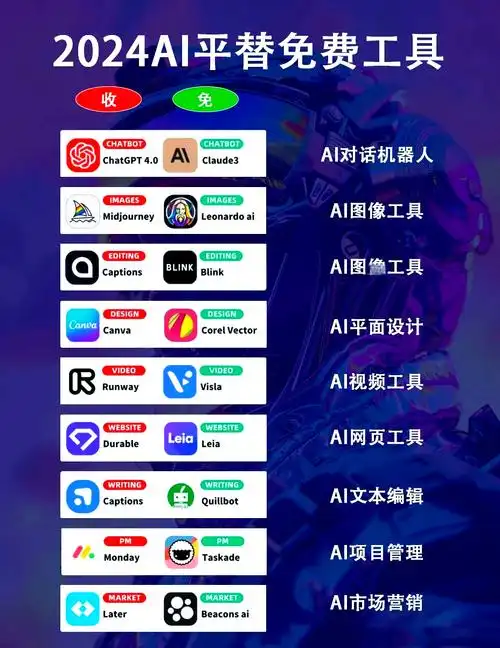
先把候选分成两类再谈推荐:一类是托管式绘图服务,Midjourney、ChatGPT 里内置的 DALL·E、Adobe Firefly,以及国内几家的网页版都属于这一类,注册后直接写提示词;另一类是自托管的模型与工作流,Stable Diffusion WebUI、ComfyUI 加载 SD 系或 Flux 系模型,权重文件和显卡都自己准备。这两类不是同一层级的替代品,所以判断顺序应该是先定「图能不能出本机」和「要不要可复现的种子与工作流」,再谈画质和价格。
判断方向:只做文章配图、封面草图,且能接受订阅或额度计费,托管式服务更省事,把注意力放在授权条款和计费单位上;需要角色与画风一致性、批量出图、参数可复现,或者图不能出内网,就走本地 ComfyUI 或 WebUI 配开源权重。两条路都能用,取舍点是显卡、运维成本和可复现性,不是画质排行榜。价格、额度、限速这类会变的内容,以你打开官方定价页和条款页当时显示为准,别照抄别人的截图。
AI绘图:各自站在什么位置
托管式服务站在「零运维、快速验证想法」这一侧。模型版本由服务方迭代,你不需要管 CUDA、驱动和显存;代价是提示词之外的参数(种子、采样器、ControlNet 这类条件控制)通常只开放一部分,批量与自动化受额度和限速约束。能核对的判断口径是官方定价页上的计费单位,以及商用授权条款所在页面——一般在 Pricing 或 Terms、FAQ 里写明生成内容可用于哪些场景,读的是这一页而非第三方转述。
自托管站在「可控、可复现、可串联」这一侧。同一个种子加同一组参数,在相同模型版本和采样器下能复现出接近的结果,工作流可以存成文件交给同事。能核对的判断口径有两个:模型权重在 Hugging Face 模型卡上的 license、license_name 字段,决定这个模型能不能商用;ComfyUI 或 WebUI 启动日志里打印的显卡型号与显存总量,决定你在什么分辨率下不会爆显存。
AI绘图:性能、成本、运维、上手四个口径分开比
性能:量的是端到端出图耗时,不是主观观感。固定提示词、固定尺寸、固定步数,连续跑五张,用 date +%s%N 记录每张的毫秒数;自托管的还要看生成日志里打印的 it/s 或 s/it。第一张通常含模型加载,明显偏慢,记录时单独标出来,不要算进平均值。
成本:托管式打开服务方 Pricing 页面,先确认计价单位是每张、每积分还是每月额度包,再按自己每月实际张数折算;同时看额度说明里失败重试、放大、高清修复是否额外扣额度。自托管没有单价页面,用 nvidia-smi -q -d POWER 读显卡功耗,按本地电价折成每 GPU 小时成本,再除以这一小时内稳定出的张数,得到的才是可比数字。
运维:托管式看服务状态页和用量说明里的限速条目(rate limit、usage limit 一类),重点是有没有并发上限、超额怎么处理。自托管看驱动与 CUDA 版本是否匹配、模型权重占多少磁盘、启动脚本能不能在重启后复原——这些自己维护,没人替你兜底。
上手:量「从零到第一张图」的实际耗时,并记下步骤数。托管式一般是注册加写提示词两步;自托管是装 Python 环境、装 WebUI 或 ComfyUI、下载权重、配模型路径,中间任何一步版本不对都会卡住。
AI绘图:什么情况选哪一边
只做公众号封面、文章配图、偶尔出几张草图:优先托管式订阅或额度包。前置条件是能接受按月或按量计费,且图片要商用前已经读过该服务的授权条款;如果素材必须留在内网,托管式直接排除。
需要固定角色或统一画风、一次出上百张、要求参数可复现:走本地 ComfyUI 配开源权重。前置条件是有可用的显卡(具体显存要求按模型卡上的推荐值核对,小显存也有能跑的模型,需结合环境确认),并且愿意花时间维护环境。
小团队协作、要留生成记录:自托管加工作流文件入库,把 ComfyUI 导出的 workflow JSON 和权重版本一起提交,出图参数随图存档,后面才能查得回来。
AI绘图:一次能复现的对比做法
十分钟内能做的最小对比是:同一句提示词、同一尺寸,两条路各跑五张,只比耗时和输出规格,不比主观画质。先建目录,再把变量换成你所用服务文档里的实际值(字段名以该服务 API 文档为准):
mkdir -p bench/api bench/local
export BASE_URL="https://your-endpoint/v1"
export API_KEY="sk-xxxx"
export MODEL="your-image-model"
PROMPT="a ceramic mug on a wooden table, soft window light"
for i in 1 2 3 4 5; do
  start=$(date +%s%N)
  curl -s -o "bench/api/$i.png" -X POST "$BASE_URL/images/generations" \
    -H "Authorization: Bearer $API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"model\":\"$MODEL\",\"prompt\":\"$PROMPT\",\"size\":\"1024x1024\",\"n\":1}"
  end=$(date +%s%N)
  echo "$i $(( (end-start)/1000000 ))" >> bench/api/time.log
done
cat bench/api/time.log
本地这一侧,WebUI 启动时加 --api 参数,默认监听 127.0.0.1:7860,沿用同一句提示词和同一尺寸:
for i in 1 2 3 4 5; do
  start=$(date +%s%N)
  curl -s -o "bench/local/$i.png" -X POST http://127.0.0.1:7860/sdapi/v1/txt2img \
    -H "Content-Type: application/json" \
    -d '{"prompt":"a ceramic mug on a wooden table, soft window light","width":1024,"height":1024,"steps":25,"seed":12345,"batch_size":1}'
  end=$(date +%s%N)
  echo "$i $(( (end-start)/1000000 ))" >> bench/local/time.log
done
最后汇总输出规格,耗时日志直接 cat 出来对照:
pip install pillow
python3 - <<'PY'
from pathlib import Path
from PIL import Image
for d in ("bench/api", "bench/local"):
    for p in sorted(Path(d).glob("*.png")):
        with Image.open(p) as im:
            print(d, p.name, im.size, p.stat().st_size // 1024, "KB")
PY
预期差异主要落在三处:本地第一张明显慢于后续几张,托管式五张之间比较接近;托管服务返回的尺寸不一定严格等于请求的 1024,脚本输出的 im.size 能直接看出来;文件体积只反映压缩和细节密度,不能当画质分数。
这里有一个容易踩的坑:把同一个种子当成跨工具比较的依据。种子只在同一模型、同一采样器、同一版本下保证复现,换到另一个工具,相同的 seed 数值生成的完全是另一张图。想比画质,正确做法是固定提示词和尺寸、每个工具多抽几张、遮掉来源做盲评,而不是对齐 seed 数值下结论。