搜这个对比的人,多半不是要读两篇产品介绍,而是手上有台新机器、新集群要决定装哪个,或者两边都已经在用,需要把边界划清楚。先给一个可操作的方向:Zabbix 的组织中心是「主机与设备清单 + 触发器告警」,Prometheus 的组织中心是「带标签的时序样本 + 查询语言」。想验证这句话,不用看评测文章,各起一个最小实例抓同一个指标,看两边输出长什么样,十分钟就能有手感,具体做法放在第四节。
如果监控对象以物理机、虚拟机、网络设备、Windows 主机为主,团队希望开箱模板加界面化告警,Zabbix 更顺手,前提是能接受关系库的容量与清理维护。如果对象是容器和微服务,实例频繁增删,已经有 /metrics 端点,或者查询要靠 label 切片聚合,Prometheus 更贴合,前提是接受用 YAML 和 PromQL 描述规则,并为长期数据另配远端存储。两者并存也常见,但要把告警归属划清楚,避免同一个故障被两套系统各报一次。
Zabbix和Prometheus:各自站在什么位置
Zabbix 的模型是 host → item → trigger → action。采集侧支持 agent、SNMP、IPMI、JMX、简单检查等多种方式,指标落到 MySQL 或 PostgreSQL,history 与 trends 分开存放,趋势数据做降采样。要核对它的能力边界,建议看两处:一是 zabbix_server.conf 里 StartPollers、StartPreprocessors、CacheSize、ValueCacheSize 这几个参数的含义,官方文档的 server 配置参数章节逐条有解释,参数名本身就能说明采集和预处理是分开调度的;二是 Web 界面 Reports → System information 里的 "Required server performance, new values per second",这个数值就是采集压力的量纲,加机器前先看它。
Prometheus 的模型是 target → scrape → 样本(metric name + labels + 时间戳 + 值)。它没有「主机」这个一等概念,只有 target 和 label。判断口径同样有两处:prometheus.yml 里的 scrape_configs 决定抓谁、scrape_interval 决定多久抓一次;启动参数 --storage.tsdb.retention.time 决定本地 TSDB 保留多久,官方文档的 Configuration 和 Storage 两节可以逐项核对。版本号和默认值会随发布变化,用之前去对应版本的文档页确认,不要照抄别处的参数值。
Zabbix和Prometheus:性能、成本、运维、上手四个口径分开比
性能:Zabbix 侧的量纲是每秒新建值数,看 Reports → System information 的 NVPS 和 value cache 使用情况;临时验证可以手工拉一次,比较返回耗时。Prometheus 侧直接在表达式里量,抓取压力看 rate(prometheus_tsdb_head_samples_appended_total[5m]),序列数量看 prometheus_tsdb_head_series,抓取耗时看 scrape_duration_seconds。这两个数决定 Prometheus 需不需要拆分片或调抓取间隔,比「哪个更快」这种笼统问法有用。
成本:Zabbix 的成本主要压在数据库。先在库里量一下:SELECT table_name, ROUND(data_length/1024/1024) AS mb FROM information_schema.tables WHERE table_schema='zabbix' ORDER BY data_length DESC LIMIT 5; 再看 history 与 trends 的保留天数配置。Prometheus 侧用 du -sh /var/lib/prometheus 观察每日增长,长期保存需要 remote_write 到对象存储或时序服务,单价去对应云厂商的对象存储计价页确认,不要把别人文章里的数字当基准。
运维:Zabbix 是多组件形态(server、Web 前端、数据库、agent),备份等于数据库备份加配置文件,升级要走数据库变更流程。Prometheus 是单二进制加 YAML,改完配置执行 curl -X POST http://127.0.0.1:9090/-/reload(启动时需带 --web.enable-lifecycle),但告警规则要交给 Alertmanager,多一个组件要维护。告警入口也不同:Zabbix 在 Web 上点触发器,Prometheus 写 rule 文件。
上手:Zabbix 的概念包袱在模板、主机宏、item key,理解一次就能复用;Prometheus 的门槛主要在 label 设计和 PromQL,写错聚合维度是新手最常见的卡点。评估时让实际值班的人各写一条告警规则,比看文档更快得出结论。
Zabbix和Prometheus:什么情况选哪一边
先按顺序过一遍清单,清单走完再落到具体场景:
- 数目标:监控对象是否以物理机、虚拟机、网络设备、中间件为主,能否用现成模板覆盖。
- 看目标是否动态:容器和实例是否频繁增删,服务是否已经暴露 /metrics 端点。
- 看查询需求:是否需要按 label 任意切片聚合,现有 Grafana 面板是否依赖 PromQL。
- 看保留期:数据是否需要留存数月以上,是否需要跨环境汇总查询。
- 看人:团队里谁愿意维护 YAML 和规则文件,谁更习惯界面操作。
选 Zabbix:监控对象以 IDC 主机、交换机、存储、Windows 服务器为主,采集靠 SNMP 和 agent,团队需要开箱模板和界面化告警配置。前置条件是数据库容量和清理策略有人负责,且新增监控对象数量可预期。若指标基数已经很大,先确认 history 保留天数,再决定是否继续往上堆。
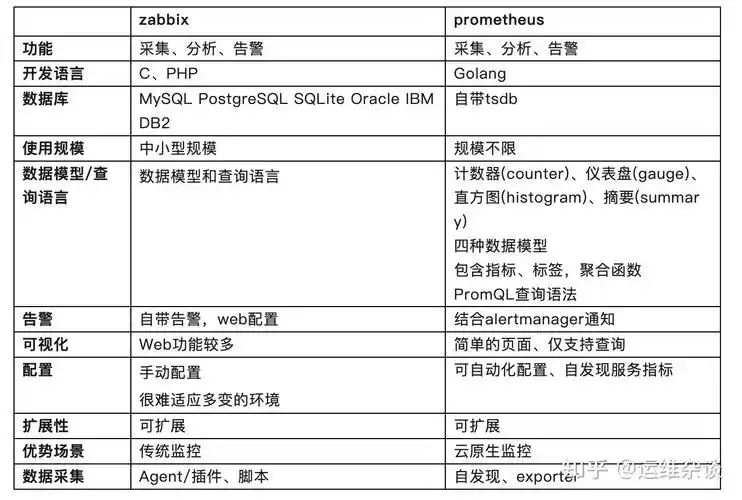
选 Prometheus:目标是 Kubernetes 里的 Pod、服务网格、自建中间件,实例随发布滚动,需要按 namespace、service 等标签聚合看板。前置条件是这些服务能提供 /metrics 或有对应 exporter,且团队接受规则以文件形式版本化管理。数据要长期保留时,一开始就把远端存储规划进去。
两者并存:已经有一套 Zabbix 不想推翻,只想补容器侧观测,可以先把 Prometheus 限定在集群内,Grafana 做统一展示。前置条件是把告警归属写清楚:同一类故障只允许一套系统发通知,否则值班时会被重复消息淹没。
Zabbix和Prometheus:一次能复现的对比做法
十分钟内跑完的做法是抓同一个指标,比较两边的输出结构。先起一个 node_exporter 暴露指标:
docker run -d --name node-exporter -p 9100:9100 prom/node-exporter
curl -s http://127.0.0.1:9100/metrics | grep -E '^node_load1|^node_cpu_seconds_total' | head -5
再起一个最小 Prometheus,配置放在 /tmp/prom/prometheus.yml:
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['127.0.0.1:9100']
docker run -d --name prom -p 9090:9090 \
-v /tmp/prom/prometheus.yml:/etc/prometheus/prometheus.yml \
prom/prometheus --config.file=/etc/prometheus/prometheus.yml
sleep 30
curl -s 'http://127.0.0.1:9090/api/v1/query?query=node_load1'Zabbix 侧对同一台机器执行一次取值,装好 agent 后:
zabbix_get -s 127.0.0.1 -k system.cpu.load[all,avg1]预期差异在输出形态:Prometheus 的 API 返回 JSON,值旁边带 instance、job 等标签,同一个指标可以按标签自由聚合,但目标下线后序列会停止更新,靠 up 或 absent_over_time 才能判断缺失;zabbix_get 返回一个纯文本数值,语义完全由 key 和 item 定义,采集失败时 item 会转为 unsupported,状态本身就能触发告警。差别就在这里:一边把语义放在查询里,一边把语义放在采集定义里。
最容易踩的坑是 Prometheus 的标签基数。别把用户 ID、完整 URL、请求参数这类高基数字段做成 label,一旦 head series 涨上去,内存和查询都会跟着难受,事后清理比事前设计麻烦得多。动手前先用 prometheus_tsdb_head_series 记一个基线,改完再对一次。