搭 AI 工作流卡住的通常不是模型选型,而是三件事没先确认:运行环境版本对不对、调用凭据有没有对应权限、入口在控制台的哪个位置。这三件事没落地就开始写编排代码,时间大多会花在处理 401、429 和读不到配置上。下面按真实排查顺序给一条能跑通的最短路径,再给一个具体场景的配置取值和三个高频卡点的定位方法。
适合第一次把模型调用串成自动流程的人:先在命令行和控制台确认版本、凭据权限、入口位置三项,再用一个最小脚本打通「读输入—调模型—校验输出—落盘」,最后才加并发和重试。验证方式是用少量样本跑通全链路并人工核对其中几条输出;边界是模型名、限速、额度这类信息会变,取值一律以你控制台当前页面显示为准,不要照抄别人的数字。
AI工作流之前先确认这三件事
这三项缺任何一项,后面都会以“报错但看不出原因”的形式卡住。每项都给了在哪里看。
一、运行环境版本。工作流脚本、SDK 和模型名之间有版本对应关系,版本过旧时常见表现是参数被静默忽略或直接抛 unexpected keyword argument。查看位置:
python -V
pip show openai | head -5
python -c "import sys; print(sys.executable)"
记录下 Python 版本号、SDK 版本号和解释器绝对路径。如果 sys.executable 指向的不是你建虚拟环境的目录,说明命令跑在了系统环境里,这一条要先修。
二、凭据权限。凭据分个人 key 和项目 key,权限范围不同,能不能调用某个模型、能不能读写文件,都在控制台的 key 详情页里看(一般叫 Permissions、Scopes 或“项目权限”)。光看页面不够,用一次最小请求确认:
curl -s -o /dev/null -w "%{http_code}\n" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  $BASE_URL/models
返回 200 说明凭据和网络路径都通,返回 401 是凭据本身的问题,返回 403 多为权限范围不足,返回域名解析错误则和凭据无关。
三、入口位置。入口包括两层:控制台里在哪个菜单创建或查看模型端点(通常在“模型”“API”“项目”这类页面,页面上会显示模型标识和版本号);脚本这一侧读的是哪个配置文件。后者用一条命令确认:
python -c "import os; print(os.getcwd())"
cat .env
模型标识、版本号、调用地址以控制台页面字段为准,页面改版后字段名会变,所以不要把标识硬编码在脚本里,放到配置文件里,改版时只改一处。
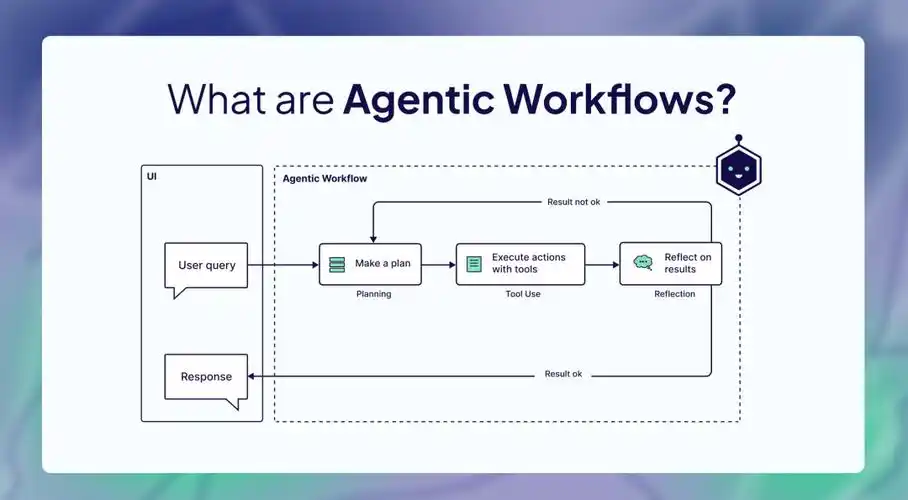
AI工作流:最短可用路径
先不碰并发和重试,用四步把一条链路跑通,每一步都写了做完该看到什么。
第一步:建目录和隔离环境。
mkdir -p ai-flow && cd ai-flow
python -m venv .venv
source .venv/bin/activate
pip install -U openai
做完后 which python 应指向 ai-flow/.venv/bin/python,命令行前缀出现 (.venv)。
第二步:把凭据和模型标识写进配置文件。新建 .env:
API_KEY=替换成你的key
BASE_URL=替换成控制台显示的调用地址
MODEL=替换成控制台显示的模型标识
三个值都从控制台页面复制,复制后检查有没有首尾空格和中文引号。文件权限建议收紧:
chmod 600 .env第三步:写一个最小脚本,只做输入校验、调用、输出校验、落盘。保存为 run.py:
import json, os, sys
from openai import OpenAI
import openai

client = OpenAI(api_key=os.environ["API_KEY"], base_url=os.environ["BASE_URL"])
model = os.environ["MODEL"]

def run_one(text):
    resp = client.chat.completions.create(
        model=model,
        temperature=0,
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "你是分类器。只输出 JSON,字段为 category、urgency、summary,不要输出其他内容。"},
            {"role": "user", "content": text},
        ],
    )
    if resp.choices[0].finish_reason != "stop":
        raise RuntimeError(f"输出被截断: {resp.choices[0].finish_reason}")
    data = json.loads(resp.choices[0].message.content)
    for k in ("category", "urgency", "summary"):
        if k not in data:
            raise ValueError(f"缺少字段 {k}")
    return data

if __name__ == "__main__":
    with open("in.jsonl", encoding="utf-8") as f, open("out.jsonl", "w", encoding="utf-8") as g:
        for line in f:
            row = json.loads(line)
            g.write(json.dumps({"id": row["ticket_id"], **run_one(row["content"])}, ensure_ascii=False) + "\n")
    print("done")
如果 SDK 版本较旧不支持 response_format,会直接报参数错误,这时把这一行删掉,改为在提示词里明确“只输出 JSON,不要加代码块围栏”,后面的解析逻辑不变。
第四步:用几条样本跑通。先准备 5 条 in.jsonl,每行一个对象,然后:
set -a && source .env && set +a
python run.py
wc -l out.jsonl
该看到:终端打印 done,out.jsonl 行数与输入行数一致,随便打开几行能看到三个字段都有值。行数对不上说明中途抛异常被吞掉了;字段缺失说明提示词约束不够,先改提示词再看解析代码。
AI工作流:一个真实场景的完整做法
场景:电商客服每天约 2000 条用户工单,来源是工单系统的 JSONL 导出,单条正文字数多在 100 到 400 字之间,需要产出工单类别、紧急程度和一句摘要,供第二天早班人工分派。
输入字段固定在 in.jsonl,每行形如:
{"ticket_id": "T20240512001", "channel": "app", "created_at": "2024-05-12T09:14:00+08:00", "content": "下单三天还没发货,客服电话打不通……"}运行参数单独放 workflow.yaml,和代码分开放,换环境只改这个文件:
input: in.jsonl
output: out.jsonl
error_output: failed.jsonl
model: 填控制台页面显示的模型标识
batch_size: 10          # 每批处理条数,先小后大
max_concurrency: 2      # 并发请求数,按控制台用量页调整
request_timeout: 60     # 单次请求超时秒数
max_retries: 2          # 只对超时和 429 重试
categories:
  - 物流
error_rate_alert: 0.05  # 失败比例超过此值时停止,不继续跑
落地要点有四个。第一,逐条处理而不是一次塞进一个长请求,单条失败只丢一条,写进 failed.jsonl 而不是让整批崩掉。第二,max_concurrency 先设 2,观察控制台用量页里的限速和额度状态,再往上加,一次加到 10 容易直接撞限速。第三,重试只覆盖超时和 429,格式错误重试没用,要回头改提示词。第四,跑之前先用 20 条做抽样,人工核对几条输出,确认类别词表对得上再全量。
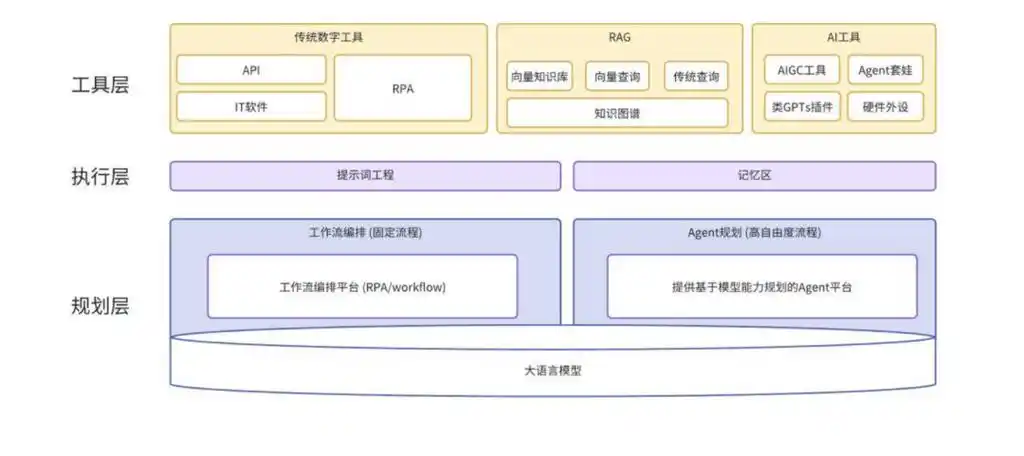
2000 条这个量级不需要复杂编排,一个脚本加一个配置文件就够;真正需要引入任务队列的时机,是单次要处理的数据量导致单进程跑不完、或者需要断点续跑的时候。
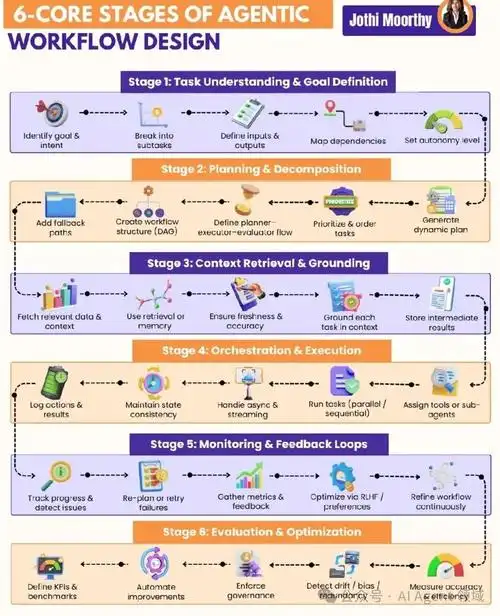
AI工作流:跑不通先查这三处
按出现频率从高到低排,每条都写了报错原文特征和检查位置。
第一处:凭据没加载或格式不对。报错常见为 401 Unauthorized、AuthenticationError、页面提示 invalid api key。检查位置:脚本是否在读取 .env 之前就取了环境变量(KeyError: 'API_KEY' 属于这一类,不是 key 无效);.env 里等号两边有没有空格、值有没有被引号包住;控制台 key 详情页里这个 key 是否显示为停用或已过期。
第二处:撞限速或额度。报错常见为 429 Too Many Requests、RateLimitError,或提示 quota exceeded。检查位置:先把 max_concurrency 降到 1 重跑一次,能过就是并发问题;仍报 429 则去控制台用量页看当前额度是否用尽,以及该模型在页面标注的限速单位(按请求数还是按 token 数)。这两类报错处理方式不同,一个是降并发,一个是额度或限速策略问题。
第三处:输出不是合法 JSON。报错为 json.decoder.JSONDecodeError,或者自定义的 缺少字段 category。检查位置:先打印原始返回内容看有没有 json 围栏;再看 finish_reason 是否为 length,为 length 说明输出被截断,调大输出长度上限或缩短摘要要求;都不是的话,把提示词里“只输出 JSON”这一句往前放,并给出一个字段示例。
另外,请求超时和上面三条不同:超时表现为 APITimeoutError 或连接重置,先看 request_timeout 是否对小模型请求设得过短,再看网络出口是否稳定。这类问题建议在重试逻辑里覆盖,而不是每次手工重跑。