搜「MySQL和MongoDB的区别」,真正要解决的问题,是先把“关系型 vs 文档型”这层标签放一放,判断手上这套业务该落在哪一边,以及现有实例当前实际是什么形态。可以先按三步核对:确认版本与部署形态 → 确认鉴权和暴露面 → 用同一份数据、同一类查询各量一次。下面的命令能直接执行;输出对不上再往下查,对得上就可以直接做选择。
适用场景:新项目选型、老系统迁移前评估、方案评审自查。操作动作:先跑版本与部署形态检查,再跑鉴权检查,最后用 EXPLAIN 与 explain 对同一份数据各测一次。验证方式:MySQL 看 SHOW ENGINES 里 InnoDB 行的 Transactions 列和 EXPLAIN 的扫描行数;MongoDB 看 rs.status() 是否返回副本集、explain('executionStats') 的 docsExamined。风险边界:多文档事务、默认鉴权状态都跟版本和部署方式绑定,结论以本机输出为准。
MongoDB和MySQL的区别与优缺点
这一步对应“先确认你手里的是哪种部署形态”。优点和缺点几乎全部跟版本、存储引擎、是否副本集绑定在一起;脱离这些讲优缺点,很容易说错。可核对的位置如下,在能连上实例的机器上执行:
# MySQL:版本、默认引擎、隔离级别、账号鉴权插件
mysql -uroot -p -e "SELECT VERSION(), @@default_storage_engine, @@transaction_isolation; SHOW ENGINES;"

# MongoDB:版本、是否副本集、启动配置来源
mongosh --quiet --eval 'printjson({version: db.version(), rs: (()=>{try{return rs.status().set}catch(e){return "not-replica-set"}})()})'
mongosh --quiet --eval 'printjson(db.adminCommand({getCmdLineOpts:1}).parsed)'
MySQL 输出里 @@default_storage_engine 为 InnoDB、SHOW ENGINES 中 InnoDB 行的 Transactions 列为 YES,才说明多语句事务这项能力在你这台实例上成立。MongoDB 的 rs.status() 如果直接抛错,说明是单机部署,多文档事务的前提就不具备——这是能用命令确认的分界线,不用争论。
优缺点按可核对的事实说:MySQL 的长处是显式 schema、约束、JOIN 和多表事务,代价是字段调整要改表结构、上线要走变更;MongoDB 的长处是文档内聚、字段可变、写入路径短,代价是跨集合一致性要由应用层或事务兜底,关联查询往往要应用侧拼装。
MongoDB和MySQL的区别与安全性
这一步对应“确认鉴权开没开、账号权限粒度、网络暴露面”。两个库的默认姿态不同:MySQL 安装时一般就要求设置 root 密码并写入 mysql.user;MongoDB 通常需要在配置里显式打开鉴权,否则连上去的会话就是无认证状态。
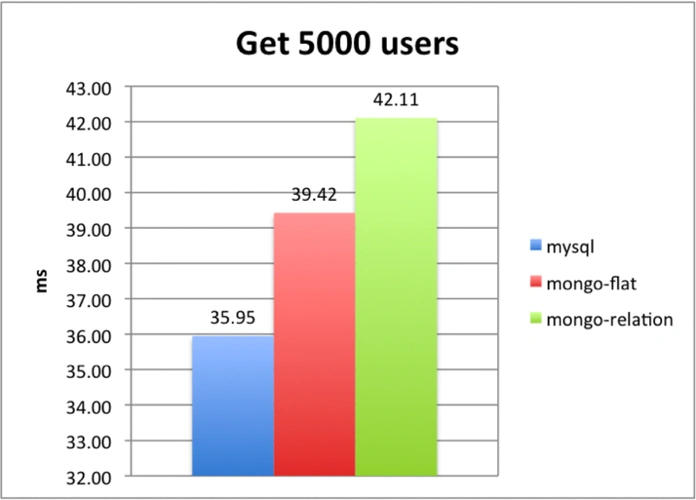
核对位置:MySQL 用 SELECT user,host,plugin FROM mysql.user; 看认证插件与允许的来源主机,用 SHOW GRANTS FOR 'app'@'%'; 看权限是否过宽,配置文件 /etc/mysql/my.cnf 里的 bind-address 控制监听地址。MongoDB 用 db.adminCommand({getCmdLineOpts:1}).parsed.security.authorization 看是否为 enabled,用 db.runCommand({connectionStatus:1}) 看 authenticatedUsers 是否为空,用 db.getUsers() 看角色分配。
容易踩的坑:把 MongoDB 配置里的 net.bindIp 改成 0.0.0.0 便于外部连,却没有同时打开 security.authorization,等于把一个无认证的数据库端口暴露出去;反过来,开了鉴权但应用连接串没写 authSource,认证会落到默认库上而失败,很容易被误判成“权限配错了”,实际是连接参数问题。改完配置用上面两条命令复查一遍再放流量。
MySQL和MongoDB:各自站在什么位置
MySQL 站在“结构先定、一致性优先”的位置:账务、订单、库存这类需要跨表事务和唯一约束的数据,把它放进来最省心。可核对的判断口径是官方文档的 InnoDB 与 Transactions 章节,以及实例上的参数 transaction_isolation、innodb_buffer_pool_size,这两个值决定了你的事务语义和内存预算。
MongoDB 站在“结构随内容走、单文档读写为主”的位置:内容、日志、配置、字段经常变的对象数据,用文档模型可以少改表结构。可核对的判断口径是官方文档的 Replication 与 Sharding 章节,以及 db.serverStatus().wiredTiger 和 db.getCollectionInfos() 返回的校验规则。
要比性能时,别比单次耗时,比扫描量:MySQL 用 EXPLAIN(或 EXPLAIN ANALYZE,版本相关,用 SELECT VERSION() 先确认支持不支持)看 rows;MongoDB 用 db.coll.find({...}).explain('executionStats') 看 docsExamined 与 keysExamined。两边喂同一份数据、同一类过滤条件,结论才有意义。
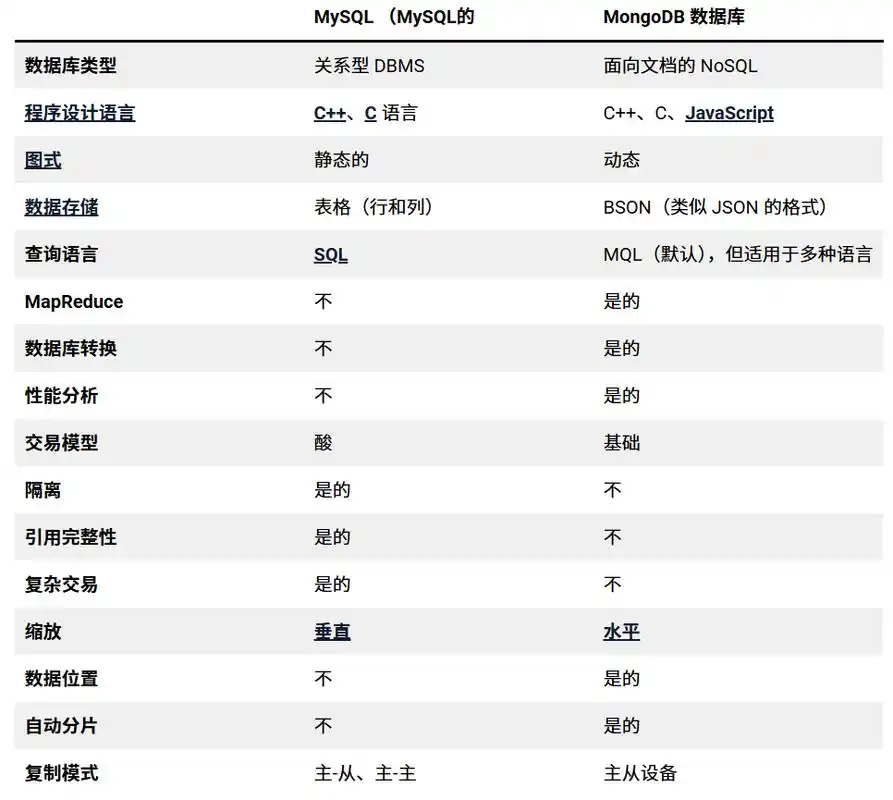
MySQL和MongoDB:性能、成本、运维、上手四个口径分开比
性能:量的是扫描量和索引命中,不是印象。MySQL 看 EXPLAIN 的 type 与 rows,慢查询日志 slow_query_log 打开后看 long_query_time 之外的 SQL;MongoDB 打开 db.setProfilingLevel(2),查 db.system.profile 的 docsExamined。两边都以“扫描量是否随数据量线性涨”作为判断依据。
成本:量的是实例规格对应的账单,而不是感觉贵不贵。在云厂商的 RDS 规格与计价页、MongoDB 托管服务的集群规格与计价页上,按同样的 CPU/内存/存储档位取价对比,注意副本集和只读实例会成倍放大节点数。价格和规格会变,签约前以当时的计价页面为准。
运维:量的是备份恢复和故障切换的步骤数。MySQL 侧 mysqldump 或物理备份、主从复制状态用 SHOW REPLICA STATUS 看;MongoDB 侧 mongodump、副本集状态用 rs.status() 看。哪个团队能独立把恢复演练跑通,就优先哪一边。
上手:量的是从建表到上线要写多少非业务代码。MySQL 侧是 DDL 变更流程;MongoDB 侧是文档结构约定和校验规则(db.createCollection 时的 validator),没有 schema 不等于不用设计结构,只是把约束前移到应用层。
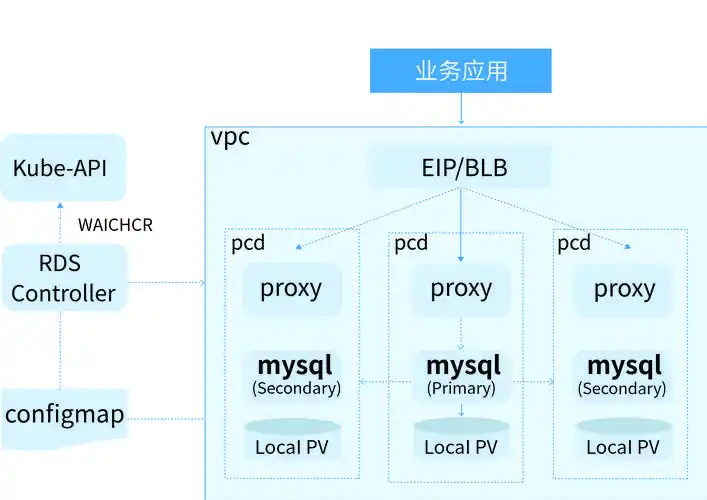
MySQL和MongoDB:什么情况选哪一边
判断顺序建议按这张清单走:
- 数据之间是否存在必须由数据库保证的多表一致性?是则先看 MySQL。
- 单条记录结构是否频繁增删字段、且很少跨集合关联?是则先看 MongoDB。
- 是否已有可复用的备份恢复与监控体系?偏向沿用已有栈,减少运维面。
- 多文档事务是否必需?需要时先确认 MongoDB 是副本集部署,
rs.status()能正常返回。 - 最后才做性能对比,用同一份数据和 EXPLAIN/explain 各测一次。
场景一:订单、账务、库存、需要跨表统计的报表,选 MySQL。前置条件是事务和唯一约束必须在库内生效;验证方式是对关键 SQL 跑 EXPLAIN 确认走索引。
场景二:内容管理、设备上报、字段形态经常变化的对象数据,且查询以单文档或单集合为主,选 MongoDB。前置条件是团队能接受把结构校验写在应用层或 validator 里;验证方式是检查 db.getCollectionInfos() 里的校验规则是否覆盖关键字段。
场景三:已有 MySQL 团队和托管实例,新需求只是字段灵活,可以先在 MySQL 里用 JSON 列过渡,等字段变动和读写模式都稳定了再评估是否拆分,避免为了灵活性提前引入第二套运维体系。