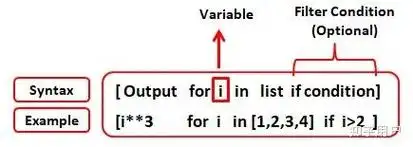
列表推导式和生成器表达式在写法上只差一对括号,运行行为却不一样:列表推导式一创建就会把所有元素算出来,放进内存,得到一个 list;生成器表达式只返回一个迭代器,元素要等到被 next、for、sum 这些操作真正取用时才逐个计算。判断时先看两个问题:这份结果你需要反复遍历、取长度、按下标访问吗?数据量或数据来源会不会大到不适合一次性放进内存?需要前者通常是 list,只需要一次遍历通常是生成器。
判断方向:结果只被消费一次、数据量大或来自逐行读取的流,用生成器表达式;需要 len、下标、切片、多次遍历,或者要交给只接受序列的接口,用列表推导式。操作上可以先写成列表推导式把逻辑跑通,再按下游需求换成圆括号。验证看 type() 结果、能否 len()、以及迭代前后副作用函数是否被执行。边界是生成器只能消费一次,耗尽后再遍历是空的,异常也会推迟到迭代时才抛出。
先确认当前场景和目标
这段代码要解决的问题决定了选哪种写法。先确认下面几项,再动手改,避免写完才发现下游用不了。
- 下游要什么:如果后续要做
len(items)、items[0]、items[::-1]、if x in items多次判断或多次 for 循环,需要的是序列,列表推导式更合适。 - 消费次数:结果只被遍历一遍(求和、过滤后写文件、传给
any/max/join),生成器表达式就够。 - 数据规模与来源:元素数量可控、全部放进内存没问题,用列表;数据来自逐行读文件、分页接口、日志流,用生成器更自然。
- 表达式里有没有副作用:如果推导式内部调用了函数、打了日志、发了请求,列表会在创建时一次性执行完,生成器会把执行推迟到迭代时,位置和时机都不同。
- 调试需求:想直接 print 看到内容、在报错时查看中间结果,列表更省事。
这几项确认完,通常就能判断方向。拿不准时先按列表推导式写,它是更容易观察和验证的那一侧。
按这个顺序处理
按下面顺序判断原代码该用哪种写法,每一步都能单独停下来验证(这里原写作“改造”,改为更通顺的说法)。
- 先用列表推导式把过滤和转换逻辑写对,用一段小样本跑通,确认结果符合预期。
- 检查下游用法:出现
len()、下标、切片、多次 for,就保留列表;只出现一次遍历,进入下一步。 - 把方括号换成圆括号,得到生成器表达式。作为函数唯一参数时括号可以省略,例如
sum(x * x for x in nums)。 - 需要多个消费方或需要重复遍历时,不要共享同一个生成器对象,要么改回列表,要么每次重新创建生成器表达式。
- 需要限量取用时配合
itertools.islice,避免无谓地把全部元素算完。
nums = range(5)

lst = [x * x for x in nums]        # list,立即求值
gen = (x * x for x in nums)        # generator,惰性求值

print(type(lst))     # list
print(type(gen))     # generator
print(lst[2])        # 4
print(sum(gen))      # 30,第一次遍历正常
print(sum(gen))      # 0,生成器已耗尽
逐行处理大文件的场景,生成器表达式写法更贴合输入形态:
with open("access.log", encoding="utf-8") as f:
    lines = (ln.strip() for ln in f if ln.strip())
    for line in lines:
        handle(line)
这里 lines 只被消费一次,内存中不会堆积全部行;但如果下面还要再遍历一遍 lines,就必须重新生成,或者先 list(lines) 转成列表。
改完后怎么验证
改完不要只看代码形状,用下面几个动作确认行为已经切换过去。
- 看类型:
type(obj)分别得到list和generator,这是最直接的信号。 - 试探接口:对生成器调用
len()或取下标会抛TypeError,说明它确实不再是序列;对列表则能正常返回。 - 比对结果:小样本下把生成器
list()一次,和原列表推导式的输出逐项比较,确认过滤条件、转换逻辑没有在改动中丢失。 - 观察求值时机:在表达式里放一个记录调用的函数,看它是在创建时被调用,还是在迭代时才被调用。
calls = []
def track(x):
    calls.append(x)
    return x * 2

gen = (track(x) for x in range(3))
print(calls)      # [],创建时未求值
list(gen)
print(calls)      # [0, 1, 2],迭代后才执行
预期信号是:创建生成器表达式后副作用没有发生,遍历一次后每个元素恰好被执行一次,第二次遍历没有任何新调用。如果第二次遍历还需要拿到数据,说明这里不该用生成器。
容易忽略的边界
- 一次性消费:生成器耗尽后是空的,把它存成变量反复传给不同函数是最常见的出错方式。回退做法是重新构造生成器表达式,或者改成列表。
- 物化成本:
list(gen)、sorted(gen)、sum(gen)中的排序和转换仍会拉取全部元素,省内存的收益在这些调用面前会打折扣,需要结合数据量确认。 - 异常时机:生成器体内的错误在迭代时才抛出,错误栈指向消费位置而不是定义位置,排查时要先找到真正触发的遍历语句。
- 作用域与延迟绑定:生成器表达式在迭代时才读取外部变量,如果循环变量在迭代前被改过,取到的是改后的值;列表推导式立即求值不会遇到这个问题。
- 共享消费:同一个生成器对象在多处或多线程中消费时,元素会被抢走,结果不可预期。建议每处独立创建,或先转成列表再共享;转换的代价要提前评估。
- 调试与日志:生成器内容无法直接打印查看,排查阶段临时转成列表更省时间,交付前再决定是否保留惰性写法。