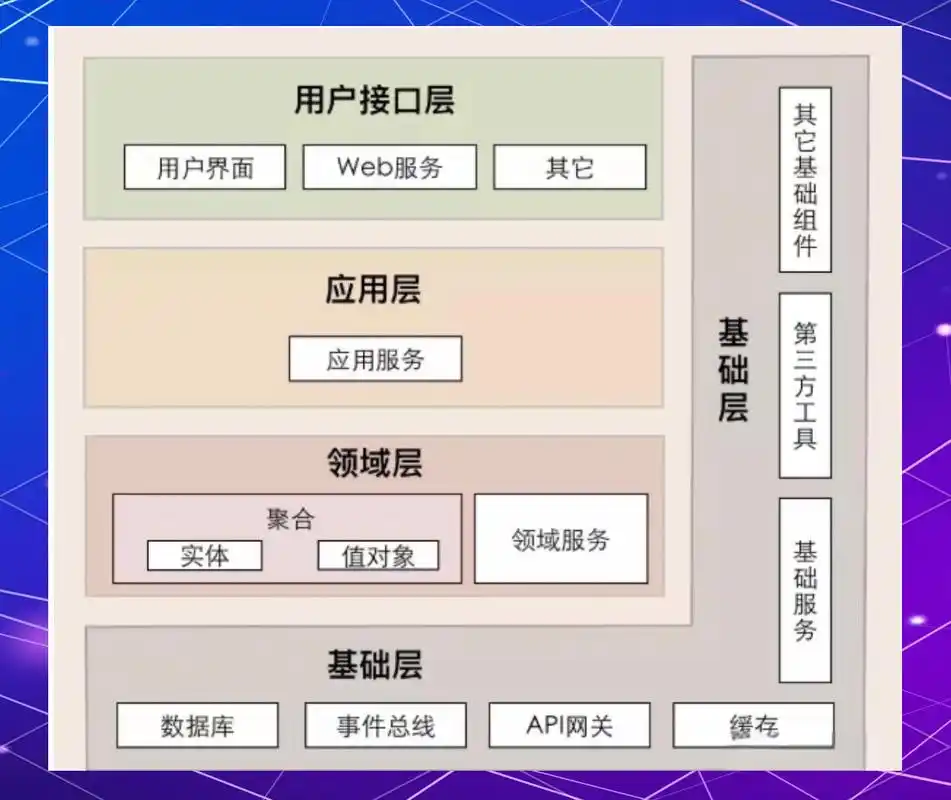
DDD 的限界上下文和微服务的拆分边界通常不能做到一一对应,也不需要强求一一对应。更可靠的做法是:先用限界上下文识别业务边界和语言边界,再把“需要独立变化、独立伸缩、独立故障隔离”的部分拆成服务,其余部分先留在同一个部署单元里。判断顺序应当是业务能力→一致性边界→团队与变更节奏→运行约束,而不是直接从表结构或接口数量推服务数量。
对齐的核心不是让领域模型和服务清单长得一样,而是让每个服务内部拥有完整的领域语言和一致的数据所有权。适用场景:已有初步领域模型、准备落地服务拆分。操作动作:按限界上下文画上下文映射,标出聚合根、事务边界和跨上下文调用,再决定哪些上下文独立部署。验证方式:检查跨服务调用是否只发生在上下文之间、是否出现跨库事务。风险边界:团队规模小、业务仍在探索期时,过早拆细服务会放大分布式复杂度。
先确认当前场景和目标
先确认问题是否真的成立。如果当前只有一个团队维护一个单体应用,业务规则还在频繁变动,那么“领域边界和服务边界对齐”更多是设计层面的梳理,不必立刻变成部署层面的拆分。相反,如果已经出现多个团队改同一份代码互相阻塞、不同模块的发布节奏差异明显、或者某块业务需要独立扩容,那么边界对齐就有了实际收益。
动手前建议先确认几项信息,这些信息决定后面拆到什么颗粒度:
- 业务能力清单:能否用一句话说清每个子域提供什么价值,以及谁在使用。
- 语言差异:同一个词在不同子域是否含义不同,比如“订单”在交易和售后里的字段与状态机是否一致。
- 一致性要求:哪些操作必须在一个事务里完成,哪些可以最终一致。
- 团队结构:每个候选边界能否由一个团队完整负责,包括数据、接口和运维。
- 运行约束:是否有独立的伸缩、部署、权限或合规要求。
一个常见的判断条件是:如果两个模块共享同一套领域概念、同一批数据、同一个变更负责人,那它们更适合放在同一个服务里;如果它们各自有独立的语言、独立的数据所有权和独立的发布节奏,才值得考虑拆成两个服务。
按这个顺序处理
第一步是识别限界上下文,而不是先画服务。可以先按业务能力和语言一致性划出候选上下文,再对照上下文映射关系做一次整理。以下是一个可直接套用的记录骨架,用来把领域信息落到可判断的字段上:
上下文名称:交易上下文
核心职责:下单、支付发起、订单状态流转
聚合根:Order
事务边界:创建订单 + 扣减库存预占 在一个本地事务内
对外暴露:下单接口、订单查询接口
依赖的上下文:库存上下文(预占)、支付上下文(发起支付)
数据所有权:订单表仅本上下文写入
变更频率:高
负责团队:交易组
第二步是判断聚合与事务边界。聚合根所在的范围通常应该在一个服务内完成写入,跨聚合的操作优先用领域事件或应用层编排,而不是把两个聚合放进同一个跨服务事务。遇到必须强一致的场景,先检查是不是聚合划错了,而不是急着上分布式事务。
第三步是对照拆分动因。逐个上下文问四个问题:是否需要独立部署、是否需要独立伸缩、是否需要独立故障隔离、是否由不同团队负责。四个问题都答“否”的上下文,可以先合并部署;答“是”的再拆出去。这样做能避免为了形式上的对齐而制造大量细粒度服务。
第四步是确定集成方式。上下文之间建议只通过明确的接口或事件通信,禁止直接读对方数据库。跨上下文查询如果需要组合数据,可以用接口聚合或读模型,而不是让一个服务直连另一个服务的库表。下面是接口契约的校验骨架,用来确认边界是否被穿透:
// 伪代码:跨上下文调用应只走显式契约
POST /inventory/reservations
{ "orderId": "...", "skuId": "...", "quantity": 1 }

// 反例:在交易服务中直接执行库存库的 SQL
// select available from inventory_db.stock where sku_id = ?
第五步是回看团队与交付节奏。服务边界最终要落到人身上,如果一个候选服务找不到明确的负责人,通常说明它的边界还不够清晰,或者暂时不值得独立成服务。
改完后怎么验证
验证的目标是确认边界是否真的被守住,而不是确认代码编译通过。可以从几个可观察的信号入手。
- 检查数据所有权:每个数据表是否只有一个服务写入。如果发现两个服务写同一张表,说明边界没有对齐。
- 检查调用链:跨服务调用是否只发生在上下文之间。如果同一个上下文内部也大量走远程调用,说明拆得过细。
- 检查事务范围:是否还存在跨服务的强一致事务,或者用补偿逻辑掩盖本该在同一聚合内完成的写入。
- 检查发布影响:改动一个上下文时,是否还需要同步改另一个服务的代码或数据库。如果需要,边界大概率画错了。
- 检查语言一致性:同一个术语是否在多个服务里被赋予了不同含义却没有显式区分。
预期信号是:一个业务变更通常只落在一个服务内,跨服务变更以契约变更的形式出现且可以单独排期;服务之间不存在共享数据库写入;领域事件或接口的变更能被下游明确感知。若验证后发现跨服务调用频繁且高度耦合,回退到合并部署或重新划定上下文,是合理选择,不必把拆分当成单向操作。
容易忽略的边界
第一,限界上下文不等于微服务数量。一个上下文可以先对应一个模块化单体中的模块,等独立部署的动因明确后再拆服务。把两者强行一一对应,容易在业务早期就承担分布式系统的运维成本。
第二,分布式事务与最终一致各有适用条件。强一致要求高的场景,拆分会显著增加复杂度,此时优先考虑合并聚合或调整边界;可以接受短暂不一致的场景,才适合用事件驱动。需要结合具体业务对一致性的容忍度确认,不宜默认采用最终一致。
第三,团队规模是硬约束。服务数量超出团队能独立维护的范围后,接口治理、监控、发布协调都会变成负担。小团队建议保守拆分,宁可边界粗一点。
第四,组织与权限限制会影响边界落地。如果数据库账号、部署权限或监控体系无法按服务隔离,拆分后的边界在运行层面仍然是虚的。回退建议是:先完成领域模型和模块边界梳理,保持单库单部署,等基础设施具备隔离能力后再推进服务拆分。
第五,边界不是一次性设计。业务能力会变化,上下文映射也需要随之调整。建议把上下文映射图和数据所有权清单作为持续维护的文档,而不是拆分前画一次就归档。