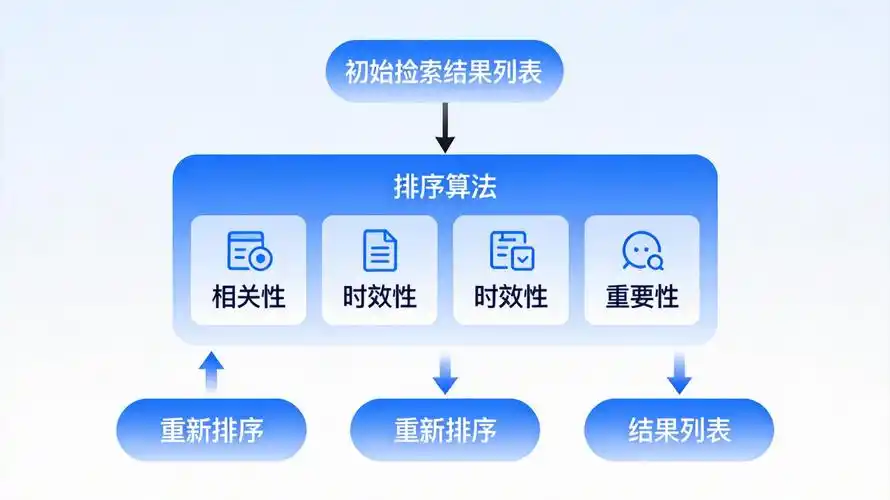
RAG 的召回重排序不是「再挂一个模型」就完事,它是夹在向量/关键词召回与拼装 prompt 之间的一段过滤逻辑。真正决定效果的是候选数量、输入构造、调用方式和失败降级这四件事,模型选型反而是最后一步。如果召回层本身没把证据块捞回来,重排序只能重新排列现有候选,不能变出新内容。
重排序适用于「召回 top-K 里相关段落有、但排在后面被截断」的场景。操作上先冻结一批带标注的评测 query,把候选数拉到 30–100,用 cross-encoder 类模型对 query-doc 对打分,再按分数取 top_n 拼 prompt。验证看关键证据块是否进入最终 top_n、延迟是否在预算内、降级路径是否被触发。如果召回本身命中率就差、或 chunk 太长被截断丢证据,先修切分和召回,不适用加重排序。
先确认当前场景和目标
先判断问题是不是重排序能解决的。常见判断条件是这几种:召回的 top-50 里能人工找到正确段落,但 top-5 拼进 prompt 的往往是泛泛而谈的段落;或者多个 chunk 内容相近,模型答非所问;又或者用了混合检索(向量加 BM25),两路分数不可比、合并顺序随机。这三种情况加重排序通常有收益。
反过来,如果人工在召回结果里也找不到正确段落,那是切分粒度、embedding 模型或 query 改写的问题,重排序帮不上。另外要确认三件事:一是候选上限能开多大,向量库是否支持一次取 50 条以上;二是延迟预算,重排序是同步调用还是可以异步;三是文档语言,跨语言场景要确认所选模型支持对应语种,否则分数会没有区分度。
按这个顺序处理
第一步,先把召回结果固定下来。从日志里抽一批真实 query(覆盖长问题、短问题、多跳问题),把当前召回 top-K 的 chunk 存成文件,作为后续比对的基线。没有基线,改完之后无法判断是重排序起效还是召回本身变了。
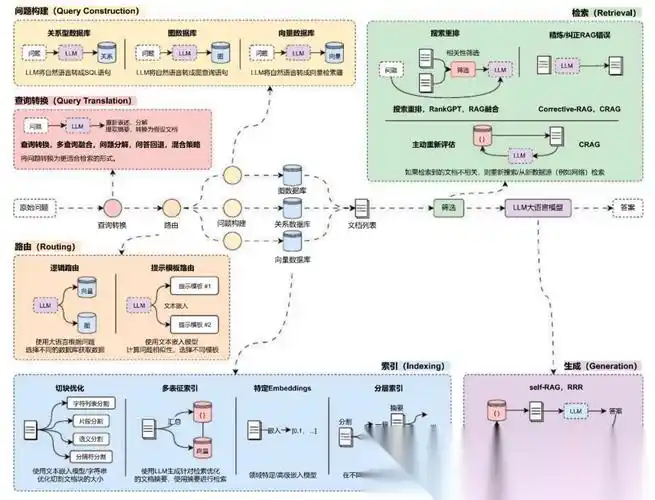
第二步,构造重排序输入。把 query 和 chunk 正文拼成一对,不要塞整篇文档。chunk 太长时按 max_length 截断,建议在 512 到 1024 token 之间,并且优先保留包含标题或小标题的前半段。如果 chunk 里有元数据,例如文档名、章节名,可以前置拼进文本,通常能提升模型判断力。
第三步,选定调用方式。API 类服务接入快、不用管显存,但要处理密钥权限、速率限制和超时;本地部署的 cross-encoder 可控性好,需要确认显存和并发。下面是一份与具体实现无关的配置骨架,字段名可按实际 SDK 替换,放在配置中心或环境变量里统一管理:
{
  "rerank": {
    "enabled": true,
    "candidate_k": 50,
    "top_n": 8,
    "max_length": 512,
    "batch_size": 8,
    "timeout_ms": 800,
    "score_threshold": null,
    "fallback": "keep_recall_order"
  }
}
第四步,写调用骨架并做输入输出校验。重点是用 index 回查原始 chunk,不要依赖返回的文本,避免模型输出被改写导致对不上:
POST {RERANK_ENDPOINT}
{
  "query": "<用户原始问题>",
  "documents": ["<chunk_0>", "<chunk_1>", "...", "<chunk_k-1>"],
  "top_n": 8
}

# 期望返回:按 relevance_score 降序的 [{index, relevance_score}]
# 校验点:index 在 [0, k-1] 范围内;越界或数量不足视为异常,走 fallback
第五步,设置异常路径。超时、返回条数不足、分数全为同一个值(说明模型没生效或输出格式解析错了),这几种情况都应回退到原始召回顺序,把请求继续走完,而不是直接抛错中断整条链路。score_threshold 建议先留空,等有了评测数据再定,因为不同模型的分数分布差异很大,硬编码阈值容易把有效段落全部过滤掉。
改完后怎么验证
验证动作一:拿前面冻结的评测 query 跑对比,分别记录「原始召回 top_n」和「重排序后 top_n」是否包含标注的关键证据块。观察的信号是:原来排在 10 名之后的关键块,是否稳定进入最终 top_n;同时确认没有明显的本来正确的段落被挤出去。
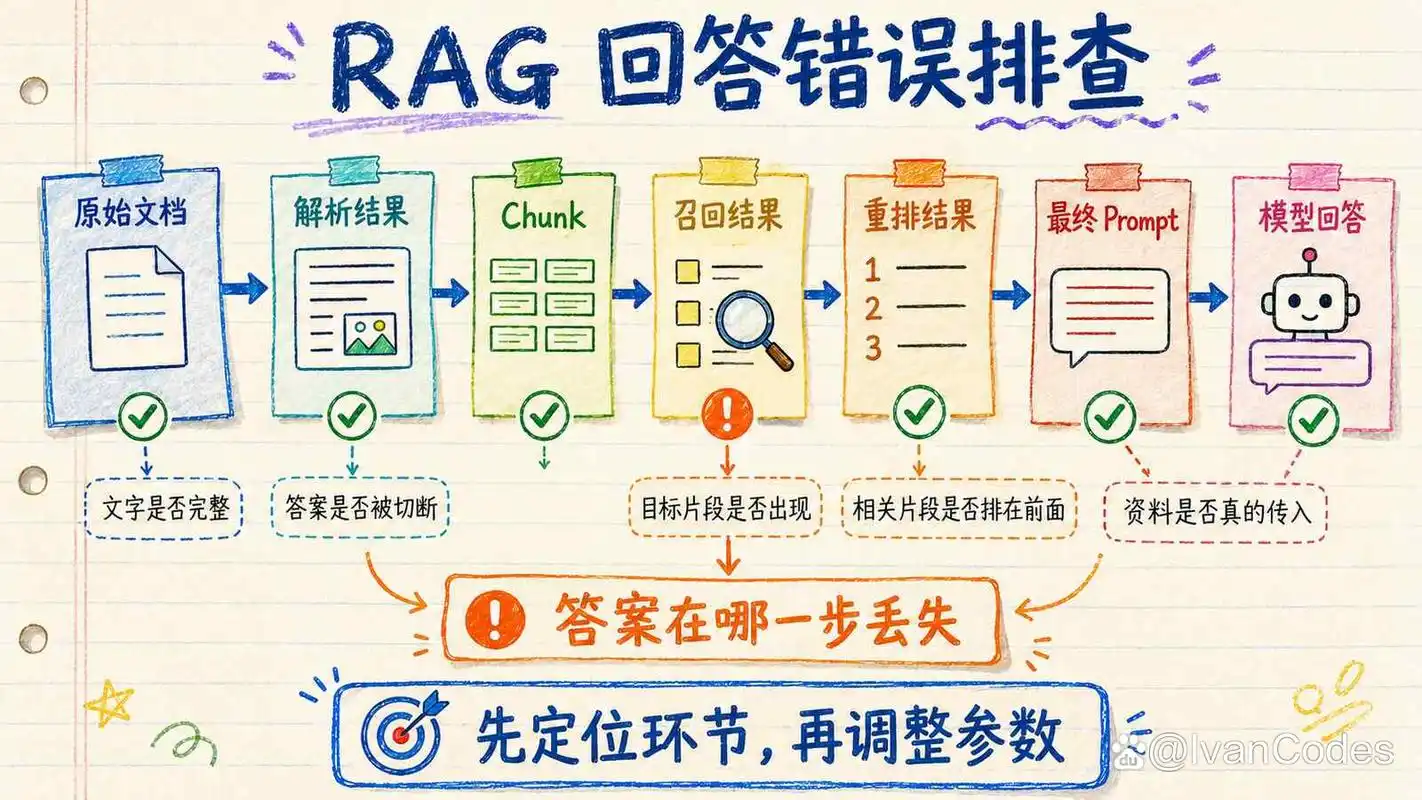
验证动作二:人工抽看 20 到 30 条端到端回答,重点看引用段落是否与问题对应,而不是只看最终答案读起来顺不顺。重排序出错时答案往往看起来很流畅,但依据是错的。
验证动作三:看延迟分布和降级触发次数。重排序是同步阻塞调用,需要确认它占用的时间没有把整体响应推过预算;如果降级频繁触发,说明超时设得太紧或者并发不够,这时候即使排序效果好也不适合直接上线,可以先只在部分请求上开启。批量离线跑一遍再小流量切,比直接全量安全。
容易忽略的边界
几个不适用或者容易出问题的点。第一,分数不可跨模型、跨版本比较,换模型或换 tokenizer 之后,之前调好的阈值和 top_n 都要重新看一遍。第二,chunk 截断是隐蔽的丢证据方式,如果 critical 信息刚好在 max_length 之后,重排序会给出低分,看起来像是模型判断失误。第三,本地部署要确认显存与 batch_size 的关系,batch 过大会 OOM,过小会拖慢整体耗时,需要结合环境实测确认。第四,多语言和领域术语场景,通用重排序模型可能对专业缩写没有区分度,建议先用一小批领域 query 试跑。第五,不要把重排序结果做缓存当成性能优化手段,缓存只是止血,排序模型本身的调用成本和延迟该算还是要算。回退建议是:任何改动都保留一个开关,关掉后链路回落到原始召回顺序,保证线上出问题时能立刻恢复。