量化模型显存占用要按“权重 + KV cache + 运行时缓冲 + 安全余量”分项估算,不能用参数量乘一个系数就当作最终结论。先判断自己的场景是单条推理、多并发服务还是微调,再确定量化格式和上下文长度;估算值只作为选择显卡和参数上限依据,最后仍要以模型加载后显存分配器的峰值读数为准。压缩量化位宽可以降低权重占用,但对长上下文场景帮助有限,KV cache 往往是主要部分。
量化模型显存估算的可用路径是:先明确推理还是微调、量化格式、最大上下文与并发数,再分别计算权重、KV cache 和框架运行时开销,最后加一段固定余量。量化只明显减少权重部分,长上下文和高并发场景下 KV cache 可能超过权重。估算结果用来选择显卡和设置最大长度上限,验证时以加载后的显存峰值和实际请求下的 OOM 表现为依据;如果余量不足,应先降低上下文或并发,而不是依赖内存交换。
先确认当前场景和目标
动手计算前先明确四项条件,否则算出的数字没有参考价值。
- 任务类型:只做推理、做批量离线推理,还是要微调。微调除权重外还要保存优化器状态和梯度,估算方式与推理完全不同,本文后面的分项只针对推理。
- 量化格式:GPTQ、AWQ、GGUF、INT8 等格式的权重位宽和元数据开销不同,加载器还会额外占用一部分显存。需要先看模型仓库标注的量化方式和框架支持情况。
- 上下文与并发:最大序列长度、同时在跑的请求数直接决定 KV cache 大小。只按短提示估出的数,放到长上下文场景会明显偏低。
- 部署形态:单卡还是多卡切分、是否启用 CPU offload、是否有其他进程共用同一张卡。多卡张量并行时,权重可以按卡分摊,但每张卡仍有各自的运行时开销。
确认这四项之后,再判断“显存够不够”才有意义。适合用本文方法的情况是常规 Transformer 类模型的推理部署;不适用于混合专家结构、超长序列特殊注意力实现,或框架内部做了大量预分配的场景,这些需要结合具体实现确认。
按这个顺序处理
第一步,估算权重占用。权重显存约等于参数量乘以每参数字节数:FP16 约 2 字节,INT8 约 1 字节,4bit 理论约 0.5 字节,但实际因分组缩放参数和元数据会略高,通常可按 0.6 字节左右保守估计。这一步只需知道模型参数量和量化位宽。
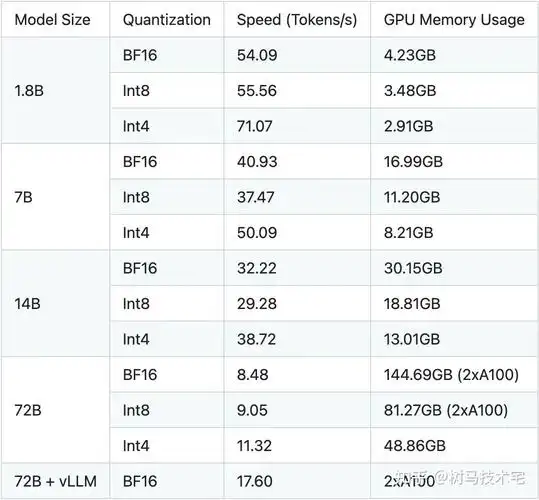
第二步,估算 KV cache。公式为:2(K 和 V)× 层数 × KV 头维度总和 × 序列长度 × 并发数 × 每元素字节数。使用分组查询注意力时,KV 头维度总和小于完整隐藏维度,按模型配置里的 KV 头数计算,不要直接用注意力头数。
第三步,加入运行时开销。CUDA 上下文、框架的临时缓冲区、算子工作区、显存碎片都会占掉一部分,通常与框架版本和注意力实现有关,建议在权重加 KV cache 之外再留 1–2 GB 固定余量,长上下文场景余量还要放宽。
可以用下面这段脚本先估算一次,把参数换成自己模型的配置再运行:
params = 7e9        # 模型参数量
bits = 4            # 量化位宽
layers = 32         # 层数
kv_dim = 1024       # KV 头数 * head_dim
seq = 4096          # 最大序列长度
batch = 1           # 并发数
kv_bytes = 2        # KV cache 精度,fp16 为 2

weight_gb = params * bits / 8 / 1024**3
kv_gb = 2 * layers * kv_dim * seq * batch * kv_bytes / 1024**3
reserve_gb = 2
print(round(weight_gb, 2), round(kv_gb, 2), round(weight_gb + kv_gb + reserve_gb, 2))
脚本输出的最后一个数就是建议的显存下限。如果它接近或超过显卡容量,优先下调最大序列长度或并发数,而不是先提高量化压缩程度。
改完后怎么验证
估算只是起点,需要实际加载模型并观察。加载完成后,在推理进程里读取显存分配器的已分配量和历史峰值,与脚本结果对比;同时用 nvidia-smi 查看整卡占用,两者差值通常来自 CUDA 上下文和其他进程。
然后按目标场景加压:先用最大序列长度跑单条请求,记录峰值;再把并发提高到预期值,观察是否出现 OOM 或显存持续增长。预期信号是峰值稳定在估算值加余量以内,请求结束后显存能回落到接近加载后的基线。如果峰值不断抬升,多半是缓存或图捕获相关配置没有固定住,需要回到框架配置里核对,而不是继续加显卡。
容易忽略的边界
- 预填充阶段的峰值通常高于逐 token 生成的稳态,按稳态估算容易在长输入时 OOM,验证时要专门跑长输入。
- 启用 CUDA Graph 类优化会额外占用固定显存,且与最大批大小相关,开关状态不同,估算结果不能直接套用。
- 多卡张量并行不是显存线性除以卡数,每张卡仍有独立的上下文和缓冲开销,卡数越多单卡有效容量越低。
- 量化格式与推理框架版本存在兼容性限制,某些算子只在特定后端下启用,缺失时会回退到更慢或更占显存的路径,需在目标环境中确认。
- CPU offload 和内存交换属于腾出显存的临时手段,会显著影响延迟,不能当作容量方案写进容量规划。
如果验证后发现余量不足,回退顺序建议是:先降低最大序列长度,再降低并发,再考虑更低位宽量化或换更大显存的卡。每一步改动后重新跑一遍上面的加载与加压检查,确认峰值符合预期再继续。