选交换机类型,判断点不在“哪种更高级”,而在两件事:一条消息要被几个队列各拿一份,以及路由条件能不能写进 routing key。direct 按 routing key 精确匹配,fanout 忽略 routing key 广播给所有绑定队列,topic 按 * 与 # 通配匹配,headers 按消息头键值匹配。先把消费拓扑和路由条件写清楚,四种类型的取舍基本就定了,剩下的工作是绑定命名和验证。
判断顺序建议是:先定一条消息是否需要被多个队列各拿一份,需要就走 fanout 或一队列一绑定;再定路由条件能否表达成 routing key,能就用 direct(固定枚举)或 topic(带层级和通配);routing key 放不下多属性组合时再考虑 headers。交换机类型创建后不能改,绑定规模变大后维护成本会上升,动手前先用 list_bindings 看清现有绑定,改完用测试消息确认只有预期队列计数增长。
先确认当前场景和目标
动手前先把下面几项确认清楚,任何一项没确认就选型,后面大概率要重建交换机和绑定。
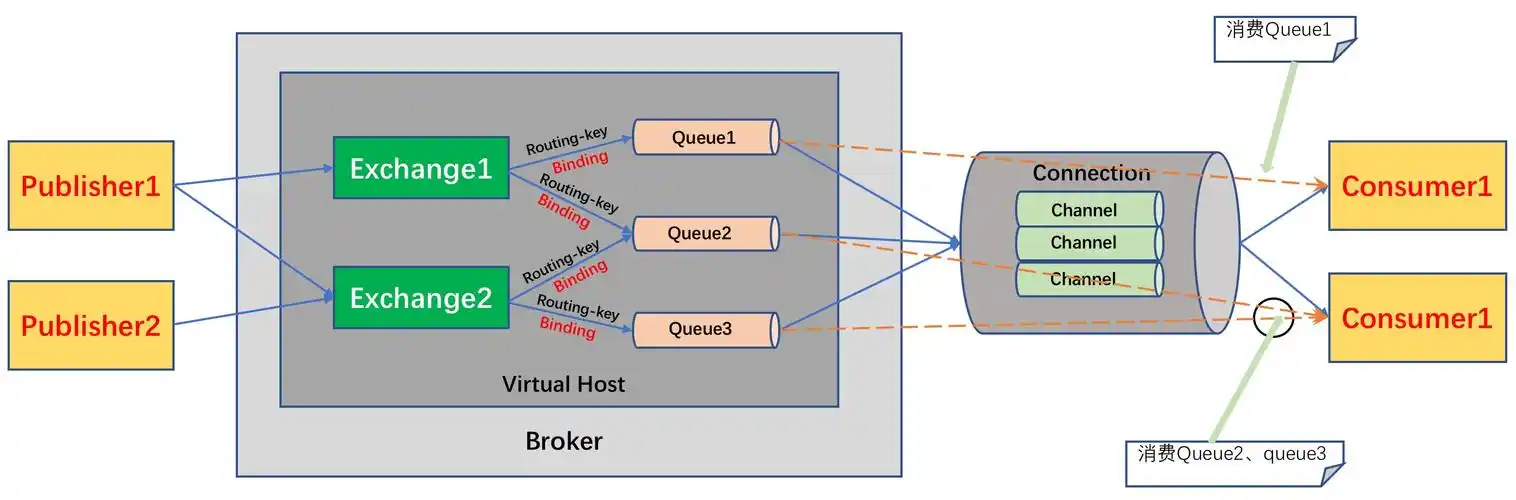
- 消费拓扑:同一条消息是只给一个队列(多个消费者竞争消费同一队列),还是每个下游各拿一份(多个队列各绑定一次)。这是 fanout 与其余三种的分水岭。
- 路由条件形态:是固定枚举(如
order.pay、order.refund),还是带层级维度(如order.cn.pay),还是由多个互不相关的业务属性组合决定。 - 是否允许改生产端:direct 与 topic 都要求生产端发对 routing key,如果生产端由多个团队维护、短期内改不动,选型要更保守。
- 现有绑定规模:交换机上已有多少绑定、谁在维护。topic 绑定越多,路由匹配与排查成本越高。
一个粗略的判断表,用来排除明显不合适的选项:
- 只有一个固定目标、路由值是枚举 → direct。
- 所有下游都要拿到同一份消息、不区分内容 → fanout。
- 路由条件有明显层级,且将来可能按前缀或中间段扩展订阅 → topic。
- 路由条件是多属性组合、顺序不稳定,且绑定关系长期不变 → headers,但要接受它更难在管理界面排查。
按这个顺序处理
- 先画消费拓扑。列出这条消息的生产者、需要收到的下游、每个下游是否要独立一份。多个下游各要一份、内容无差别,直接用 fanout 或让每个队列分别绑定同一交换机,不要用 routing key 硬编码区分。
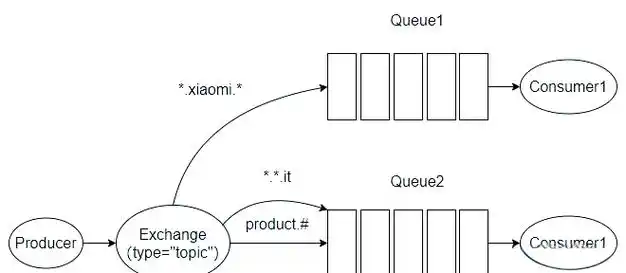
- 再判断路由条件能否写成 routing key。能写成稳定、有层级的字符串,优先 topic;层级很短且几乎不变,direct 更直观,绑定关系也更好读。
- topic 结构定好后立刻固定命名。例如用
业务.区域.动作三段,明确*只匹配一段、#匹配零到多段。订阅方按需写order.*.pay或order.cn.#,避免一上来就用#把 topic 退化成广播。 - headers 放到最后考虑。只有当路由条件确实无法用 routing key 表达、且绑定关系变更不频繁时才用;绑定时要写清
x-match取all还是any,这个参数决定匹配语义。 - 用命令行把设计落下去并留档。下面是一段通用骨架,名称、类型按自己环境替换,命令依赖 management 插件提供的 rabbitmqadmin,也可以改用管理界面操作:
# 声明交换机与队列(示例,按环境替换名称)
rabbitmqadmin declare exchange name=order.topic type=topic durable=true
rabbitmqadmin declare queue name=order.pay durable=true

# 绑定关系:topic 用通配,direct 用精确值
rabbitmqadmin declare binding source=order.topic destination=order.pay routing_key="order.*.pay"

# headers 交换机绑定需带参数,x-match 决定 all/any
rabbitmqadmin declare binding source=order.headers destination=order.pay \
  arguments='{"x-match":"all","region":"cn","action":"pay"}'
关键点:交换机类型创建后不可修改,只能新建交换机再迁移绑定。迁移期间新旧交换机可能同时存在绑定,消费者需要能做幂等处理,否则会出现重复消费。
改完后怎么验证
验证的目标是确认“路由结果与设计一致”,不是看服务有没有报错。建议按下面几步走:
- 查交换机类型是否正确:
rabbitmqctl list_exchanges name type durable,确认目标交换机的 type 是 direct、fanout、topic 或 headers。 - 查绑定是否符合预期:
rabbitmqctl list_bindings source_name destination_name routing_key,headers 绑定还要看 arguments 列里的匹配参数。 - 发一条测试消息:在管理界面的交换机页面用 Publish message 指定 routing key 或 headers 投递,随后用
rabbitmqctl list_queues name messages_ready messages_unacknowledged观察。 - 预期信号:只有设计内的队列 ready 数增加,其他队列数值不变;不匹配任何绑定的消息不会进入任何队列,如果配置了 alternate-exchange 会转到备用交换机,否则被丢弃。
- 生产端侧:开启 publisher confirm 并设置 mandatory 标志,捕获 basic.return,确认不可路由的消息能被感知,而不是静默丢失。
容易忽略的边界
- fanout 不是“更快”的方案。它把消息复制到每个绑定队列,队列数量增长会同步放大存储与投递压力,适合无差别广播,不适合拿来兜底未知路由。
- topic 通配写宽了会退化。大量
#绑定等于广播,且匹配与排查都更费劲;建议在主题结构确定后再放开通配范围。 - headers 排查成本高。绑定参数写在 arguments 里,管理界面不如 routing key 直观,不同客户端库传参写法也有差异,团队不熟悉时建议先用 topic 替代。
- 持久化要成套配置。durable 交换机、durable 队列、持久化消息三者配合才有效果,只设交换机 durable 不代表消息不丢。
- 权限与 vhost。新建交换机、绑定需要对应 vhost 下的 configure/write/read 权限,跨 vhost 的绑定不生效。
- 回退思路。新方案上线后若发现绑定关系难以维护,可以保留原交换机与绑定,逐步把生产端切到新交换机,确认无异常后再下线旧绑定;不要直接删除仍被引用的交换机。