限流管的是“入口允许多少请求进来”,熔断管的是“对某个下游依赖还要不要继续调用”。两者不是替代关系:限流保护自己不被压垮,熔断在依赖已经出问题时让调用方快速失败、不再干等。判断一个场景该用哪个,先看你防的是自身容量被打满,还是防一个外部依赖拖慢整条调用链。
限流适用于可预估容量的入口保护,做法是设定阈值并对超出部分拒绝或排队;熔断适用于依赖已经异常的场景,做法是按失败率或慢调用比例打开开关、快速返回兜底。验证方式不同:限流看阈值附近的拒绝行为是否收敛,熔断看故障注入后状态能否打开并恢复。边界在于单机阈值会随扩缩容漂移、低流量下熔断统计容易误判,上线初期建议先只记录不拦截,确认无误再真正生效。
先确认当前场景和目标
动手前先把问题落到具体对象上,否则很容易把两个机制混着配,结果谁都没配准。需要先确认的信息:
- 保护对象:防的是自己的服务被突发流量打满(CPU、连接数、线程池),还是防某个下游依赖超时把上游线程拖死。前者对应限流,后者对应熔断。
- 流量是否可预估:能大致算出容量上限的入口,限流阈值比较好定;完全不可预估的调用,阈值只能先保守设,再靠观测调整。
- 失败是否可接受:限流拒绝的是正常请求,业务要能接受被拒绝并给出明确提示;熔断触发的是对某个依赖的调用,需要有降级返回(默认值、缓存、空结果)兜底。
- 调用链上有没有重试:有重试时,限流放过的请求会被重试放大,熔断的失败统计也会被重试污染,这两点都要在配置前确认清楚。
如果上面几条里有任意一条答不上来,说明还没到配阈值的时候,先把调用关系和容量盘子弄清楚更划算。
按这个顺序处理
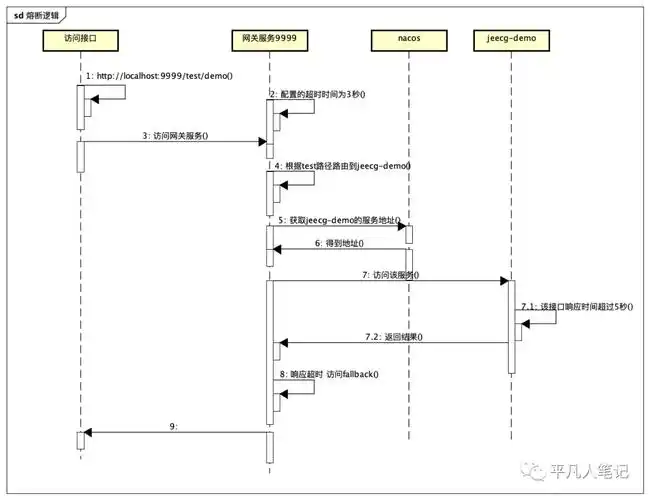
建议按“定位对象 → 配限流 → 配熔断 → 对齐超时重试 → 加兜底”的顺序推进,每一步都能单独验证。
- 先给问题归类。同一段代码里既做限流又做熔断没问题,但要在注释或配置里写清楚各自在防什么,否则后面排查会分不清是谁拒绝了请求。
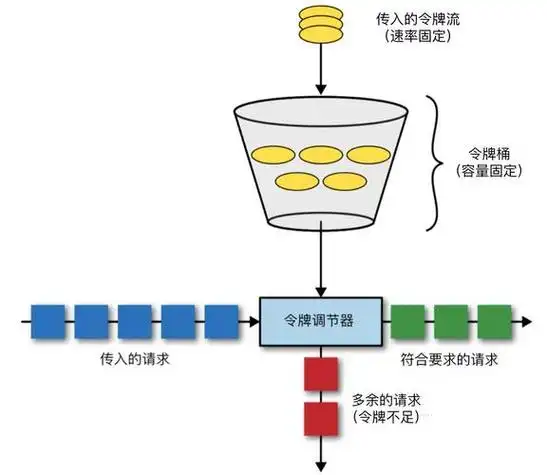
- 限流维度和阈值。先定维度:全局、单实例、按用户或租户。单实例限流最简单,但扩缩容时总阈值会漂移;需要稳定总量时用集中式配额。阈值通常从历史峰值和压测结果里取一个偏保守的值,先低后调,不要一次压到极限。
- 限流的拒绝策略。快速失败(直接返回限流错误)最简单,也最容易排查;排队适合后端处理能力稳定但请求有尖峰的场景,代价是增加延迟。选择前确认调用方能接受哪种。
- 熔断的判定条件。常见是按失败比例、慢调用比例或连续失败次数触发,配合一个最小请求数门槛,避免请求量太小就误开。开启后要有半开探测,确认依赖恢复后能自动放量。
- 超时和重试对齐。熔断判定里的慢调用阈值应当大于正常调用的预期耗时,超时时间要小于这个阈值,否则请求先超时再被计入慢调用,判断会失真。重试次数建议少而明确。
- 兜底动作。限流被拒返回明确的错误码和提示,熔断打开时返回降级值。兜底逻辑要预先写好并测过,不能等到开关打开时才发现没有可返回的内容。
下面是配置结构的示意,字段名和写法按自己使用的框架或配置中心替换,重点看结构而不是照抄:
# 结构示意:字段名按实际框架替换
rate_limit:
  dimension: instance        # instance / global / per_user
  threshold: 200             # 先保守,观察后再调
  strategy: reject           # reject / queue
  queue_timeout_ms: 200
circuit_breaker:
  target: order-service      # 被保护的依赖
  failure_ratio: 0.5         # 触发条件之一
  slow_call_ms: 800          # 应大于正常耗时、小于调用超时
  min_requests: 20           # 低于该量不判定
  half_open_probe: 5         # 半开放行的探测请求数
  fallback: return_empty
改完后怎么验证
限流和熔断都不能只看配置是否加载成功,要观察行为。建议先在只记录不拦截的模式下跑一段时间,确认统计符合预期后再真正生效。
- 限流验证:在低于阈值时发请求,确认全部通过、没有误拒;把并发逐步抬到阈值附近,观察被拒比例是否在阈值之上才开始上升,而不是提前抖动。按用户维度限流时,用一个账号打满再看其他账号是否正常。
- 熔断验证:在测试环境用 mock 或故障注入让下游变慢或报错,观察熔断是否进入打开状态、打开期间请求是否快速返回而不是继续等待,以及依赖恢复后能否经半开探测回到关闭。重点关注状态切换的时间点是否与配置的窗口吻合。
- 预期信号:限流生效时,超出阈值的请求集中被拒、系统负载不再随入口流量线性上升;熔断生效时,下游故障期间上游的耗时不再被拖长,错误以兜底结果的形式快速返回。
- 观察指标:被拒请求数、排队时长、熔断状态变化次数、下游错误率、兜底的命中量。指标对不上时先看统计维度是否正确,再看阈值是否定得离谱。
容易忽略的边界
- 单机限流在弹性伸缩下会漂移。实例数变化时总放行量随之变化,需要按实例数折算或改用集中式配额。这是限流的常见误判来源,不是配置写错了。
- 低流量下熔断统计不可靠。请求量小的时候失败比例波动大,容易因为几次失败就打开。设置最小请求数门槛,流量实在低的依赖可以只告警不熔断。
- 熔断保护的是调用方,救不了下游。下游已经过载时,熔断只是让上游不再陪跑,下游的容量问题要另行处理。
- 重试、异步队列和批量任务会让数字失真。批量任务一次调用可能顶很多次业务请求,按请求数配的阈值对它并不成立,需要单独考虑。
- 配置热更新不一定生效。部分框架的限流和熔断参数在启动时读取,改配置中心未必立刻生效,改完要确认实际值。
- 回退建议:阈值配错或出现大量误拒时,先把模式退回只记录或把阈值调回上一版,再排查;熔断持续误开时先调高最小请求数或慢调用阈值,而不是直接关掉整个依赖的保护。