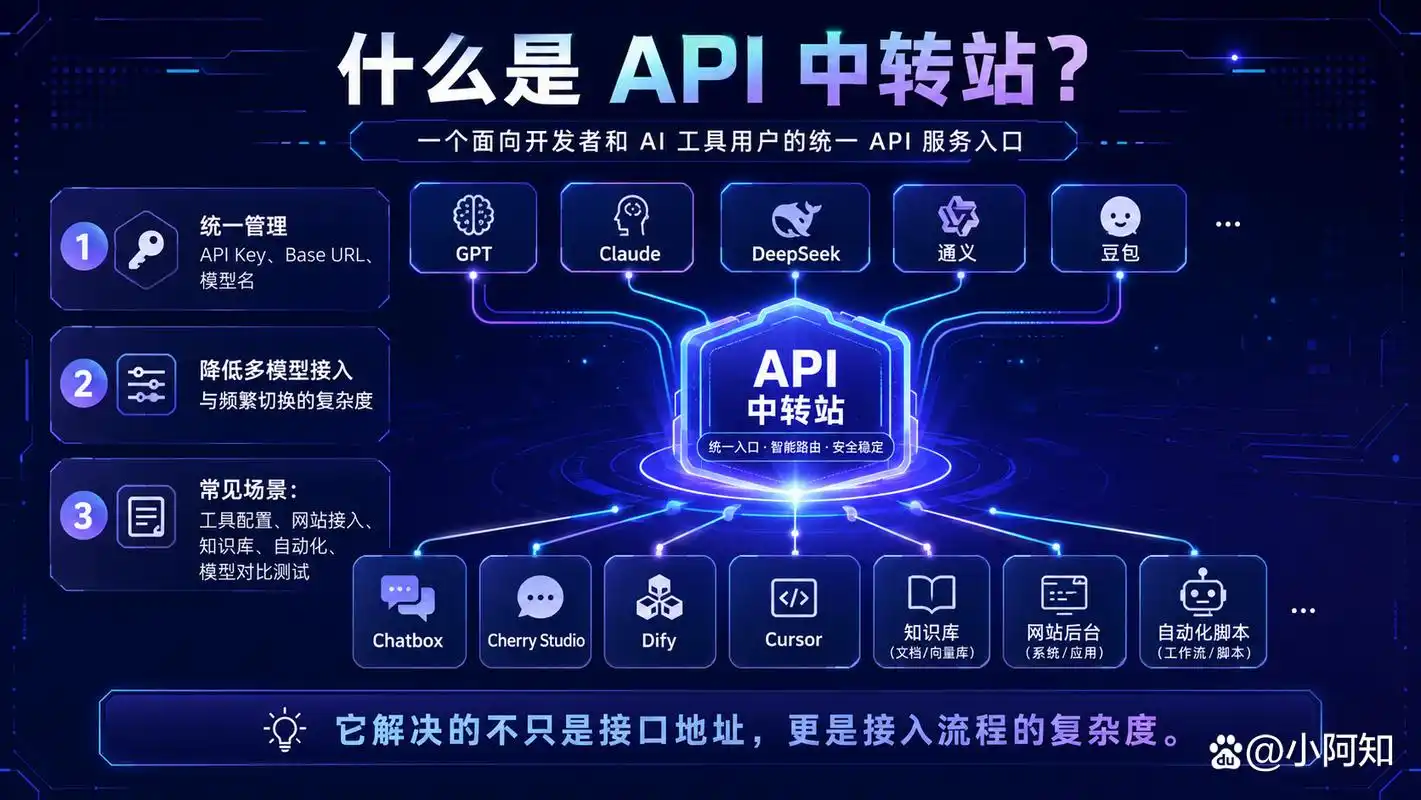
API 中转站和直接调用接口的差别,不在于能不能调通,而在于调用链上多了一个由别人控制的中间层。直接调用是你用自己的密钥访问服务方端点,限流、计费、请求 ID、日志都在你和上游之间;中转站是你访问中转方给出的地址,由它持有上游凭据并把请求转发过去,你拿到的是二次封装后的响应。这个中间层会改变三件事:密钥归谁管、出问题时谁负责定位、请求内容经过了谁的机器。判断要不要用中转站,先看这三件事,而不是先看价格或接入速度。
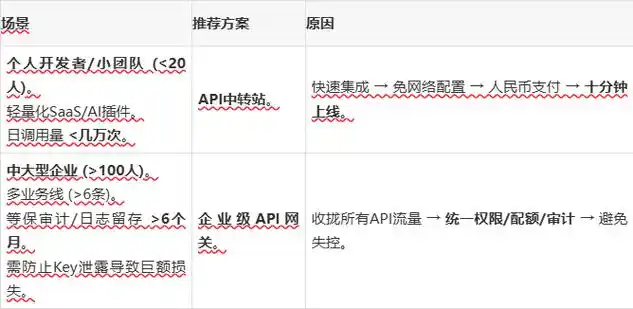
如果只是短期验证模型能力、需要把多个上游统一成一种请求格式,或团队暂时不便逐个申请密钥,可以先接中转站,用最小请求跑通再决定是否扩大范围。如果涉及业务数据、需要精确对账、需要在上游控制台自查用量,或对超时与稳定性有明确要求,应优先直接调用。判断依据是密钥归属、故障定位责任和日志留存位置,这三项任一项说不清,就先不要接入。
先确认当前场景和目标
把中转站放进自己的环境之前,先确认下面这些信息,缺一项都会让后面的排查失去参照。
- 密钥归属:调用时使用的是你申请的密钥,还是中转方下发的密钥。前者出问题可以自己去上游控制台核对用量,后者只能依赖对方提供的账单和日志。
- 调用链跳数:请求从你的服务发出后,是直接到上游,还是先到中转方再到上游。跳数决定超时预算怎么分配,两跳的链路要给中间层留出额外等待时间。
- 数据边界:请求体里是否包含用户隐私、内部文档或密钥类内容。如果包含,需要确认中转方是否落盘、落盘多久,这一项通常只能通过书面约定确认,代码层面验证不了。
- 响应字段需求:你的业务是否依赖
usage、id、model这些字段做计费或审计。中转站对这类字段的处理方式差异较大,有的原样透传,有的改写,有的缺省。 - 失败恢复方式:上游不可用时,业务是降级、重试还是切到另一条通道。中转站的重试语义由对方定义,不能假设和你自己写的重试逻辑一致。
按这个顺序处理
第一步是把接入点做成可替换的配置,不要把地址和密钥写死在业务代码里。至少抽出三个变量:基础地址、密钥、模型名。下面的配置只是通用骨架,实际值需要按你选定的服务方填写。
# .env 示例,仅供说明变量划分,不要提交到代码仓库
API_BASE_URL=https://your-endpoint.example.com/v1
API_KEY=replace-with-your-key
API_MODEL=your-model-name
API_TIMEOUT=30
第二步,用最小请求探活。先不要带业务提示词,只发一个最简单的补全请求,确认地址、鉴权头和返回结构都能对上。下面的 Python 片段是通用接入骨架,替换 base_url 和 model 即可在直连与中转两种模式下复用。
import os, requests

base_url = os.environ["API_BASE_URL"].rstrip("/")
headers = {
    "Authorization": f"Bearer {os.environ['API_KEY']}",
    "Content-Type": "application/json",
}
payload = {
    "model": os.environ["API_MODEL"],
    "messages": [{"role": "user", "content": "ping"}],
    "max_tokens": 16,
}

resp = requests.post(f"{base_url}/chat/completions",
                     headers=headers, json=payload,
                     timeout=int(os.environ.get("API_TIMEOUT", 30)))
print(resp.status_code)
print(resp.json())第三步,逐项比对返回结构。把同一个请求分别打向直连地址和中转地址,重点看三个地方:id 是否存在且格式一致、model 是否被改写、usage 里的 token 数是否齐全。需要做计费的业务,还要确认 usage 是上游返回的还是中间层估算的。
第四步,补齐超时和错误处理。给连接超时和读取超时分别设值,不要只设一个总超时;对 4xx 和 5xx 分开处理,鉴权失败不要重试,服务端错误才进入重试分支。中转站返回的错误结构可能和上游不同,错误码映射需要按实际返回补充,不要沿用直连时的判断。
第五步,记录可追溯信息。把请求时间、状态码、响应中的 id 和耗时写进日志,但不要把完整密钥写进日志。这条记录是后面区分“上游慢”和“中间层慢”的唯一依据。
改完后怎么验证
验证动作要能区分链路中的哪一段出了问题,而不是只看请求有没有成功。
- 用同一个提示词分别请求直连地址和中转地址,对比返回内容结构是否一致。预期信号是字段名、层级和类型都对得上;如果
usage缺失或model被替换,说明中间层做了改写,计费逻辑要跟着调整。 - 故意使用错误的密钥发一次请求。预期信号是返回明确的鉴权类错误,而不是超时或空响应。返回内容含糊的情况,说明错误透传被中间层吞掉了,后续排障会很困难。
- 把超时设为很短的值,观察失败发生在哪一端。预期信号是能通过日志耗时判断出是连接阶段失败还是等待阶段失败。
- 如果怀疑延迟偏高,可以在同一台机器上分别请求两种地址并记录耗时。这里只做相对比较,不要用单次结果下结论,建议多次取样看分布。
- 检查日志和配置文件里是否残留明文密钥,确认密钥只从环境变量或密钥管理服务读取。
容易忽略的边界
中转站和直连的差异,往往在边缘场景才暴露出来。流式响应是其中之一:不同实现推送的事件格式、结束标记和心跳间隔可能不同,前端如果按某一种格式解析,切换通道后可能收不到结束信号。图片、文件类输入的上传路径和参数命名也经常不一致,这部分不能靠请求补全接口的经验类推。
usage 字段的可信度需要单独确认。中转方可能自行统计 token 数,结果和上游账单对不上,涉及结算的业务要把这项作为验收条件之一。另外,中间层的版本、上游映射关系和限流策略通常不会主动同步给你,行为变化可能没有任何通知。
不适用中转站的情况比较明确:请求体包含不可外发的业务数据、需要在上游控制台自查调用记录、或者对稳定性有可追责要求时,应走直连。已经接入中转站的,建议保留一条直连通道作为回退,用配置开关切换,并在切换前确认两种响应的字段差异已经被业务代码兼容。回退时不要只改地址,密钥、模型名、超时预算通常都要一起调整。