如果只考虑召回这一层,两者的差别在于:向量检索只用 embedding 相似度找候选,混合检索在向量通道之外再并行一路关键词(通常是 BM25 或倒排)通道,把两路结果融合后排出一个最终的 top-k。真正需要判断的点是:你的查询里是否大量存在语义模型不敏感的字符串,比如型号、错误码、缩写、条款号、人名、函数名;如果有,纯向量检索会把这类 query 的正确答案漏掉,混合检索的价值才会出现;如果 query 基本都是自然语言长问句,混合检索多出来的那一路往往只是在承担延迟成本。
判断是否应该使用混合检索,先看三条:query 里是否包含专有名词、编号、代码标识符;漏召是“完全不在 top-k”还是“排得太靠后”;语料是否短文本、表格、中英混排为主。属于前一种漏召的,可以并行加一路 BM25,用 RRF 融合,先建立 50 条以上的人工标注评估集再动手;只是排序靠后的,优先上 rerank,不要急着改索引结构。混合检索对中文分词和领域词典有依赖,词典缺失时关键词通道会带入噪音,需要保留回退到纯向量的开关。
先确认当前场景和目标
动手改检索之前,先把自己环境里的信息查清。第一件事是把线上或测试中“答案不对”的 query 抽出来,按失败形态分类:是正确文档根本没进 top-k(漏召),还是进了 top-k 但排在第 8 位、被截断掉(排序问题),还是正确文档在里面但生成阶段没用好(那是生成侧的问题,改检索没用)。这三类失败的处理手段完全不同,混在一起调只会越调越乱。
- 查询特征:统计一批真实 query,看含有数字编号、英文缩写、产品型号、引号内短语、代码片段的比例。占比高,说明向量通道容易失手。
- 语料特征:chunk 是长段落还是短条目;是否存在大量表格、参数清单、日志片段。关键词通道对短条目和专有名词命中更直接,对长叙述段落的收益有限。
- 分词条件:中文场景下 BM25 依赖分词器和领域词典,如果连产品名、缩写都会被切碎,先补词典,否则融合只是把噪音排上来。
- 目标口径:本次优化的目标是提高 recall@k(把正确文档捞回来)还是提高 MRR(把正确文档排前面)。前者考虑加通道,后者优先考虑 rerank。
按这个顺序处理
建议按下面的顺序推进,每一步都能独立停下,不必一口气全部上完。
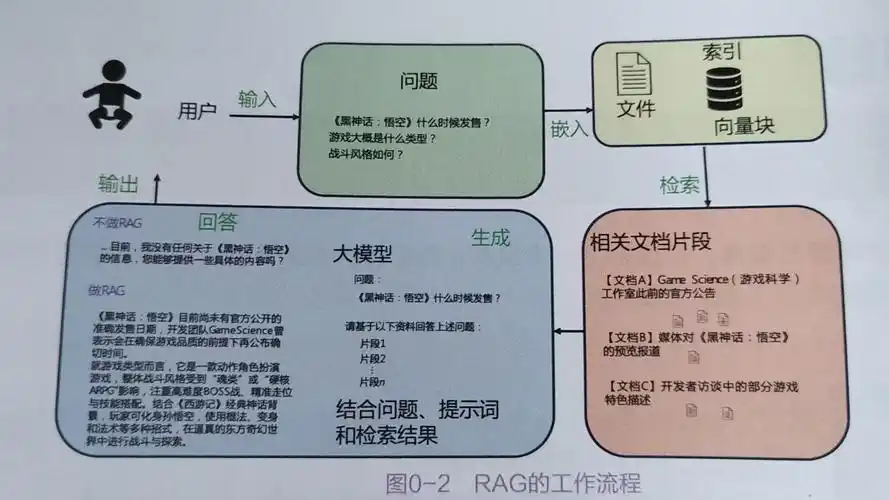
- 先建立评估集。从真实 query 里挑 50~100 条,人工标注每条对应的正确 chunk id。没有这个集合,后面所有“有没有变好”的判断都只能靠感觉。
- 运行纯向量基线。用同一份评估集记录 recall@5、recall@10 和正确文档的排名分布。如果正确文档基本都落在 top-10 内、只是排名偏后,那么主要矛盾在排序,不在召回。
- 判断漏召是否集中在字符串类 query。把失败样本按“是否含专有名词或编号”分组,如果漏召明显集中在这一组,混合检索值得试;如果均匀分布在所有类型,问题更可能出在切分粒度、embedding 模型与语料不匹配。
- 加关键词通道。除了向量 top-k 之外,再并行一路 BM25 检索。中文先配置分词器和领域词典,词典里补上产品名、缩写、错误码前缀,避免关键标识符被切散。
- 选融合方式。两路分数分布不同量级,直接加权需要先做归一化,且归一化方式会随数据漂移,维护成本高。更省心的做法是用倒数排名融合(RRF),只依赖名次、不依赖分数。
- 考虑做查询路由。不是每条 query 都需要走两路。可以用简单规则识别:含数字、含大写缩写、含引号内短语的 query 走混合,其余走纯向量,减少多一路检索带来的延迟。
下面是一个 RRF 融合的最小骨架,放在向量检索和关键词检索都返回结果之后执行,参数 k 和 top_n 需要按自己的评估集调整,两路各自取多少个候选也要分别确认。
def rrf_fuse(vec_ids, kw_ids, k=60, top_n=10):
    # vec_ids / kw_ids: 两路检索各自返回的 doc_id 有序列表,越靠前名次越高
    scores = {}
    for rank, doc_id in enumerate(vec_ids):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank + 1)
    for rank, doc_id in enumerate(kw_ids):
        scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank + 1)
    return sorted(scores.items(), key=lambda x: -x[1])[:top_n]
路由规则可以先用可读性最好的白名单形式写,比如:命中 \d{3,}、命中全大写缩写、命中引号内短语,就走混合;其余走纯向量。规则放在检索入口,不要散落在业务代码里,方便后续按失败样本增删。
改完后怎么验证
验证一定要用改之前那同一份评估集,不能换题,否则前后不可比。
- 看分类别的 recall:把评估集按“含专有名词”和“纯自然语言”两组分别算 recall@10。合理的预期是前一组有改善,后一组基本持平;如果后一组明显变差,多半是关键词通道把字面匹配但语义无关的文档排了上来,需要收窄关键词通道的候选数或调整路由。
- 人工抽检 top-5:随机抽 20 条左右,看融合后的前五条有没有明显不相关的结果被带进来。关键词匹配容易命中“出现了同一个词但讲的是另一件事”的文档,这个现象要靠人眼发现,指标看不出来。
- 观察延迟分布:混合检索多一路查询,需要看 P95 或 P99 而不是只看平均值。两路之间建议并行发起,并对关键词通道设置独立超时。
- 看线上表征:无答案率、追问率、引用采纳情况这类信号可以作为辅助,但不要把它们当唯一依据,因为生成侧改动同样会影响这些数字。
达到目标的表现通常是:那批此前漏召的字符串类 query 现在能稳定召回正确文档,且纯语义类 query 的质量没有可感知的回退。若只有前者改善而后者下降,说明融合比例需要重调,而不是方案本身不行。
容易忽略的边界
- 不适用于语料规模很小的情况。当知识库只有几百个 chunk 时,把候选数调大一点往往就能覆盖,引入第二路索引和融合逻辑的维护成本不划算。
- 分词与词典是前置条件。中文领域词典没补齐之前,BM25 通道的召回质量不稳定,可能反而把结果搅乱。建议先在小样本上对比加入词典前后的关键词通道命中情况。
- 两路索引的一致性。文档新增、更新、删除时要同时写向量库和倒排索引,删除不同步会长期残留已经下线的旧 chunk,这类问题在评估集里未必暴露,要在数据同步链路上单独确认。
- 不要一次调完长期沿用。embedding 模型、切分方式、词典任一变更后,融合参数和路由规则都应重新评估,否则之前调好的比例会失效。
- 保留回退路径。给检索入口加一个开关,可以切回纯向量路径;关键词通道异常时自动降级为单路,不要让整条链路因为倒排索引不可用而报错。
- 表格和 OCR 文本要单独看。这类内容的字面结构混乱,关键词通道的收益不确定,建议先单独取样评估,再决定是否纳入混合范围。