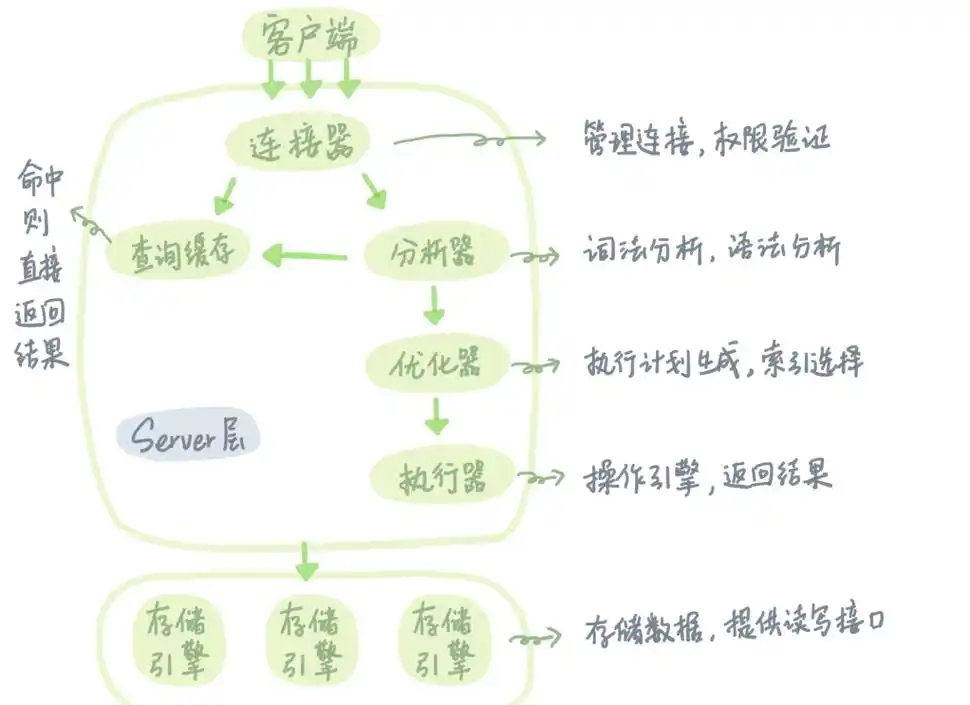
索引原理和慢查询优化解决的不是同一个问题:索引原理解释“优化器为什么会选这条访问路径”,证据来自 SHOW INDEX 和 EXPLAIN;慢查询优化解释“这条 SQL 在当前数据量、参数和并发下为什么超过 long_query_time”,证据来自慢查询日志和 performance_schema。两套证据来源不重合,所以背熟 B+ 树和最左前缀,并不等于能定位一条具体的慢 SQL。判断顺序建议是:先从慢查询证据里拿到具体 SQL,再看执行计划和索引结构,最后才谈改写或加索引。
索引原理回答“优化器为什么选这条路径”,慢查询优化回答“这条 SQL 为什么超时”。先用 slow_query_log 或 performance_schema 抓到具体 SQL,再用 EXPLAIN 看访问路径;两者对不上时优先怀疑索引选择性和基数估计,而不是继续加索引。适用场景是有明确慢 SQL 的库;边界是数据量差异大的测试库结论不能直接搬到线上。
MySQL索引:先把能核对的事实摆清楚
动手前先确认环境,版本和参数决定你能用哪条命令。这几条都是只读查询,可以在从库或低峰时段执行:
SELECT VERSION();
SHOW VARIABLES LIKE 'slow_query_log%';
SHOW VARIABLES LIKE 'long_query_time';
SHOW VARIABLES LIKE 'log_output';
SHOW VARIABLES LIKE 'performance_schema';
log_output 为 FILE 时,慢日志写在 slow_query_log_file 指向的路径,登录服务器直接 tail 即可;为 TABLE 时改看 mysql.slow_log 表。这两处是慢查询唯一的原始证据,没有它们就只能靠猜。
索引侧能核对的事实有三类,含义各不相同:
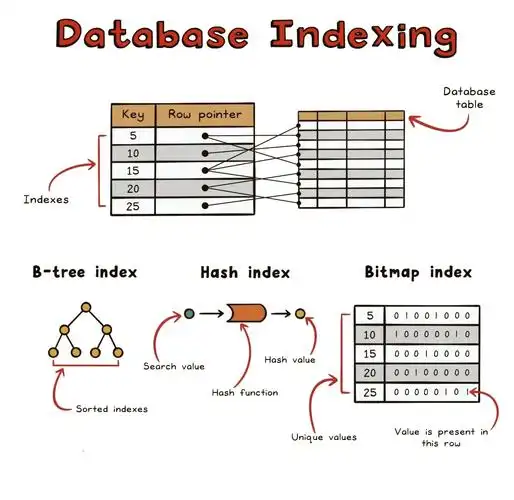
SHOW INDEX FROM 表名;看索引名、列顺序、Cardinality、是否唯一;列顺序决定最左前缀能不能用上。EXPLAIN SELECT ...;的 type、key、rows、Extra 是优化器的估计值,不是实际执行结果。EXPLAIN FORMAT=JSON SELECT ...;能看到used_key_parts、filtered,用来判断索引用到第几列。
慢查询侧可以先按总耗时排序取头部 SQL,前提是 performance_schema 为 ON:
SELECT DIGEST_TEXT, COUNT_STAR, SUM_ROWS_EXAMINED, SUM_ROWS_SENT,
       SUM_TIMER_WAIT/1e12 AS total_sec
FROM performance_schema.events_statements_summary_by_digest
ORDER BY SUM_TIMER_WAIT DESC LIMIT 10;
到这里只做记录,不下结论。先看清楚哪条 SQL 慢、慢在扫描行数还是返回行数,再判断该动索引还是动 SQL。
MySQL索引最容易搞错的一点
最常见的误解是把“没走索引”当成慢的唯一原因。实际排查中更常见的情况是:索引确实被用了,但过滤性差、需要回表、或者要为排序做 filesort,耗时依然下不来。分界线很清楚——EXPLAIN 的 key 不为空,而慢日志里同一条 SQL 的 Rows_examined 仍然接近表的总行数,问题在索引选择性和回表代价;只有 key 为 NULL、type 为 ALL,才是真的全表扫描。
能把两种情况区分开的动作是:拿同一条 SQL,先看 EXPLAIN,再对照实际扫描行数。
EXPLAIN SELECT id, status FROM orders WHERE status = 'pending' ORDER BY created_at LIMIT 20;

SELECT SQL_TEXT, ROWS_EXAMINED, ROWS_SENT
FROM performance_schema.events_statements_history_long
WHERE SQL_TEXT LIKE '%FROM orders WHERE status%'
ORDER BY TIMER_START DESC LIMIT 5;
如果第二条查不到记录,先确认 setup_consumers 里 events_statements_history_long 为 YES,否则这条对照就失效了。这里容易踩的坑是:只看 possible_keys 有值就开始建索引,结果建了一个和现有索引前缀重复的索引,既没改善过滤,又增加了写入成本。
MySQL索引:一个照着就能做完的做法
- 取头部 SQL:用上面的 digest 查询或
pt-query-digest 慢日志路径拿到按总耗时排序的前几条,抄下完整 SQL 形态。 - 看执行计划:对抄下的 SQL 跑
EXPLAIN,记录 type、key、key_len、rows、Extra 五项。key_len 能反推索引用到第几列。 - 看索引结构:
SHOW INDEX FROM 表名;对照 WHERE 条件列和 ORDER BY 列的顺序,判断现有联合索引的最左前缀是否被浪费。 - 改一处:要么补一个按“等值列在前、范围列在后”排列的联合索引,要么改写 SQL 让排序字段可被索引覆盖。一次只改一处,方便归因。
- DDL 执行:MySQL 5.6 以上 InnoDB 支持 Online DDL,可以用
ALTER TABLE 表名 ADD INDEX idx_name (col1, col2), ALGORITHM=INPLACE, LOCK=NONE;,但并非所有操作都支持该组合,执行前先用SHOW CREATE TABLE和版本号确认,报错就退回默认方式并在低峰做。 - 复测:MySQL 8.0.18 及以上可以用
EXPLAIN ANALYZE SELECT ...;,输出里能看到 actual time 和 actual rows,与预估 rows 对比。
第 2 步该看到的是关键列是否出现在 key 中;第 5 步该看到的是 DDL 成功且表结构里多了预期索引;第 6 步该看到的是 actual rows 与 rows 处于同一量级,而不是差几个数量级。
MySQL索引:怎么验证结果对不对
验证分三层,缺一层都不算完成。第一层看执行计划:EXPLAIN ANALYZE 输出中 type 从 ALL 变为 ref 或 range,key 为新索引名,Extra 里不再出现 Using filesort 或 Using temporary,或改为 Using index 表示覆盖索引生效。第二层看实际行数:同一 digest 在 performance_schema.events_statements_summary_by_digest 中的 SUM_ROWS_EXAMINED 应明显收敛到与命中行数相当的量级,而不是继续接近表总行数。第三层看慢日志:同一条 SQL 不再出现在 slow_query_log_file 或 mysql.slow_log 中,或 Query_time 已低于 long_query_time。
正常结果的样子是:预估 rows 与实际 rows 接近、扫描行数与返回行数差距缩小、排序不再产生临时表。如果 EXPLAIN 变好了但慢日志里 SQL 照旧出现,通常说明瓶颈不在扫描路径上,需要回头看锁等待或返回行数本身,这部分要结合具体环境确认,不能只凭执行计划下结论。另外,测试库数据量远小于线上时,优化器的选择可能完全不同,验证尽量在量级接近的数据上做。