搜「AI视频提示词怎么写吸引人」的人,往往已经会写文生图提示词,卡在生成出来的视频动得乱、主体半路变形、没有镜头感。吸引人的关键不是形容词堆得多,而是把「谁、做什么、在哪、怎么拍、什么光」拆成可执行短句,一条动作对应一个镜头,再让时长、比例、运镜幅度这些参数不和文字打架。下面按实际排查顺序写:先确认版本、额度、入口,再按骨架走最短路径,最后是三个最常见的卡点和检查位置。
判断标准很简单:一条提示词只能有一个主要动作,且能被当前模型版本和时长装下。适用场景是文生视频、图生视频的单条试跑;操作上先固定 seed、每次只改一个变量;验证方式是同一条提示词只改一处,看两版差异是否来自这一处;边界是各平台对运镜、首帧、时长、运动幅度的支持不同,具体限制以创作页的参数项和接口文档里的 model 参数说明为准,这些会随版本调整,需要现场确认。
AI视频提示词之前先确认这三件事
提示词写得再好,版本、额度、入口有一个不对,生成结果就不受你控制。三件事都能在动手前两分钟确认完。
- 版本:先看当前选的是哪个模型版本、是文生视频还是图生视频。网页端在创作页顶部的「模型 / 版本」下拉项里看,下拉文字就是当前生效版本名;接口调用看请求体里的
model字段。不同版本对运镜描述、首尾帧、最长时长的支持差别很大,图生视频版本里主体外观基本由首帧图决定,文字描述只影响运动和氛围。 - 权限与额度:账户页的积分 / 额度面板或会员权益页能看到剩余次数和单次最长时长;走接口的话在控制台的密钥页确认已开通、密钥有对应模型权限。没有余额时通常会在提交后返回额度类错误,而不是在编辑页提示,所以提前看一眼比写完再报错省事。
- 入口位置:确认你进的是「文生视频」还是「图生视频」入口、是网页创作页还是接口。上传了首帧图却停在文生视频入口,文字里的外观描述会被当成主体来源,结果和预期完全两回事。
AI视频提示词:最短可用路径
从入口到跑通,只需四步,每步做完都有一个能看见的结果。
- 选版本并记录:在创作页顶部模型下拉选定版本,做完应看到「模型」项显示所选版本名,右侧参数面板同步出现时长、比例、运动幅度等可选项。
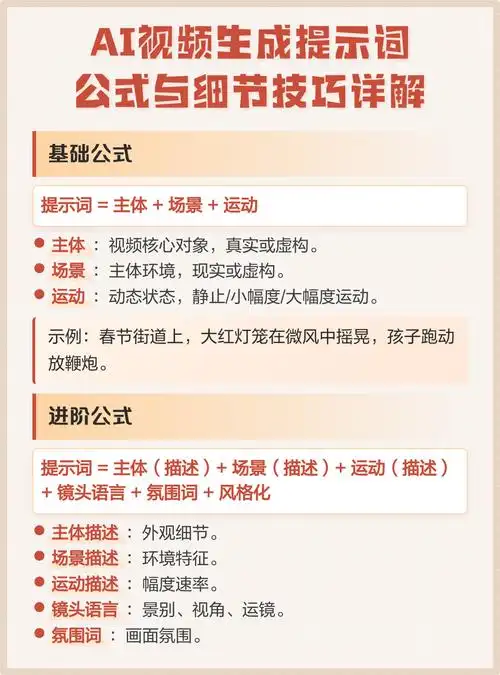
- 套五段式骨架:每行一个要素,只写必要信息,模板可直接复制改括号内容。
- 设参数:比例、时长、运动幅度、随机种子先固定为同一组值,做完应看到参数面板上数值稳定不再自动跳变。
- 单变量对比:先生成一条短时长、低幅度的版本,确认首帧和动作方向正确,再只改一处(例如把「缓慢推近」改成「固定机位」)重新生成一次。
主体:<一位穿深灰风衣的中年男人>
动作:<从画面左侧缓步走向镜头,右手抬到胸前>
环境:<雨后夜间的旧城街道,地面有反光水渍,远处招牌虚化>
镜头:<中景,缓慢推近,机位略低于视线>
光线与色调:<冷蓝主光加招牌暖光边缘,低饱和>
风格:<写实电影感,浅景深,轻微胶片颗粒>
负面:<不要文字水印,不要多余手指,不要快速闪切>
接口调用骨架可参照下面的结构,字段名和必填项以你实际使用的接口文档为准,不要照抄:
{
  "model": "<当前版本名,取自创作页下拉或文档 model 说明>",
  "prompt": "<上面的五段式文本,合并为一段>",
  "negative_prompt": "<负面描述>",
  "duration": 5,
  "aspect_ratio": "16:9",
  "seed": 12345
}
提交后先看返回的状态码和任务 ID,再看生成结果的首帧;首帧不对,后面的运镜和风格都白调。
AI视频提示词:一个真实场景的完整做法
场景:把 12 张白底平铺的女装外套商品图做成动态展示视频,单条 5 秒,用于详情页首屏。对象是固定机位拍摄的白底平铺图,素材 1:1,主体居中、四周留白。做法是先拿 1 张做通,再批量剩下的 11 张。
- 入口选「图生视频」,上传第 1 张平铺图作为首帧。上传控件在创作页左侧素材区,上传后缩略图应出现在首帧位置。
- 提示词只写运动与氛围,不重复描述衣服颜色和款式,外观交给首帧图:
镜头固定,衣服轻微飘动,光影从左上方缓慢扫过,棚拍质感,白底干净。提示词输入框在页面中部。 - 参数:时长 5 秒、比例 9:16、运动幅度选低、随机种子填固定值。三项都在右侧参数面板设置,改完后生成结果里的主体位置应基本不动。
- 验证:同一张图跑两版,只把运动幅度从低改成中,比较晃动程度;确认低幅度这一版可接受后,用同一组参数批量处理剩余 11 张。
批量前先确认账户额度够 12 次,额度不足会在中途返回错误,已生成的记录不受影响但需要重新排队。
AI视频提示词:跑不通先查这三处
按出现频率从高到低排,前两处占绝大多数。
- 主体变形或动作一闪而过。常见页面提示是生成成功但结果与描述不符。原因基本是提示词里写了两三个动作。检查位置是提示词文本本身:数一下动词数量,压到只剩一个,再看是否还变形;同时把「跑、转身、挥手」这类连续动作拆成多条独立生成。
- 提交后被拒,提示内容不合规或输入包含敏感内容。检查位置是提示词里的品牌名、真实人名、明星姓名、暴力与血腥词。把这些替换成描述性表述,例如用「某运动品牌风格」改为「无标识的运动风外套」;负面描述尽量用正面词表达想要的效果,而不是罗列禁止项。
- 上传了图,文字描述却被忽略。检查两处:一是入口是否选成了文生视频,二是
model字段填的是否为图生视频版本。图生视频里主体外观由首帧决定,若外观只写在文字里、首帧图上没有,模型通常不会补出来。判断方法是把提示词里的外观句删掉再跑一次,结果不变就说明文本外观描述本来就没起作用。
时长上限、并发数、额度规则这类会变的参数,不要在提示词里猜,直接看账户页的额度面板和接口文档里的模型与限额说明页,以你当前账号实际显示的数值为准。