看 Java GC 日志,有用的顺序通常是:先确认日志真的写进了文件,再核对当前用的收集器和堆参数,然后判断 Full GC 之后老年代是否回落,最后才看单次停顿有没有超出业务能容忍的上限。跳过前两步直接读停顿毫秒数,很容易把「分配速率高」误判成「内存泄漏」。下面给出一条能照着做完的路径,涉及的参数、命令和日志字段都以 JDK 版本为前提,不同版本写法不一样,需要先确认再套用。
判断 GC 日志建议按四步走:日志位置是否落实、收集器与堆参数是否核对、Full GC 后老年代是否回落、单次停顿是否超出业务容忍。Full GC 次数多不等于内存泄漏,多数情况要先分清是分配速率快还是老年代真的回收不掉。改堆参数前,建议用同一份日志做前后对比,否则容易把问题从一个场景挪到另一个场景。堆外内存、直接内存不属于 GC 日志的可见范围,看到「日志一切正常但进程还是涨」时要换方向查。
Java GC日志:先把能核对的事实摆清楚
在讨论「GC 有没有问题」之前,先固定三件能核对的事实:JDK 版本、当前生效的收集器、GC 日志的实际落盘位置。这三项决定了参数怎么写、日志行长什么样,写错了后面全白看。
# 列出本机 Java 进程,拿到 PID
jcmd -l

# 版本与运行参数(两个都能核对)
jcmd <pid> VM.version
jcmd <pid> VM.flags

# 当前堆的实际情况
jcmd <pid> GC.heap_info
日志位置分两种情况:JDK 9 及以上由统一日志参数 -Xlog:gc*:file=... 指定;JDK 8 由 -Xloggc: 指定。如果这两个参数都没配,GC 输出通常混在标准输出里,容器环境下会落到 docker logs 或 catalina.out、nohup.out 这类文件,并随应用日志一起被轮转截断。
能核对的现象都写在日志行的字段里,以 G1 为例大致是这种结构(下面数值只是格式示例):
[时间戳][运行秒数][info][gc] GC(123) Pause Young (Normal) (G1 Evacuation Pause) 512M->128M(2048M) 12.345ms一行里能读到的信息是:发生时间、GC 序号、停顿类型(Young / Full / Concurrent 等)、回收前后的堆占用(箭头左侧用完、右侧回收后)、堆总容量、本次停顿毫秒数。只读这几个字段就够做初步判断,不需要先记住所有子类型名称。
Java GC日志最容易搞错的一点
最常见的误解是:看到日志里出现 Pause Full,或者 jstat 的 FGC 列在涨,就断定「内存泄漏」,直接去把 -Xmx 调大。调大堆往往只是把 Full GC 往后推,分配速率高的情况下照样会再次堆满,反而让单次停顿更久。
判断分界其实只有一条:这一次 Full GC 结束后,老年代占用有没有明显回落到之前的基线。回落了,说明对象确实能被回收,问题在于分配或晋升速度;不回落、而且每次 Full GC 后的水位一次比一次高,才需要往「对象被长期引用住」的方向查。
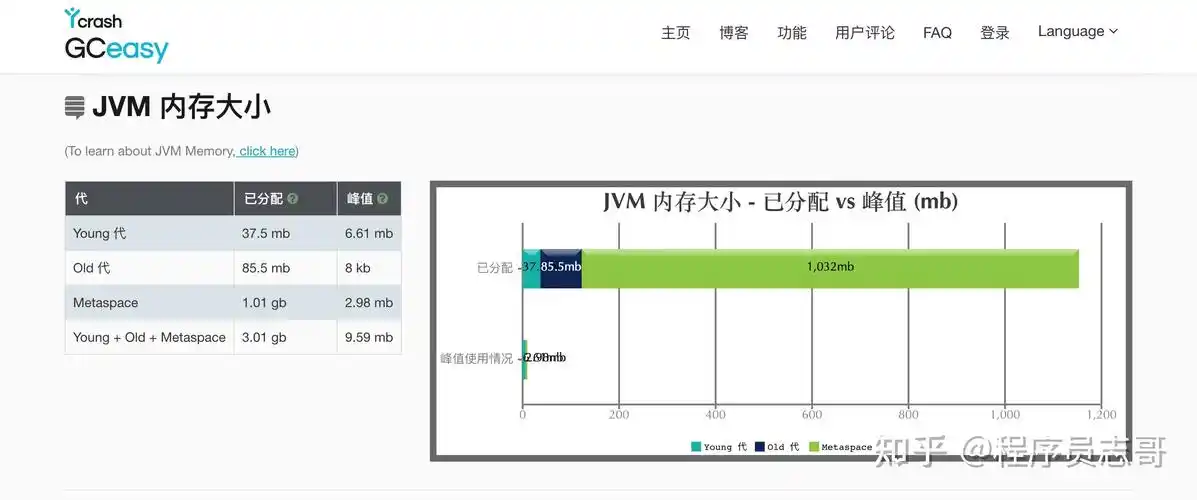
能把两种情况区分开的检查动作,是取一次 Full GC 前后的老年代数字做对比:
# 每秒一次连续采样,重点看 O(老年代使用率)和 FGC 两列
jstat -gcutil <pid> 1000 20
在 FGC 从 n 变成 n+1 的那一行前后,比较 O 列的数值;或者直接在日志里找 Pause Full 行,看箭头右侧的数字。箭头右侧在多次 Full GC 之间基本稳定,指向分配速率;持续抬高,指向对象回收不掉。用 jcmd <pid> GC.class_histogram 看对象构成也可以,但它会触发 STW,不建议在业务高峰随手执行,这就是这一步的风险边界。
Java GC日志:一个照着就能做完的做法
下面是一条完整路径,按顺序做完即可拿到可判断的日志。第 1 步要按 JDK 版本二选一,不要两套参数混着加。
# 第 1 步:加参数(写进启动脚本或 JAVA_OPTS)
# JDK 9 及以上
-Xlog:gc*:file=/var/log/app/gc.log:time,uptime,level,tags:filecount=5,filesize=20m

# JDK 8
-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/var/log/app/gc.log
-XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=5 -XX:GCLogFileSize=20M
这一步该看到什么:重启后 /var/log/app/gc.log 存在,并且文件大小在缓慢增长。JDK 8 只写 -Xloggc 而不加轮转参数,文件会一直增大直到占满磁盘,这是要提前避开的。
# 第 2 步:核对参数是否真的生效
jcmd <pid> VM.flags | tr ' ' '\n' | grep -i -E 'loggc|Xlog|MaxHeapSize|Use.*GC'
tail -n 20 /var/log/app/gc.log
该看到什么:grep 结果里能查到刚才加的日志参数和堆大小;tail 能看到带时间戳的最新 GC 行。如果 tail 没有任何输出,先查目录写权限和容器内路径是否挂载出来,而不是继续往下读日志。
# 第 3 步:观察节奏,同时确认日志确实在增长
jstat -gcutil <pid> 1000 30
wc -l /var/log/app/gc.log
该看到什么:YGC、YGCT 随时间增长,O 列在两次 Young GC 之间有升有降;两次 wc -l 的行数不同,说明日志正在写入。
# 第 4 步:统计 Full GC 次数和最长的几次停顿
# 注意:不同收集器和 JDK 版本的停顿单位可能是 ms 也可能是 s,先用第 2 步的 tail 样本确认

grep -c 'Pause Full' /var/log/app/gc.log
grep 'Pause' /var/log/app/gc.log | tail -n 5
grep -o '[0-9.]*ms' /var/log/app/gc.log | tr -d 'ms' | sort -n | tail -n 5
该看到什么:第 3 条输出是日志里最大的几个停顿毫秒值,前提是日志中停顿统一以 ms 结尾;如果样本里出现秒单位,先统一换算再比较,不要直接拿两种单位的数字排序。
Java GC日志:怎么验证结果对不对
验证分两层:先验证日志本身可信,再验证结论站得住。
日志可信的验证方式是采样两次行数,命令在第 4 小节;两次之间行数没有变化、而进程仍在正常跑,就说明日志没写成功或已被轮转走,这时候任何停顿统计都不作数,需要回到第 2 步查路径。
结论可靠的验证方式是看同一条判据在整份日志里是否稳定,而不是只看最近几行:
# 最近若干次 Full GC 的回收后占用,看是否一次比一次高
grep 'Pause Full' /var/log/app/gc.log | tail -n 20

# 有没有多次 Full GC 紧挨着发生(GC 序号连续、时间戳间隔很小)
grep 'Pause Full' /var/log/app/gc.log | tail -n 5
正常结果长这样:Young GC 间隔基本稳定,没有明显越来越密的趋势;每次 Full GC 后老年代回落到接近同一水位;Full GC 之间有明显间隔,不是连续贴着出现;最大的几次停顿毫秒数低于业务请求超时或心跳间隔留出的余量——这个上限要按自己系统的超时配置定,没有通用数值。
改完参数后对比时,建议取同一业务时段的日志做前后比较,用凌晨低谷对比白天高峰会得出错误结论;同时至少覆盖一个完整的业务高峰周期再看,单次采样不足以判断。如果日志各项都平稳但进程内存仍在上涨,方向应转向堆外内存和直接内存,GC 日志看不到这部分。