先去确认当前遇到的到底是哪一种“内存溢出”。Redis 的常见表现有三类:达到 maxmemory 后写请求被拒(返回 OOM command not allowed when used memory > 'maxmemory')、进程 RSS 涨到接近物理内存被系统 OOM killer 杀掉、以及数据本身不大但 used_memory_rss 明显高于 used_memory 的碎片问题。三类问题的处理方向完全不同,先用下面的命令把类别判定出来,再决定改配置、删数据还是整理碎片。
判断顺序建议是:先看 INFO memory 里 maxmemory 是否非 0 且 used_memory 已贴合上限,再看应用日志里是否出现 OOM command not allowed,两者都成立属于淘汰策略层问题;maxmemory 为 0 或远高于实际使用、系统日志出现 oom-killer 记录,则属于进程层问题;used_memory 平稳但 fragmentation ratio 偏高,按碎片处理。改配置前先记录原值,改完观察覆盖一个完整业务高峰再判定是否解决。
Redis内存溢出怎么排查和解决
“排查和解决”对应的是整条链路里“定性 + 定位 + 处置”这一段,前置动作是确认现象确实来自内存上限,而不是网络超时、主从切换或客户端连接池耗尽。确认方法很具体,跑一条命令拿到关键指标:
redis-cli -p 6379 info memory | grep -E 'used_memory:|used_memory_rss:|used_memory_peak:|maxmemory:|maxmemory_policy:|mem_fragmentation_ratio:'判断依据:maxmemory 非 0 且 used_memory 贴着它走,同时应用侧出现 OOM command not allowed,就是命中上限后写入被拒;maxmemory 为 0 表示不限制,此时要去看宿主机 free -m 与 dmesg -T | grep -i 'oom',确认 Redis 进程是否被系统杀掉;used_memory_rss 明显大于 used_memory 时,问题更可能是分配器碎片而不是键值总量。日志位置由配置项 logfile 决定,包管理器安装的常见路径是 /var/log/redis/redis-server.log 或 /var/log/redis/redis.log,容器环境用 docker logs 容器名 或 kubectl logs pod名,以实际 CONFIG GET logfile 的返回为准。
Redis内存溢出先定位在哪一层
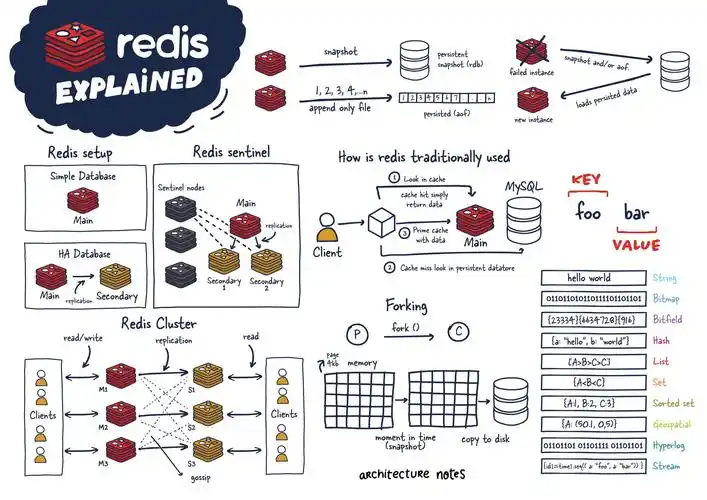
Redis 内存上涨可能发生在四个层,改动之前先判断落在哪一层,否则会出现改完 maxmemory 问题依旧的情况。
- 连接与缓冲区层:检查位置是
redis-cli client list里的omem、qbuf字段,以及CONFIG GET client-output-buffer-limit。判断依据是单个客户端 omem 持续偏高、连接数远超预期,常见于订阅客户端消费慢或长时间挂着 MONITOR。 - 数据层:检查位置是
DBSIZE、redis-cli --bigkeys、MEMORY USAGE 键名。判断依据是键数量持续增长、存在单个超大 hash/list/zset,或大量键没有设置 TTL。用redis-cli --scan --pattern '*' | head -20配合TTL抽查可以确认过期策略是否真的生效。 - 淘汰策略层:检查位置是
CONFIG GET maxmemory maxmemory-policy与INFO stats中的evicted_keys。判断依据是策略为noeviction时一旦触顶直接拒写,而 volatile-* 系列在没有可淘汰键时也会拒写。 - 进程与系统层:检查位置是宿主机
free -m、cat /proc/$(pgrep -f redis-server)/status | grep -E 'VmRSS|VmSwap'、MEMORY STATS中的 allocator 部分。判断依据是 RSS 虚高、swap 被占用,或执行 BGSAVE / AOF rewrite 时因 fork 写时复制出现阶段性上涨。
Redis内存溢出:先看这四个位置
按下面的顺序看,基本能在短时间内区分问题归属,避免在无关方向上来回改。
- 日志:
grep -iE 'oom|maxmemory|killed|warning' /var/log/redis/redis-server.log | tail -50。容器环境替换为kubectl logs pod名 --tail=200 | grep -i oom。同时看系统日志dmesg -T | grep -i oom或journalctl -k | grep -i 'out of memory',这里能看出是否发生过内核杀进程。 - 命令输出:
redis-cli info memory、redis-cli memory stats、redis-cli memory doctor、redis-cli --bigkeys、redis-cli slowlog get 20。memory doctor 会给出偏向性的提示,适合作为初筛。执行--bigkeys会做一次全量扫描,建议在从节点或低峰期运行。 - 配置项:
redis-cli config get maxmemory、config get maxmemory-policy、config get maxmemory-samples、config get client-output-buffer-limit、config get appendonly。注意主从或集群模式下各节点配置可能不一致,需要逐节点确认。 - 面板字段:云托管实例的控制台一般提供内存使用量、内存使用率、已用内存与规格上限、连接数、慢日志、Key 数量等字段;自建监控用 redis_exporter 时对应
redis_memory_used_bytes、redis_memory_max_bytes、redis_mem_fragmentation_ratio、redis_evicted_keys_total。字段名称以所用控制台或 exporter 版本为准,先确认指标含义再下判断。
Redis内存溢出:按可能性从高到低排除
下面几类成因按现场出现频率排序,每条都给出能直接执行的确认动作。
- maxmemory 未设置或策略是 noeviction。确认:
redis-cli config get maxmemory maxmemory-policy。处理是先估算常驻数据量再设置 maxmemory,并选择与业务匹配的策略;可淘汰缓存用 allkeys-lru 或 allkeys-lfu,不允许丢数据的场景应扩容或拆分实例,不要指望用淘汰策略掩盖容量不足。 - 数据量真实增长,写入无 TTL。确认:
redis-cli dbsize连续观察两次间隔内的增长,配合--bigkeys定位大键。处理方向是给写入路径补过期时间、清理无主键、把大集合拆成多个分片键。 - 大 key 拖累淘汰与删除。确认:
redis-cli memory usage 键名,或用--memkeys排序(该选项需较新版本,先执行redis-cli --help | grep memkeys确认可用)。处理时用UNLINK替代DEL做异步释放,避免删除大键阻塞主线程。 - 客户端输出缓冲堆积。确认:
redis-cli client list | head -30看 omem 排名,结合config get client-output-buffer-limit与订阅客户端数量。处理是给订阅消费加限流、限制 MONITOR 使用时长、按需收紧 normal/pubsub 的缓冲上限。 - 内存碎片。确认:
INFO memory中 fragmentation ratio 持续偏高,MEMORY STATS里 allocator 的碎片字节数明显。处理可先执行MEMORY PURGE尝试归还空闲页,或在维护窗口开启activedefrag yes并配合阈值参数;碎片整理会带来额外 CPU 开销,需要评估。 - 持久化与主从相关开销。确认:执行 BGSAVE 或 AOF rewrite 期间观察
INFO memory与INFO persistence中的rdb_last_cow_size、aof_rewrite_scheduled。处理方向是错开备份时间、控制实例数据规模、避免长时间高写入频率下频繁重写。
Redis内存溢出:改完怎么确认真的解决了
改完不能只看一次结果,要按指标趋势判断。持续观察这几项:
watch -n 10 "redis-cli info memory | grep -E 'used_memory:|used_memory_rss:|maxmemory:'"
redis-cli info stats | grep -E 'evicted_keys:|expired_keys:|keyspace_hits:|keyspace_misses:'
redis-cli info commandstats | grep -E 'cmdstat_set|cmdstat_get'
redis-cli --latency -p 6379
判断标准:used_memory 稳定在 maxmemory 之下且不再持续爬升,应用日志中不再出现 OOM command not allowed,evicted_keys 的增长速率回落到可接受水平,内存使用率曲线在业务高峰后能自行回落。观察时长建议覆盖一个完整业务周期(通常是高峰加低谷的一整天),跨天不稳定说明还没改到位。开启 activedefrag 的实例,还要确认 CPU 使用率没有明显抬升。
回滚办法要提前准备好:修改前用 redis-cli config get maxmemory 记录原值并写入变更单;通过 CONFIG SET 做的调整只在运行时生效,重启后回到配置文件的值,因此配置文件需同步修改并备份。CONFIG SET 回滚规则是:执行 redis-cli config set maxmemory 原值,再把 maxmemory-policy 改回原策略。如果已经改过配置文件并需要回滚,恢复备份文件后重启实例,但重启会按持久化文件重新加载数据,务必先确认 RDB 或 AOF 状态正常,并在低峰期操作。开启过 activedefrag 的实例回滚用 CONFIG SET activedefrag no,之后观察碎片率是否重新抬头,必要时改为在维护窗口集中处理。