搜「Java OOM 怎么排查」的人,通常已经看到了 java.lang.OutOfMemoryError,或者进程毫无征兆地重启、消失。这时最先要做的不是调大 -Xmx,而是分清这次 OOM 发生在哪一层:JVM 堆内空间耗尽、堆外空间(Metaspace、直接内存、线程栈)耗尽、进程或容器被系统终止,还是虽然不是内存问题、也被误当成内存问题来治。层判断错了,参数越调越乱。下面按实际排查的先后顺序,给出命令和判断依据。
建议的判断顺序是:先在应用日志里确认 OutOfMemoryError 的具体文案(Java heap space、Metaspace、Direct buffer memory、unable to create new native thread 等),再用jcmd、jstat查看堆和元空间的实际占用,最后对照容器的 memory 限制以及宿主机上的 dmesg,确认有没有被内核 OOM Killer 杀掉。文案不同,处理方向完全不同;如果是容器层被杀,改 JVM 参数通常无效,应该先核对堆内和堆外各自使用的总内存与 limit 的关系。
Java OOM先定位在哪一层
先分级,再动手。下面这张判断清单按「现象 → 检查位置 → 判断依据」组织,逐条排除即可:
- 堆内耗尽:日志文案为
java.lang.OutOfMemoryError: Java heap space或GC overhead limit exceeded。检查jcmd <pid> GC.heap_info与jstat -gcutil <pid>,判断依据是多次 Full GC 之后老年代占用列(O,也就是 Old 区使用率)仍接近满值、不回落。 - 元空间/类元数据耗尽:文案为
Metaspace或Compressed class space。检查jcmd <pid> VM.metaspace(部分 JDK 版本没有该子命令,可改看jcmd <pid> VM.native_memory summary),判断依据是 Metaspace 只涨不跌,且与动态生成类、热部署、脚本引擎的使用节奏对得上。 - 直接内存/本地内存耗尽:文案为
Direct buffer memory,或堆看起来正常但进程 RSS 持续上涨。检查jcmd <pid> VM.native_memory summary,判断依据是 Internal、Other 段落持续增长,常见于 Netty、NIO 相关代码路径。 - 线程创建失败:文案为
unable to create new native thread。检查jstack <pid> | grep -c 'java.lang.Thread.State'和ulimit -u,判断依据是线程数接近系统上限,或线程池没有设置上限。 - 容器/宿主层被杀:进程直接消失,应用日志里没有 OOM 异常。检查
kubectl describe pod <pod>里 Last State 是否显示OOMKilled、Exit Code 是否为 137,并在宿主机执行dmesg -T | grep -i -E "killed process|out of memory"。判断依据是内核日志里有杀掉该进程的记录。
Java OOM:先看这四个位置
四类信息源按顺序查,基本能覆盖绝大多数情况:
- 应用日志。取完整路径,不要凭印象:
grep -n "OutOfMemoryError" /path/to/app.log,同时查看 JVM 崩溃文件ls -lt /path/to/workdir/hs_err_pid*.log(路径由-XX:ErrorFile决定),以及堆转储文件ls -lh /path/to/dump/java_pid*.hprof(由-XX:HeapDumpPath决定)。 - 命令输出。先执行
jps -l拿到 pid,再依次执行jcmd <pid> VM.flags(确认实际生效参数)、jcmd <pid> GC.heap_info、jstat -gcutil <pid> 1000 20(观察 GC 频率和老年代变化趋势)。 - 配置项。容器侧
kubectl get pod <pod> -o jsonpath='{.spec.containers[*].resources}';JVM 侧重点看-Xms、-Xmx、-XX:MaxMetaspaceSize、-XX:MaxDirectMemorySize、-Xss是否设置,以及jcmd <pid> VM.flags输出的实际值(命令行参数可能被启动脚本覆盖)。 - 面板字段。容器内直接读 cgroup:
cat /sys/fs/cgroup/memory.max、cat /sys/fs/cgroup/memory.current、cat /sys/fs/cgroup/memory.events(cgroup v1 对应/sys/fs/cgroup/memory/memory.limit_in_bytes等);监控面板则关注堆使用量曲线、Full GC 次数、线程数、容器 working set 是否与 limit 贴合。
Java OOM:按可能性从高到低排除
以下是常见成因的排序,每个都给一个能确认或排除它的动作:
- 堆内对象持续增长(泄漏或缓存无上限)。确认动作:
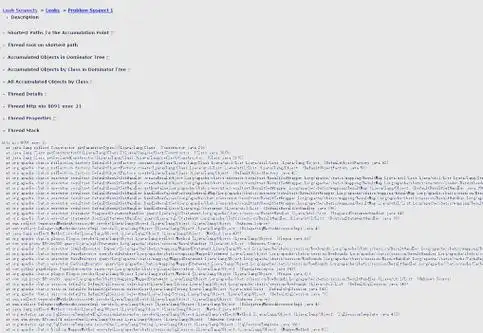
jcmd <pid> GC.heap_dump /data/dump/heap-$(date +%F-%H%M).hprof导出后,用 MAT 或jhat类工具查看 Dominator Tree。处理方向是找出持有链,给缓存加容量上限或过期策略。 - 单次大对象或大结果集。确认动作:
jmap -histo:live <pid> | head -30,看前几名是否为巨量byte[]、String、HashMap$Node。常见于一次性导出、全表查询、批量文件加载,处理方向是改分页、流式读取。 - 元空间增长。确认动作:
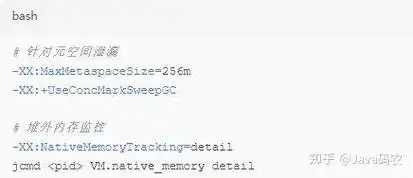
jcmd <pid> VM.metaspace隔一段时间看两次总量;如果与反射、动态代理、脚本编译相关,先给-XX:MaxMetaspaceSize设定明确上限,让问题尽早暴露,而不是无限膨胀。 - 直接内存。确认动作:对比
jcmd <pid> VM.native_memory summary的 Internal、Other 与堆占用;未显式设置-XX:MaxDirectMemorySize时,建议显式设置,便于观察。 - 线程数过多。确认动作:
jstack <pid> | grep -c 'java.lang.Thread.State'统计线程总量,并检查线程池是否有界队列。 - 容器 limit 小于堆内与堆外占用之和。确认动作:把
-Xmx与 Metaspace、线程栈估算、直接内存相加,与memory.max对比,留出余量;否则会表现为 OOMKilled 而不是 Java 异常。
这里有一个容易踩的坑:jmap -histo:live 和带 live 的 dump 会触发 Full GC,业务高峰执行可能把勉强支撑的服务直接压垮,建议在低峰执行并先评估停顿影响。另一个坑是把容器被内核杀掉误判成“不是 OOM”——日志里没有 OutOfMemoryError 不等于没有内存问题,先看 Exit Code 137 和 cgroup 的 oom 计数。
Java OOM:改完怎么确认真的解决了
改参数或改代码后,建议至少做三件事,并覆盖一个完整的业务周期再下结论(例如日常一天加上一次批量任务或流量高峰,具体时长需要结合业务节奏确认):
- 确认 GC 行为。JDK 9 及以上加
-Xlog:gc*,gc+heap=debug:file=/data/logs/gc-%t.log:time,uptime:filecount=5,filesize=50m,JDK 8 用-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/data/logs/gc.log,然后用tail -f /data/logs/gc-*.log观察 Full GC 之后老年代是否明显回落。 - 确认占用趋势。定时执行
jstat -gcutil <pid> 60000 60,或抽查jcmd <pid> GC.heap_info;同时看cat /sys/fs/cgroup/memory.current是否持续爬升贴近memory.max。稳定期内的判断标准是:老年代在 GC 后能回落到合理区间,容器 working set 不呈单向上涨。 - 准备回滚。回滚前先留证据:
jcmd <pid> GC.heap_dump /data/dump/rollback-$(date +%F-%H%M).hprof;镜像或参数回退用kubectl rollout undo deployment/<name>,非容器部署则切回上一个 jar 包与旧启动脚本。上线前把旧镜像 tag、旧参数文件、旧配置一并存档,回滚步骤写进变更单,避免现场再拼参数。
需要说明的边界:堆 dump 体积通常接近堆上限,导出前确认磁盘剩余空间(df -h /data),否则失败会掩盖真正问题;另外临时调大 -Xmx 或加 swap 只是争取排查时间的临时手段,不是解决方案,最终仍需回到具体成因上处理。