搜「数据库备份方案有哪些」的人,通常不是想听概念分类,而是手里已经有一台在跑的库,需要在逻辑备份、物理备份、快照和主从延迟副本之间选一条能落地的路。先明确三个前提:你要备份的是哪个引擎(MySQL、PostgreSQL 还是其他)、能接受多长的恢复时间、备份文件放在本机还是异地。这三个前提没定,方案对比就没有意义。下面按排查顺序写:先摆事实,再讲最容易搞错的分界,然后给一条可以照着做完的路径,最后说怎么验证。
判断顺序建议是:先确认数据库引擎和版本,再确认备份工具是否已安装,然后区分「逻辑备份」和「物理备份」的适用场景。单库几十 GB 以内、需要跨版本迁移或只恢复单表,优先逻辑备份;数据量大、要求恢复时间短、需要整实例一致,优先物理备份或存储快照。无论选哪种,都要在一台非生产机器上完整恢复一次再算完成,只生成备份文件不算验证通过。版本、参数默认值和存储额度这类会变的内容,以你本机 --help 输出和云厂商控制台当前页面为准。数据库备份:先把能核对的事实摆清楚
先不下结论,只收集能核对到的信息。第一条是引擎和版本,这是决定用哪套工具的前提:
mysql --version
psql --version
# 进入实例后确认
SELECT VERSION();
第二条是工具是否在位。MySQL 系通常看 mysqldump、mysqlpump、xtrabackup;PostgreSQL 系看 pg_dump、pg_basebackup。用 which 确认路径,用 --help 确认当前版本支持哪些参数,不要凭记忆写参数。
which mysqldump xtrabackup pg_dump pg_basebackup
mysqldump --help | head -40第三条是数据量和磁盘余量。du -sh 看数据目录,df -h 看备份目标盘剩多少。逻辑备份的中间文件可能比数据目录还大,物理备份基本接近数据目录大小,这个量级要提前算。
第四条是现有的备份痕迹:crontab -l 有没有定时任务,备份目录里有没有近期文件,文件大小是否正常。空文件或几百字节的文件基本可以判定失败,但先记录下来,不做处理。
第五条是日志位置。MySQL 的错误日志路径可以用 SELECT @@log_error; 查,PostgreSQL 通常在数据目录的 log/ 下或由 log_directory 指定。备份失败的原因大多能在这些日志里找到原文,比猜参数快。
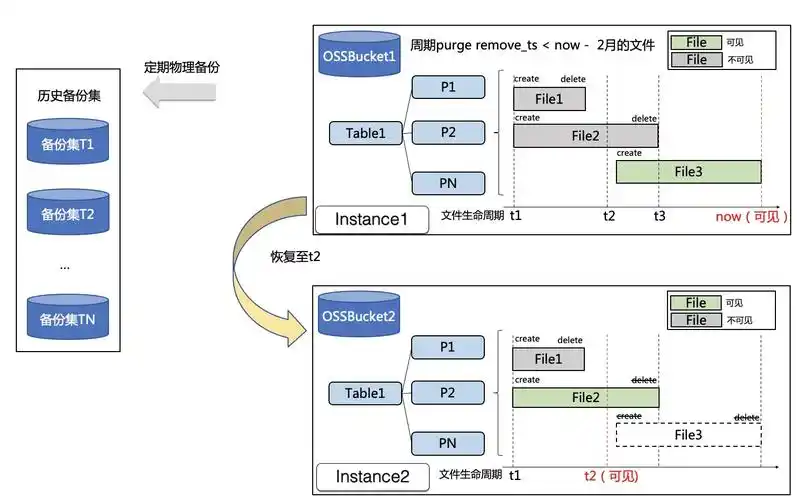
数据库备份最容易搞错的一点
最常见的误解是把「备份文件生成成功」当成「备份可用」。判断分界其实很清楚:备份文件能不能在一个干净的实例上被完整恢复出来,并读到表结构和数据。生成成功只说明导出进程没报错,不说明文件完整、不说明字符集和权限对象没丢、也不说明恢复时不会卡在某个参数上。
一个能区分两种情况的具体动作:把备份文件拷到另一台机器或另一个实例,实际执行一次恢复,然后核对表数量。以逻辑备份为例:
# 源库记下基线
mysql -uroot -p -N -e "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema='your_db';"

# 目标实例导入
mysql -uroot -p -e "CREATE DATABASE verify_db;"
mysql -uroot -p verify_db < backup.sql

# 恢复后对比
mysql -uroot -p -N -e "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema='verify_db';"
两边数字一致,且随便挑一张表能 SELECT 出数据,才算这次备份通过。数字对不上,问题在导出参数或权限,不在数据库本身。另一个常被忽略的分界是权限和存储过程:mysqldump 不加 --routines --triggers 时,这两类对象不会进备份文件,恢复后业务可能报「函数不存在」。
数据库备份:一个照着就能做完的做法
下面以 MySQL 单库逻辑备份为例,给一条完整路径。参数按用途标注,执行前把库名、账号、路径替换成你自己的。
# 1. 建备份目录并确认空间
export BK=/data/backup/mysql
export DB=your_db
mkdir -p $BK
df -h $BK

# 2. 执行逻辑备份
# --single-transaction: InnoDB 表在一致性快照下导出,不长时间锁表
# --routines --triggers --events: 带上存储过程、触发器、事件
# --default-character-set=utf8mb4: 避免中文乱码
mysqldump -uroot -p \
  --single-transaction \
  --routines --triggers --events \
  --default-character-set=utf8mb4 \
  $DB > $BK/${DB}_$(date +%F).sql

# 3. 压缩并确认文件大小
 gzip -f $BK/${DB}_$(date +%F).sql
ls -lh $BK
每一步该看到什么:第 1 步 df -h 的可用空间应明显大于数据目录大小;第 2 步命令正常结束、无报错输出,退出码为 0(用 echo $? 确认);第 3 步 ls -lh 能看到一个大小合理的 .sql.gz 文件,不是 0 字节。如果第 2 步报 Access denied,先查账号权限;报 Unknown table,查库名拼写和大小写敏感设置。
对于数据量较大的实例,逻辑备份恢复慢是常态,可以考虑 xtrabackup 做物理备份,或者用云数据库控制台自带的备份功能。这类功能的具体入口、保留天数和存储费用会随控制台改版变化,需要到对应产品的「备份与恢复」页面看当前字段,本文不写死。
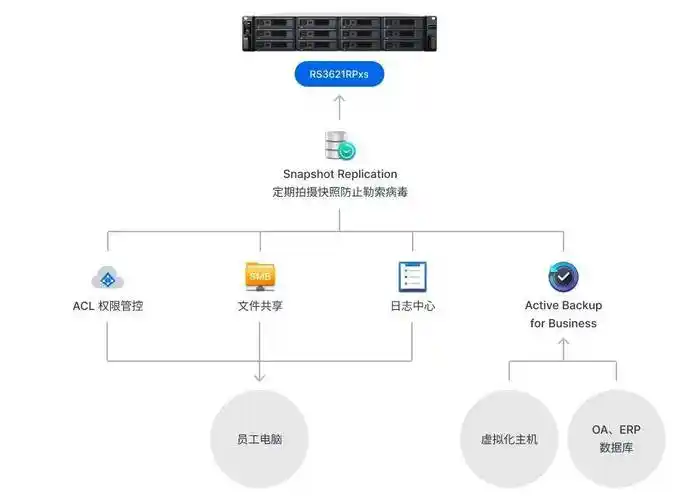
定时执行可以放到 crontab,但要加日志重定向,否则失败时无从查起:
0 2 * * * /bin/bash /data/scripts/mysql_backup.sh >> /var/log/mysql_backup.log 2>&1数据库备份:怎么验证结果对不对
验证分两层。第一层是文件层,确认备份文件存在、大小合理、能正常解压:
ls -lh /data/backup/mysql/
gzip -t /data/backup/mysql/your_db_YYYY-MM-DD.sql.gz
正常结果是 gzip -t 无任何输出、退出码为 0;有输出说明压缩包已损坏,这个备份作废,需要重跑。
第二层是恢复层,这是唯一有意义的验证。在非生产实例上导入,然后核对三件事:表数量是否与源库一致、任取一张核心表 SELECT COUNT(*) 是否接近预期、存储过程和触发器是否存在。
# 表数量
mysql -uroot -p -N -e "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema='verify_db';"

# 例程和触发器
mysql -uroot -p -N -e "SELECT ROUTINE_NAME FROM information_schema.routines WHERE routine_schema='verify_db';"
mysql -uroot -p -N -e "SELECT TRIGGER_NAME FROM information_schema.triggers WHERE trigger_schema='verify_db';"正常结果:表数量与源库基线一致,SELECT COUNT(*) 不报错且返回合理行数,例程和触发器列表非空(前提是源库本来就有)。只做第一层验证、不做恢复验证,等于没有验证;恢复这一步通常建议每月至少做一次,具体频率按数据重要程度定,不需要抄别人的周期。