遇到 Java 内存溢出,最简单的处理路径不是先改 JVM 参数,而是先用一条命令确认溢出类型和发生位置,再决定改配置、改代码还是加机器。多数线上问题卡在“看到 OutOfMemoryError 就加大 -Xmx”这一步,结果要么问题换个地方出现,要么重启后短时间又复发。可以先按下面的顺序执行,再对照日志判断。
Java 内存溢出最简单的处理顺序是:先从日志确认 OutOfMemoryError 的具体类型(Java heap space、Metaspace、GC overhead limit exceeded、unable to create new native thread 等),再用 jps、jstat、jmap 确认对应内存区的实际占用,然后才调整 -Xmx、-XX:MaxMetaspaceSize 或修复持有引用的代码。适用场景是有 JVM 日志和本机 shell 权限的 Linux 服务;验证方式是观察重启后 GC 日志里 Full GC 后老年代是否回落;风险边界是盲目加大堆会让单次 Full GC 停顿变长,swap 只能止血不能当解决方案。
Java内存溢出怎么解决方法Linux
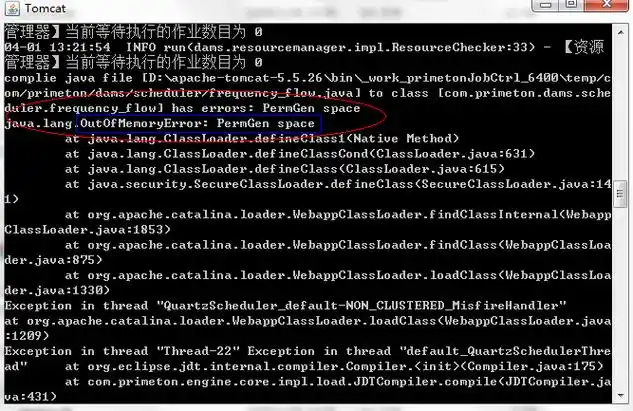
在 Linux 上,“Java内存溢出怎么解决方法”对应的第一步是拿到溢出类型,而不是直接改参数。溢出类型由 JVM 写进标准错误输出,通常落在应用日志、systemd 日志或 nohup 输出文件里。可核对的位置有三个:应用自己的日志文件(如 /opt/app/logs/error.log)、journalctl -u 服务名 --since "30 min ago"、以及启动脚本里重定向的 nohup.out。搜索关键字固定用 OutOfMemoryError,紧跟在后面的那一行才是判断依据,例如 java.lang.OutOfMemoryError: Java heap space 和 Metaspace 指向完全不同的处理方向。
确认进程和 JVM 参数用下面这组命令,先定位 PID,再确认当前堆上限,避免改了一个没生效的配置:
# 1. 找到 Java 进程
jps -l

# 2. 确认实际生效的堆参数(PID 换成上一步结果)
jinfo -flag MaxHeapSize <PID>
jinfo -flag InitialHeapSize <PID>

# 3. 看堆各区占用,每 2 秒一次,共 10 次
jstat -gcutil <PID> 2000 10

# 4. 在日志里定位溢出类型
grep -n "OutOfMemoryError" /opt/app/logs/error.log | tail -n 5
jstat -gcutil 输出里重点看 O(老年代使用率)和 F(Full GC 次数)。如果 O 长期接近 100 且 Full GC 后不回落,才说明是堆内存真实不足;如果 O 不高但 FGC 频繁,问题更可能出在对象创建速率或元空间。这一步不做,后面所有调参都是猜。
Java内存溢出先定位在哪一层
“Java内存溢出”不是单一问题,先判断它出在哪一层,才不会改错地方反复。可以按下表顺序核对,每层都有明确的检查位置和判断依据:
- 堆内存层:检查
jstat -gcutil <PID>的 O 列和jmap -histo:live <PID> | head -n 20。判断依据是占用最高的几个类是否与业务对象一致,是否出现某个集合类实例数异常偏大。 - 元空间/类加载层:检查
jinfo -flag MaxMetaspaceSize <PID>和日志中的Metaspace关键字。判断依据是是否伴随OutOfMemoryError: Metaspace,以及应用是否频繁热部署或动态生成类。 - 线程/本地内存层:检查
jstack <PID> | grep -c "java.lang.Thread.State"和ulimit -u。判断依据是日志是否为unable to create new native thread,以及线程数是否接近系统上限。 - 直接内存层:检查启动参数里是否有
-XX:MaxDirectMemorySize,以及日志是否出现Direct buffer memory。判断依据是 NIO、Netty 类应用大量使用堆外缓冲区。
四层确认完再动手。把堆溢出当成元空间问题去调 -XX:MaxMetaspaceSize,或者把线程数问题当成堆不足去加 -Xmx,都是最常见的返工原因。
Java内存溢出:先看这四个位置
排查时优先看这四个位置,每个都写清完整路径或命令,不要用“查看相关日志”带过。
第一,日志文件。位置通常是应用配置里指定的日志目录,例如 /opt/app/logs/ 下的 error.log 或 catalina.out,systemd 托管的服务用 journalctl -u 服务名 | grep OutOfMemoryError。要拿到的是溢出类型那一行,不是整段堆栈。
第二,命令输出。依次执行 jps -l、jstat -gcutil <PID> 2000 10、jmap -histo:live <PID> | head -n 20。这三个命令分别回答“进程是谁”“堆各区是否已满”“谁占了最多内存”。jmap -histo:live 会触发一次 Full GC,在低峰期执行更稳妥。
第三,配置项。检查启动脚本或容器环境变量中的 -Xms、-Xmx、-XX:MaxMetaspaceSize、-XX:MaxDirectMemorySize。用 jinfo -flags <PID> 确认实际生效值,因为脚本里写的参数可能被环境变量或容器限制覆盖。Kubernetes 环境还要确认容器 memory limit,堆上限不应等于容器上限。
第四,面板字段。如果有 JVM 监控面板,看老年代使用率、Full GC 次数与耗时、堆外内存、线程数四个字段。没有面板就用 jstat 的输出替代,不要为了排查临时搭一套监控。
Java内存溢出:按可能性从高到低排除
按常见程度排序逐个排除,每个成因配一个能确认或排除它的动作:
- 堆上限确实不够。确认动作:
jstat -gcutil中 O 列长期高位且 Full GC 后不回落。处理:在确认物理内存有余量的前提下上调-Xmx,同时把-Xms设为相同值,避免堆反复伸缩。 - 代码持有对象未释放。确认动作:
jmap -histo:live <PID>观察某个业务类实例数是否远超预期,必要时用jmap -dump:live,format=b,file=/tmp/heap.hprof <PID>导出堆快照,用 MAT 或 JProfiler 看支配树。处理:定位静态集合、缓存未设上限、监听器未注销这三类常见写法。 - 元空间不足或类加载泄漏。确认动作:日志出现
Metaspace关键字,且jstat -gc中 MC/MU 接近上限。处理:设置合理的-XX:MaxMetaspaceSize,排查频繁动态生成类的框架配置。 - 线程数超限。确认动作:日志为
unable to create new native thread,jstack <PID> | wc -l显示线程数异常多。处理:检查线程池是否无界、是否有阻塞后不断新建线程的逻辑,同时核对ulimit -u。 - 堆外内存泄漏。确认动作:堆使用正常但进程 RSS 持续上涨,日志出现
Direct buffer memory。处理:检查 Netty 的 ByteBuf 释放、NIO 缓冲区是否被正确回收,并显式设置-XX:MaxDirectMemorySize。
一个容易踩的坑:直接在启动脚本里加 -XX:+HeapDumpOnOutOfMemoryError 却没有设置 -XX:HeapDumpPath,溢出时堆快照会写到工作目录,而该目录所在分区往往空间不足,导致 dump 失败甚至引发二次问题。建议同时指定路径并预留足够磁盘空间,例如 -XX:HeapDumpPath=/data/dump/。
Java内存溢出:改完怎么确认真的解决了
改完配置或代码后,先重启服务,再用同一组命令观察:jstat -gcutil <PID> 5000 12,看 O 列是否在 Full GC 后明显回落、F 列增速是否放缓;同时用 grep -c "OutOfMemoryError" 日志路径 确认新日志中没有再出现溢出。如果开了 GC 日志(-Xlog:gc*:file=/data/logs/gc.log:time,JDK 8 用 -XX:+PrintGCDetails),可以直接看每次 Full GC 前后的老年代占用。
观察时长按业务周期判断:至少覆盖一个完整的业务高峰,通常建议观察一到两个自然日再撤掉临时监控。只看了十分钟没有报错就认为解决,容易在下一个高峰复发。另外,如果调大了 -Xmx,要同步确认机器剩余内存和容器 memory limit,堆上限超过可用物理内存会引入 swap,表现为 GC 时间变长而不是溢出,这是另一种形式的变慢。
回滚办法要提前写好:修改启动脚本前先备份,例如 cp /opt/app/bin/start.sh /opt/app/bin/start.sh.bak;确认无效时执行 cp /opt/app/bin/start.sh.bak /opt/app/bin/start.sh 并重启服务。容器环境则回退到上一个镜像 tag 或上一版 Deployment 配置。回滚后同样用 jinfo -flag MaxHeapSize <PID> 确认参数回到原值,避免只改了文件但没真正重启。