搜「容器化部署流程是什么意思」的人,通常卡在一个很具体的岔口:手上已经写了 Dockerfile,也知道 docker run 能跑,但不确定「部署流程」到底指写镜像、指 CI 流水线、还是指上 K8s。先给一个能落地的定义:容器化部署流程指的是把「构建镜像 → 推送镜像仓库 → 目标环境拉取并运行 → 出问题回滚到上一个镜像」这条链路固定成可重复执行的步骤,任何人都能按同样顺序做一遍,得到同一个运行结果。它解决的问题不是「怎么把程序塞进容器」,而是「换一台机器、换一个人、隔一周再发布一次,结果还能一样」。这个定义只在有多套环境或需要回滚时才成立;单机跑一个自己的脚本,用 systemd 托管反而更快。
容器化部署流程是可重复的镜像构建、推送、拉取运行与回滚链路,不是某个工具的安装步骤。判断是否需要它,先看有没有多处运行和按版本回滚的要求:单机小服务、没有镜像仓库、没有发布权限时,用 systemd 或单机 compose 更省事。落地时把版本号写进镜像 tag、配置用环境变量从外部传入,跑完用docker ps和docker logs做第一次核对。
容器化部署流程到底指什么
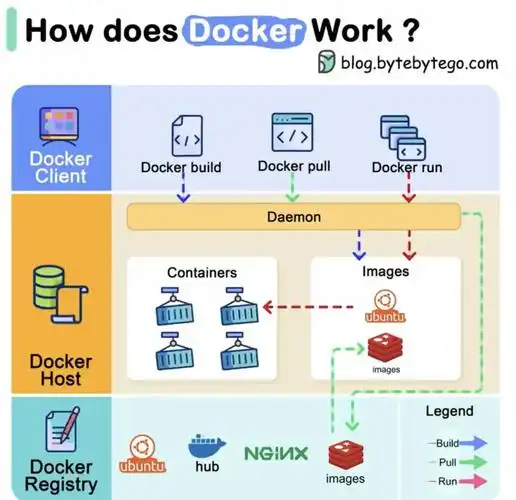
它是一条有固定顺序、每一步都能被单独验证的链路,不是一段脚本。判断对方讲的「容器化部署流程」是不是这个意思,看他说不说得出下面四步里的命令和验证点:
- 构建:
docker build -t 仓库地址/应用名:版本号 .,版本号建议带日期或提交号,不要只留latest。 - 推送:
docker push 仓库地址/应用名:版本号,推到目标机器能访问到的那个仓库地址。 - 拉取运行:目标机器上
docker pull后用docker run -d --name 应用名 -p 8080:8080 -e APP_ENV=staging 镜像启动,端口和环境变量从外部传入。 - 核对与回滚:
docker ps --filter name=应用名看容器是否在跑,docker logs --tail 100 应用名看启动阶段有没有报错;回滚就是把 tag 换回上一个版本号重新 run。
下面这段可以直接复制执行,把仓库地址、应用名、端口、版本号替换成自己的值,在能访问镜像仓库的机器上跑:
# 1) 构建,tag 带可核对的版本号

docker build -t registry.example.internal/myapp:20240101-1 .

# 2) 推到目标环境可访问的镜像仓库
docker push registry.example.internal/myapp:20240101-1

# 3) 目标机器拉取并启动,配置从外部传入
docker pull registry.example.internal/myapp:20240101-1
docker run -d --name myapp \
  -p 8080:8080 \
  -e APP_ENV=staging \
  registry.example.internal/myapp:20240101-1

# 4) 核对:容器状态与启动日志
docker ps --filter name=myapp
docker logs --tail 100 myapp
这条链路成立的场景是:同一份镜像要在测试环境和另一台机器上跑出同样结果,或者需要按版本号回退。如果只是为了在一台服务器上常驻一个进程,这条链路的多数步骤都用不上。
容器化部署流程和哪几个说法容易混
这几个词经常被混着说,但成因和排查位置完全不同,用一句判断条件就能分开:
- 写 Dockerfile(镜像构建):只解决「镜像怎么造出来」。判断条件:讨论里出现的是
FROM、COPY、RUN这些指令,产物是本地docker images里的一条记录,说明还在构建环节,没进入部署流程。 - 容器编排:解决「多个容器怎么调度、扩缩、探活」。判断条件:话题里出现副本数、Service、探针、命名空间这类对象,而单机
docker run根本用不到这些字段。 - CI/CD 流水线:解决「谁在什么时机自动执行构建和推送」。判断条件:能看到流水线配置文件或任务列表,以及最近一次执行的日志;如果构建还是人工在本地敲命令,那只是流程还没自动化,不代表流程不存在。
- 环境配置管理:解决「同一镜像在不同环境用不同参数」。判断条件:改一个端口或一个外部地址时,需要重新
docker build还是只改docker run的-e参数。需要重新构建,就说明配置被写进镜像了。
分辨顺序建议是先确认产出物(镜像有没有推到一个带版本号的地址),再确认执行者(人工还是流水线),最后确认配置来源(镜像内还是运行时传入)。顺序颠倒容易把「流水线没配好」误判成「容器化部署不可行」。
什么情况其实用不上容器化部署流程
不要因为别人都在用就套上来。按下面这个顺序问自己,任何一步答案是「否」,就可以先不做:
- 运行环境是否多于一处,或者是否需要对同一应用保留两个以上版本随时回退?只有一台机器、一个版本,答案通常是否。
- 是否有一个目标机器能访问到的镜像仓库?自建仓库要占存储和带宽,公有仓库的免费额度、私有仓库数量限制会变,具体数值需要到对应平台的套餐或配额页面确认,不要凭印象。没有可用仓库时,把镜像
docker save成 tar 再拷过去也能跑,但那已经不是可重复的流程。 - 发布这件事是否有人有权限操作目标机器的容器运行时?如果目标环境由别的团队托管、只给固定入口,自己搭一套构建推送链路意义有限。
- 维护成本是否有人承担?镜像清理、基础镜像更新、磁盘占用这些都得有人管,
docker system df能直接看到占用情况。
不适用时的替代做法更省事:单机常驻进程用 systemd 托管,配一个启动脚本和日志轮转;只有一个应用且依赖不多的,用单机 compose 管理启停顺序;已经有托管平台能直接跑代码的,优先用它自带的发布入口,别自己拼一套。判断依据不是「容器好不好」,而是运行处数量、回滚需求、仓库与权限门槛这三项是否同时满足。
容器化部署流程:三个动作确认你真的搞懂了
下面三个动作都能在半小时内自己做完,每个都带预期结果和结果不符时的含义。
动作一:把同一个镜像拉到另一台机器上跑起来。在第一台机器构建并推送,在第二台机器 docker pull 后启动,然后访问同一个端口。预期结果是容器正常启动、docker logs 首屏没有连接数据库或读取配置的报错、端口访问行为一致。如果第二台机器报错而第一台正常,通常说明有配置被写进了镜像或依赖了本机文件,这条链路还不能算可重复。
动作二:核对镜像摘要。推送后在目标机器执行 docker images --digests,看同一个 tag 对应的摘要是否与构建机一致。预期结果是摘要一致。如果摘要对不上,说明拉到的不是同一个镜像,常见原因是 tag 被重新推送覆盖过,或者两台机器指向了不同的仓库地址。
动作三:只改运行参数不改镜像。把 docker run 里的 -e APP_ENV 或端口映射改一处,重启容器,再执行 docker images 看镜像 ID。预期结果是镜像 ID 完全不变,而应用行为随参数变化。如果必须重新 docker build 才能改配置,说明分层没做对,后面每次换环境都要重新构建,回滚也会不可控。
最容易踩的坑是把配置写进镜像、同时只用 latest 这一个 tag。这样做的直接后果是回滚时无法确定要拉哪个版本——latest 会被后一次推送覆盖,旧镜像可能已经被清掉。规避办法很朴素:每次构建打一个带日期或提交号的 tag,配置全部通过 -e 或挂载文件在运行时传入,旧版本镜像至少保留一到两个再清理。清理前先用 docker system df 看一下实际占用,别在磁盘紧张时动手。