接口超时不要先改代码,先确认超时发生在哪一层:客户端到入口、入口到应用、应用到下游、应用到自己。排查顺序通常是先用curl -w把耗时按阶段拆开,再看应用日志里有没有对应请求,最后才动超时配置和连接池。下面按真实排查顺序给出可执行命令、判断清单和回滚方式,命令里的域名、端口、路径都要换成你环境的实际值。
接口超时排查建议按“客户端计时 → 入口与网关日志 → 应用内部日志与线程栈 → 下游依赖耗时 → 连接池与配置项”五步走,每步都要有能确认或排除的动作,不要凭感觉调大 timeout。先用 curl 的阶段耗时判断是网络层、入口层还是应用层慢,再决定改哪里;验证时看固定时间窗内的超时率和 P99 耗时是否回落,若改配置后无改善要能回滚到原值。
接口超时先定位在哪一层
接口超时的本质是某个环节的等待时间超过了调用方愿意等的时间。先分层,是为了避免在错误的层反复改配置。常见的分层和对应检查位置如下:
- 客户端到入口(DNS、TCP、TLS、负载均衡):检查位置是调用方机器的
curl -w输出、DNS 解析结果、TCP 握手时间。判断依据:如果time_namelookup或time_connect占比很高,问题通常不在业务代码。 - 入口到应用(反向代理、网关、限流):检查位置是网关的 access log 和 upstream 耗时字段。判断依据:网关日志记录的请求耗时明显小于客户端实际耗时,说明排队或连接建立阶段慢。
- 应用到下游(数据库、缓存、第三方接口):检查位置是应用日志里的下游调用耗时、数据库慢查询日志。判断依据:接口整体耗时约等于某个下游耗时。
- 应用自身(线程池、GC、锁、CPU):检查位置是线程栈、GC 日志、
top -H。判断依据:同一时刻多个接口一起超时,且下游耗时正常。
先确认是哪一层,再决定下一步查什么;分层判断不准时,回到 curl 阶段耗时重新核对。
接口超时:先看这四个位置
1. 日志。应用日志要按请求 ID 搜,不要只搜“timeout”。常见位置如 /var/log/nginx/access.log、/var/log/nginx/error.log,应用日志路径以你们部署配置为准,Spring Boot 默认在 logs/ 或 /var/log/app/ 下。可用命令:
grep '请求ID或traceId' /var/log/nginx/access.log
grep -i 'timeout\|timed out' /var/log/nginx/error.log
tail -n 2000 /var/log/app/application.log | grep -i '超时\|timeout'
2. 命令输出。用 curl 拆阶段耗时,这是判断“哪一段慢”最快的动作:
curl -o /dev/null -s -w 'dns:%{time_namelookup} connect:%{time_connect} tls:%{time_appconnect} first_byte:%{time_starttransfer} total:%{time_total} http:%{http_code}\n' \
  -H 'X-Request-Id: debug-001' \
  'https://api.example.com/v1/orders?page=1'
把 api.example.com、路径和请求头换成实际值。多执行几次,观察各阶段耗时是否稳定。
3. 配置项。重点看三类:调用方的连接超时和读取超时(如 HTTP 客户端的 connectTimeout、readTimeout)、服务端 worker 或线程池大小、网关的 upstream 超时。readTimeout 建议不小于下游 P99 耗时,改动前记录原值。
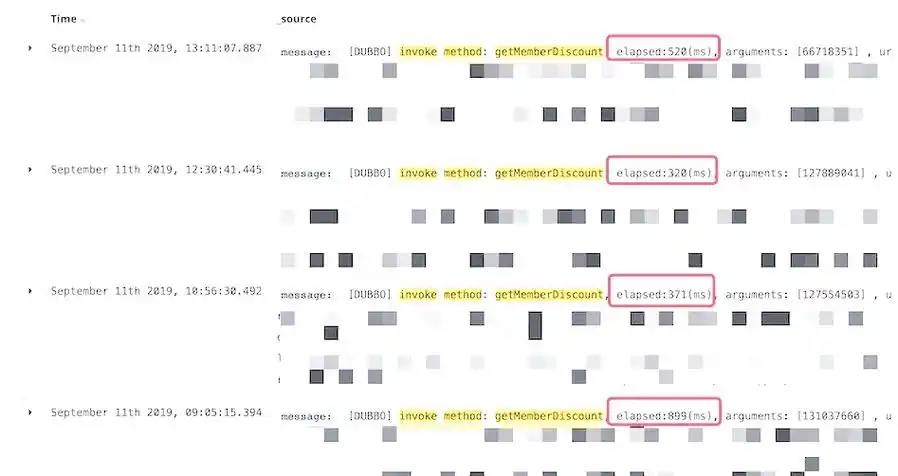
4. 面板字段。在监控面板上找这几个字段:超时次数、错误率、P95/P99 耗时、上游响应时间(upstream_response_time)、活跃连接数、线程池队列长度。判断依据:超时集中在某个时间点还是持续存在,是否与连接数或队列长度同步上涨。
接口超时:按可能性从高到低排除
- 下游依赖变慢。确认方法:对比接口耗时与下游调用耗时,看数据库慢查询日志或下游服务面板。处理:先确认下游是否限流、慢查询是否有索引缺失;在下游恢复前可临时调大调用方 readTimeout,但要记录原值。
- 连接池或线程池被打满。确认方法:看连接池活跃数、等待队列长度,抓线程栈
jstack <pid> > /tmp/stack.txt,在栈里搜阻塞等待。处理:定位是慢调用占住连接,还是池上限设得过小;先修慢调用,再评估是否调整池大小。 - 客户端或网关超时设得过紧。确认方法:把 curl 实测耗时与配置值对比,若实测 P99 接近或超过配置值,基本可确认。处理:按实测耗时留出余量调整,同时避免无限调大掩盖真实慢调用。
- 突发流量或单点热点。确认方法:看面板上请求量和超时是否在同一时间窗口同步上升。处理:先确认限流是否生效,再判断是否需要扩容或分流。
- 网络或 DNS 抖动。确认方法:curl 的
time_namelookup、time_connect是否异常;对同一域名多次解析看结果是否变化。处理:这类问题通常需要网络侧配合确认,应用侧只能做重试和超时兜底。 - 本身是慢接口。确认方法:在没有下游异常时,单请求耗时仍然高,看是否有循环调用、N+1 查询、大对象序列化。处理:优化查询或分批处理,不要靠调大超时解决。
按这个顺序逐项确认或排除,每排除一项要有对应的证据,不要同时改多个配置。
接口超时:改完怎么确认真的解决了
改完后先用同一组 curl 命令重新测量阶段耗时,至少执行 10 次,对比 total 和各阶段耗时是否稳定落在预期范围内。然后用同一请求 ID 检索日志,确认没有新的超时记录和异常堆栈。
for i in $(seq 1 10); do
  curl -o /dev/null -s -w 'total:%{time_total} http:%{http_code}\n' \
    'https://api.example.com/v1/orders?page=1'
done
grep -c 'timeout\|timed out' /var/log/nginx/error.log
再回到监控面板看固定时间窗内的超时次数、错误率和 P99 耗时。观察多久算稳定,要结合你们业务的调用频率:低频接口建议覆盖至少一个业务高峰周期,高频接口可以看连续几个统计周期内超时数是否回到改前水平。不要只看几分钟没报错就下结论。
回滚办法:改动前把原配置值记录在变更单或注释里,例如 readTimeout: 3000ms 改为 5000ms 时保留原值。若改完超时未下降或出现新错误,先把配置恢复为原值并重启或热加载,再确认日志和面板指标恢复;连接池大小之类的改动同样先回原值,避免多个变量叠加导致无法判断。