搜「Kubernetes集群部署教程」的人,多数不是不会敲 kubeadm init,而是敲完卡在拉镜像超时、节点一直 NotReady、worker 节点 join 报 unauthorized。先把版本、权限、入口地址三件事核对清楚,再按最短路径走一遍,比照着长教程从头抄要快。
自建 Kubernetes 集群能否一次跑通,通常取决于开工前的三项确认:容器运行时与 kubeadm 的版本对齐、节点 swap 与关键端口已处理、API Server 对外地址能固定解析。三项确认完,单控制面集群用 kubeadm 一般能在一轮内拉起;缺任何一项,就会停在拉镜像、NotReady 或 join 超时上。下面流程适用于自建虚拟机或裸金属,托管集群不必走这套。
Kubernetes部署之前先确认这三件事
三项确认都落在具体命令和文件上,不用凭感觉判断。
第一,版本对齐。kubelet、kubeadm、kubectl 的次版本要落在 kubeadm 允许的偏差范围内,containerd 的 cgroup driver 要和 kubelet 一致。查看位置:
kubeadm version -o short
kubelet --version
containerd --version
containerd config dump | grep -i SystemdCgroup
最后一条输出 SystemdCgroup = true 才和 kubelet 默认行为一致。kubeadm 与 kubelet 的具体允许偏差,到 Kubernetes 官网 kubeadm 安装页面的版本偏差说明处核对,不要凭记忆写死。
第二,权限与节点前置条件。部署账号需要 root 或可 sudo,swap 必须关闭,6443、10250、2379-2380、10257、10259 等端口不能被防火墙挡掉。查看位置:
swapon --show
systemctl status firewalld --no-pager
ufw status verbose
getenforce
swapon --show 无输出即已关闭;如果 /etc/fstab 里还有 swap 行,重启后会回来,需要一并注释掉。
第三,入口地址与主机名解析。API Server 的 advertiseAddress 必须是一个重启后不变的地址,各节点要能互相解析主机名。查看位置:ip -4 addr 看网卡地址,hostname 看当前主机名,cat /etc/hosts 看是否有各节点的主机名到 IP 映射。云主机常见问题是公网 IP 临时分配、内网地址与 hostname 绑错,导致 join 时连不上 6443。
Kubernetes部署:最短可用路径
以下五步在每台节点上按顺序执行,控制面节点额外做 kubeadm init。
第 1 步:关闭 swap、放行内核转发。执行完 swapon --show 应无输出。
sudo swapoff -a
sudo sed -ri 's/.*swap.*/#&/' /etc/fstab
cat <<EOF | sudo tee /etc/modules-load.d/k8s.conf
overlay
br_netfilter
EOF
sudo modprobe overlay && sudo modprobe br_netfilter
cat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-iptables  = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward                 = 1
EOF
sudo sysctl --system
第 2 步:安装 containerd 并切换 systemd cgroup。改完重启,再确认输出为 true。
sudo mkdir -p /etc/containerd
containerd config default | sudo tee /etc/containerd/config.toml
sudo sed -i 's/SystemdCgroup = false/SystemdCgroup = true/' /etc/containerd/config.toml
sudo systemctl restart containerd
containerd config dump | grep -i SystemdCgroup
第 3 步:装 kubelet / kubeadm / kubectl。下面 URL 中的 v1.30 是占位,改成你确认过的次版本;可用版本用 apt-cache madison kubeadm 查。
sudo apt-get update && sudo apt-get install -y apt-transport-https ca-certificates curl gpg
curl -fsSL https://pkgs.k8s.io/core:/stable:/v1.30/deb/Release.key | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
echo 'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/v1.30/deb/ /' | sudo tee /etc/apt/sources.list.d/kubernetes.list
sudo apt-get update
apt-cache madison kubeadm
sudo apt-get install -y kubelet kubeadm kubectl
sudo apt-mark hold kubelet kubeadm kubectl
最后一行 hold 住版本,避免后续 apt 升级把 kubelet 拉到与 kubeadm 不匹配的次版本。
第 4 步:init 控制面。先看一眼默认配置结构,再写自己的配置文件:
kubeadm config print init-defaults | head -40照着输出的 apiVersion 字段写 /root/kubeadm-config.yaml,然后执行 sudo kubeadm init --config /root/kubeadm-config.yaml --upload-certs。成功时末尾会打印 Your Kubernetes control-plane has initialized successfully! 和一段 join 命令。
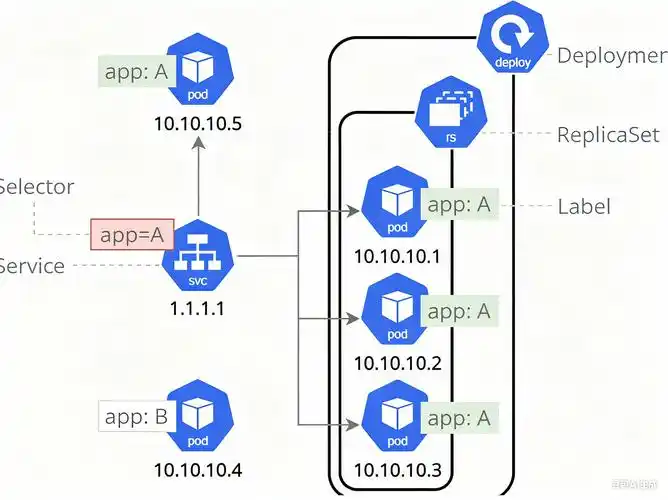
第 5 步:装 CNI,节点才会 Ready。未装 CNI 前 kubectl get nodes 显示 NotReady 是正常现象。选一个与 podSubnet 匹配的清单 apply 后,再执行 kubectl get nodes -o wide,STATUS 应变为 Ready。
这一步最容易踩的坑:containerd 的 cgroup driver 仍是 cgroupfs,而 kubelet 用 systemd。表现是 kubelet 起不来,日志里出现 kubelet cgroup driver: "systemd" is different from ... cgroup driver: "cgroupfs"。判断方式:journalctl -u kubelet -n 50 --no-pager | grep -i cgroup。修法是回到第 2 步把 SystemdCgroup = true 改对并重启 containerd,然后 sudo kubeadm reset -f 重来,不要在半成品状态上继续 init。
Kubernetes部署:一个真实场景的完整做法
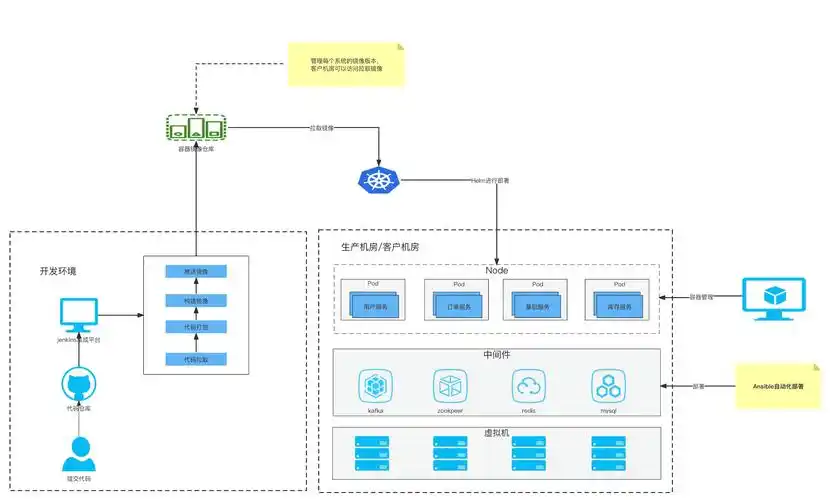
场景:3 台 4 核 8G 虚拟机,同一内网 192.168.10.0/24,主机名分别是 k8s-master、k8s-node1、k8s-node2,IP 为 .11、.12、.13;1 个控制面加 2 个 worker;Pod 网段 10.244.0.0/16,Service 网段 10.96.0.0/12。
每台机器先写好主机名映射,写在 /etc/hosts:
192.168.10.11 k8s-master
192.168.10.12 k8s-node1
192.168.10.13 k8s-node2
控制面配置文件 /root/kubeadm-config.yaml 的实际取值如下,字段名以你机器上 kubeadm config print init-defaults 的输出为准:
apiVersion: kubeadm.k8s.io/v1beta3
kind: InitConfiguration
localAPIEndpoint:
  advertiseAddress: 192.168.10.11
  bindPort: 6443
nodeRegistration:
  name: k8s-master
  criSocket: unix:///run/containerd/containerd.sock
---
apiVersion: kubeadm.k8s.io/v1beta3
kind: ClusterConfiguration
kubernetesVersion: v1.30.4
controlPlaneEndpoint: 192.168.10.11:6443
networking:
  podSubnet: 10.244.0.0/16
  serviceSubnet: 10.96.0.0/12
kubernetesVersion 填 apt-cache madison kubeadm 里实际装上的那个版本号,别抄示例里的号。init 成功后按提示把 /etc/kubernetes/admin.conf 拷到 $HOME/.kube/config,执行 kubectl get nodes 应能看到 k8s-master。
接着装 CNI。Flannel 的清单里 Network 字段必须是 10.244.0.0/16,与上面的 podSubnet 一致;具体清单地址去 flannel 的 releases 页面按版本取,不要用记下来的旧链接。apply 后执行:
kubectl get pods -n kube-system -o wide
kubectl get nodes -o wide
两个 worker 加入集群,在各自节点上执行 init 末尾打印的 kubeadm join 192.168.10.11:6443 --token ... --discovery-token-ca-cert-hash sha256:...。join 完成后回到控制面执行 kubectl get nodes,三台均为 Ready 即完成。若需要固定 IP 之外的访问方式,用 kubectl -n kube-system get svc kube-dns 之类命令先确认集群内服务正常,再考虑加装 CNI 之外的组件。
Kubernetes部署:跑不通先查这三处
卡点一:init 卡在拉镜像。表现为终端长时间停在 [kubelet-check] Waiting for a healthy kubelet 或出现 failed to pull image "registry.k8s.io/..."。检查位置:sudo crictl images 看 pause 与 kube-apiserver 等镜像是否在本地;sudo crictl pull registry.k8s.io/pause:3.9 单独试拉看报错原文。如果确认是网络出口问题,可以先用 kubeadm config images list --config /root/kubeadm-config.yaml 列出所需镜像,再决定是配置 containerd 的 registry mirror(/etc/containerd/config.toml 中 [plugins."io.containerd.grpc.v1.cri".registry.mirrors])还是离线导入(crictl load)。改完 sudo systemctl restart containerd。
卡点二:节点一直 NotReady。页面提示是 kubectl describe node k8s-master 里的 KubeletNotReady ... network plugin is not ready: cni config uninitialized。检查顺序:先 kubectl get pods -n kube-system 看 CNI 的 DaemonSet 是否 Running,再 kubectl -n kube-system logs <cni-pod> 看具体报错,最后到节点上 ls /etc/cni/net.d/ 确认是否有配置文件写入。这个目录为空,说明 CNI 根本没装成。
卡点三:worker join 报 unauthorized 或超时。报错原文常见 error execution phase preflight: couldn't validate the identity of the API Server: abort connecting to API servers after timeout of 5m0s,或 token 校验失败。检查位置:控制面执行 kubeadm token list 看 token 的 TTL 是否已过期(默认 24 小时),过期就重新生成 kubeadm token create --print-join-command;同时在 worker 上执行 curl -k https://192.168.10.11:6443/livez 确认网络与端口可达。返回 ok 才说明连得上,连不上就不要反复重试 join,先回到第一件事核对地址与防火墙。