微调能不能跑起来,通常不取决于你选了哪个框架,而取决于三件事是否先对上:训练入口在哪个脚本或面板、数据是否已经是成对的“输入—目标输出”、显存能不能撑住最小批量。先核对这三项,再决定用 LoRA 还是全参数微调;顺序反过来,往往会在中途反复返工。
把微调拆成“确认入口 → 校验数据 → 小步试通 → 评估对比”四步,前一步没跑通就不要进入下一步。判断标准很具体:训练日志要打印出 loss 行,输出目录要出现 adapter 配置与权重文件,评估脚本能加载并给出逐条对比结果。版本、显存、下载权限这类会变化的项,按文中给出的位置现场查一遍,不要照搬别人博客里的版本号。
AI模型微调怎么做的啊?
“怎么做”卡住的人,多数不是缺框架,而是不知道自己现在处在微调流程的第几步。这个问题对应的是第 0 步:确认手上有没有可用的训练入口和成对数据。确认方式不要靠回忆,而是跑几条命令看输出。
python -V
python -c 'import torch, transformers; print(torch.__version__, transformers.__version__, torch.cuda.is_available())'
ls -l data/ configs/ 2>/dev/null
wc -l data/train.jsonl
能看到的结论是明确的:torch.cuda.is_available() 返回 True,说明当前进程能拿到 GPU;data/train.jsonl 行数不为 0,说明数据文件存在;再抽一行 head -n 1 data/train.jsonl,能被 json 解析且同时含输入字段与目标输出字段,才算数据可用。只要这一步的输出对不上,后面选什么框架都没有意义,风险边界就在这里:环境或数据没确认,任何训练报错都无法判断是代码问题还是环境问题。
AI模型微调怎么做的啊视频
搜视频的人,对应的其实是流程里的“照教程复现”这一步,卡点通常是版本和参数对不上:视频里一条命令能跑,你在本地直接报参数不存在或显存不足。确认是不是这个问题,要看两个可核对的位置。
- 参数是否真实存在:
python train.py --help | head -n 40,视频里出现的--fp16、--gradient_checkpointing 这类开关,只有--help里列出来了才算可用。 - 版本是否一致:
pip show torch transformers datasets peft accelerate,看 Name 与 Version 两栏,和日志里打印的版本对齐。 - 关键超参是否一致:训练日志开头的配置行,核对 num_train_epochs、per_device_train_batch_size 是否与视频相同。
把视频里的命令逐条对照 --help 抄一遍,比直接复制粘贴更省时间。如果报错首行是 CUDA out of memory,先看日志里那一次的 batch size 和 max_seq_len,再决定是减小批量还是缩短序列长度,而不是盲目换框架。
AI模型微调之前先确认这三件事
- 版本:
python -V、pip show torch transformers peft、nvidia-smi(右上角显示驱动与 CUDA 版本)。训练框架自带的 CLI 也可以用xxx --version确认。缺版本的后果是参数名对不上,报错信息还容易误导。 - 权限:模型权重能不能下载,看
ls ~/.cache/huggingface/token是否存在,以及模型页面上是否已同意访问条款;GPU 能不能用,看nvidia-smi是否列出设备、容器内echo $CUDA_VISIBLE_DEVICES是否非空;输出目录能不能写,看ls -ld outputs/的属主。 - 入口位置:训练脚本的路径与配置项,例如 configs/lora_sft.yaml 里的 base_model、train_file、output_dir 三个字段;如果用的是平台面板,对应“训练/微调”页签里的模型选择、数据集挂载和输出路径三处。入口找不到时,先确认要跑的是本地脚本还是平台任务,这两者的排查路径完全不同。
AI模型微调:最短可用路径
下面这条路径用通用的训练脚本骨架演示,脚本名和参数名按你实际的框架替换,具体参数以 python train.py --help 的输出为准。
- 建环境并记录版本:
python -m venv .venv && source .venv/bin/activate && pip install -U pip && pip install torch transformers datasets peft accelerate。做完应看到 pip show 输出的每条依赖都有 Name 和 Version,先把版本记下来。 - 校验数据:train.jsonl 每行一条 JSON,且含 instruction 与 output 两个字段。用一段校验脚本跑一遍,看到样本计数与实际行数一致、无解析异常,再往下走。
- 小步试通:
python train.py --config configs/lora_sft.yaml --max_steps 20。做完应看到日志中出现 loss 行,且 outputs/lora-r8/ 目录下生成 adapter_config.json 和权重文件。 - 评估对比:
python eval.py --base /models/your-base --adapter outputs/lora-r8 --data data/dev.jsonl --out outputs/eval.json。做完应看到 eval.json 生成,里面是逐条生成结果,抽看若干条即可判断是否可用。 - 接入或合并:服务端支持加载 adapter 时直接挂载 outputs/lora-r8;不支持时再走合并脚本,合并产物单独放一个目录,便于回退。
AI模型微调:一个真实场景的完整做法
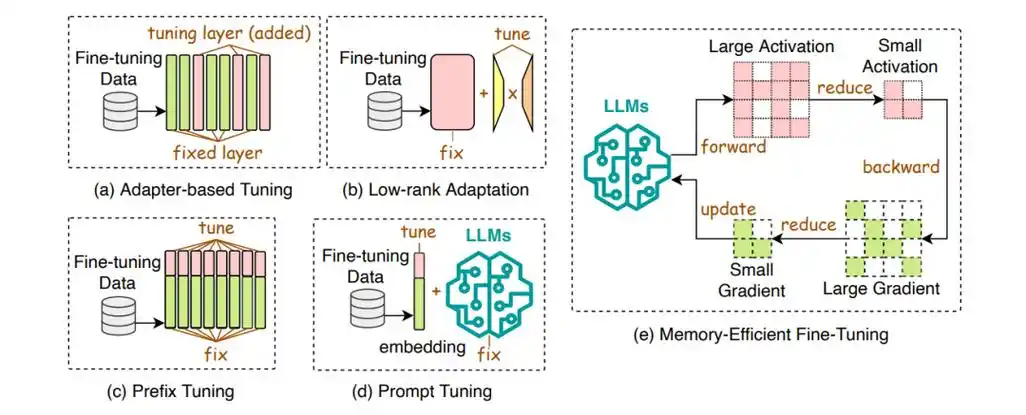
场景:把一批客服单轮问答整理成风格统一、口径一致的回复能力。数据对象是短文本问答对,量级按 2000 条左右准备,其中 1800 条训练、200 条留作对比。配置写在 configs/lora_sft.yaml 里,数据字段由 data/train.jsonl 决定。
# configs/lora_sft.yaml
base_model: /models/your-base        # 本地权重目录,或已登录的仓库标识
train_file: data/train.jsonl
val_file: data/dev.jsonl
output_dir: outputs/lora-r8
max_seq_len: 1024
lora:
  r: 8
  alpha: 16
  dropout: 0.05
  target_modules: [q_proj, v_proj]   # 按模型结构调整,用 named_modules 确认
train:
  per_device_batch_size: 1
  grad_accum: 8
  lr: 2e-4
  epochs: 3
  warmup_ratio: 0.03
容易踩的坑在 target_modules:不同模型结构的注意力层命名不一样,写错时训练照样能启动,但 LoRA 层其实没挂上。可核对的位置是训练开始日志里打印的 trainable params 行,或者直接 print(sum(p.numel() for p in model.parameters() if p.requires_grad)),如果这个数等于全量参数或为 0,就说明配置没生效,先停下来改名字,不要继续训。另一个常见问题是 max_seq_len 小于实际样本长度导致内容被截断,核对方式是统计 tokenize 后的长度分布,确认绝大多数样本没有触顶。
顺序上建议:先跑 20 步确认 loss 有输出、adapter 文件落地,再放开 epochs 完整训练;训练完成后用留出的 200 条跑一次对比,人工抽看回复是否改变了口径而没有改变事实。学习率、秩、轮数这些取值需要结合你的数据量和显存确认,本文给的是保守起点,不是调优结论。