搜「MongoDB和MySQL的区别」,多数人卡的不是概念,而是手上有一张具体的表、几条具体的查询,不知道继续放在 MySQL 里够不够用,还是该换成文档模型。所以判断顺序通常是:先写出高频查询和写事务边界,再看这些查询在两边分别靠什么执行计划跑,最后才算运维和成本。没有查询清单就直接问「哪个快」,答案一定是错的,因为两边都快不过一个匹配的索引。
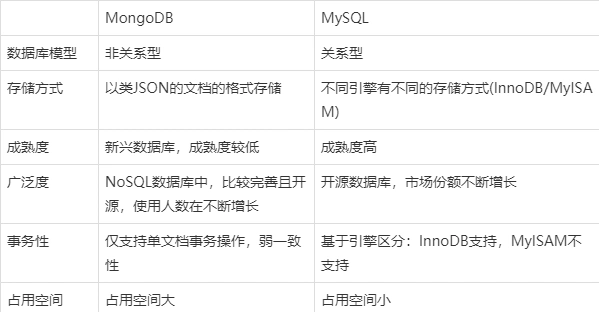
MongoDB 和 MySQL 的分界不在「结构化与否」,而在查询模式和事务边界。若你的高频读是围绕单条聚合根、字段经常增删、且不需要跨表强一致,可以先用 MongoDB 建原型验证执行计划;若核心是跨表关联、多表事务和报表类 SQL,先留在 MySQL。验证方式统一用两边的 explain 输出看扫描条数与返回条数的比值,而不是凭印象。风险边界:这条判断不覆盖跨机房一致性和分片运维成本,需要结合环境单独确认。
MongoDB和MySQL:各自站在什么位置
MySQL 的定位是关系型数据库,InnoDB 提供事务、行锁、外键(可关)和成熟的 SQL 优化器与执行计划输出。它擅长的是「多条记录之间有明确关系、需要按不同维度反复组合查询」的场景。判断口径可以直接落到文档和命令上:官方手册的 InnoDB 事务与锁章节(InnoDB Locking and Transaction Model)定义了隔离级别语义;在实例里执行 SHOW ENGINES; 能确认存储引擎,执行 SHOW VARIABLES LIKE 'innodb_buffer_pool_size'; 能确认缓存配置,这两个值决定了你能跑多大的热数据集。
MongoDB 的定位是文档数据库,一条文档就是一个完整聚合,字段可以不一致,副本集和分片是内建能力,聚合管道负责服务端计算。它擅长的是「一次读写就要拿到整条对象、对象内部结构还在演进」的场景。判断口径同样有落点:官方文档的 Data Modeling 与 Usage Considerations 章节说明建模约束;在实例里执行 db.serverStatus(); 看连接数与操作计数,执行 db.getCollection('集合名').stats(); 看 size、storageSize、indexSizes,这三个值是判断索引是否吃内存的第一手依据。
MongoDB和MySQL:性能、成本、运维、上手四个口径分开比
性能。不能泛泛比。MySQL 侧用 EXPLAIN 看 type 与 rows,较新的 8.x 提供 EXPLAIN ANALYZE 看实际耗时,版本支持范围以官方手册为准;MongoDB 侧用 db.集合名.find({...}).explain("executionStats"),重点看 totalDocsExamined 与 nReturned。要做压测就用同一份数据分布、同一并发模型,MySQL 常用 sysbench 自带 Lua 脚本,MongoDB 用 YCSB 或自写脚本,混用两套脚本得到的数字没有可比性。
成本。先看容量再谈钱。MySQL 的库表占用查 information_schema.TABLES 的 data_length、index_length;MongoDB 查 db.stats() 的 dataSize、storageSize、indexSize、fsUsedSize。注意 MongoDB 的 storageSize 含压缩后的实际磁盘占用,和 dataSize 不是一回事,直接拿 dataSize 算磁盘会买小。实例价格和规格会变,位置在各云厂商控制台的「实例规格 / 价格总览」页和账单明细里,签约前以当期页面为准。
运维。MySQL 侧备份常见 mysqldump 与物理备份工具,监控看 performance_schema 和 SHOW ENGINE INNODB STATUS\G 里的锁等待段;MongoDB 侧备份是 mongodump 或副本集快照,监控看 mongostat、mongotop 以及 db.currentOp()。两边的共同点是:慢查询都要单独开启收集,MySQL 是 slow_query_log 相关参数,MongoDB 是 db.setProfilingLevel(1, { slowms: 100 }),采样级别开太高本身会带来额外写开销。
上手。SQL 是通用技能,招人、交接、查问题都有现成路径;MongoDB 的语法门槛低,但真正的门槛在聚合管道($match、$group、$lookup、$unwind)和索引设计,$lookup 名义上像 join,但执行方式与 SQL join 不同,写之前应先 explain 看阶段。
MongoDB和MySQL:什么情况选哪一边
给出判断顺序清单,按这个顺序逐条过,前面一条命中就基本能定:
- 是否存在必须跨三张以上表、且要保证原子性的写事务?是 → 优先 MySQL。
- 高频读是否都围绕一个主键或一个聚合根,一次只需取回整条对象?是 → 可以先用 MongoDB 验证。
- 字段是否在未来半年内预计频繁增删,且下游不依赖固定表结构?是 → MongoDB 的迁移成本更低。
- 是否有大量按不同维度组合、带聚合和排序的报表查询?是 → 优先 MySQL,或把结果落到单独的分析存储。
- 团队现有值班能力是否能覆盖第二套数据库的备份、升级和故障切换?否 → 不要为局部建模便利引入第二套。
对应三类场景:账务、订单主表、权限关系这类强一致场景,选 MySQL,前置条件是事务边界清晰、单表增长在可维护范围内、分库分表的运维成本团队能承担。内容详情、商品属性、埋点明细这类以单条文档为读写单位的场景,可以选 MongoDB,前置条件是查询模式已经定下来、高频查询都能被索引覆盖、不要求跨集合强一致。主数据加文档快照的混合场景,两边都用,前置条件是接受双写不一致的补偿方案(如本地消息表 + 重试),并且监控能覆盖两条链路。
MongoDB和MySQL:一次能复现的对比做法
十分钟版本:用容器起两个实例,灌同一份数据,跑同一语义的查询,比对执行计划。镜像 tag 会更新,具体版本号在 Docker Hub 镜像页确认。
docker run -d --name cmp-mysql -e MYSQL_ROOT_PASSWORD=rootpw -e MYSQL_DATABASE=cmp -p 3306:3306 mysql:8
docker run -d --name cmp-mongo -p 27017:27017 mongo:7
MySQL 侧建表并灌数据,注意递归 CTE 有默认深度限制,先放开再插,否则会中途报错:
SET SESSION cte_max_recursion_depth = 100001;
CREATE TABLE item (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  sku VARCHAR(32) NOT NULL,
  price DECIMAL(10,2) NOT NULL,
  attrs JSON,
  KEY idx_sku (sku)
);
INSERT INTO item (sku, price, attrs)
WITH RECURSIVE seq AS (
  SELECT 1 AS n UNION ALL SELECT n + 1 FROM seq WHERE n < 100000
)
SELECT CONCAT('SKU', LPAD(n, 8, '0')), n % 500, JSON_OBJECT('color', 'red') FROM seq;
MongoDB 侧用 mongosh 执行,分批写入,写完再建索引:
const batch = [];
for (let i = 1; i <= 100000; i++) {
  batch.push({ sku: 'SKU' + String(i).padStart(8, '0'), price: i % 500, attrs: { color: 'red' } });
  if (batch.length === 5000) { db.item.insertMany(batch); batch.length = 0; }
}
if (batch.length) db.item.insertMany(batch);
db.item.createIndex({ sku: 1 });
然后跑同一语义的两条查询。命中索引时:MySQL 执行 EXPLAIN SELECT * FROM item WHERE sku = 'SKU00001234';,预期 type 为 ref、rows 为 1 量级;MongoDB 执行 db.item.find({ sku: 'SKU00001234' }).explain("executionStats"),预期 winningPlan 里出现 IXSCAN,totalDocsExamined 与 nReturned 接近相等。再跑无索引字段:MySQL 用 EXPLAIN SELECT * FROM item WHERE price = 100;,预期 type 为 ALL、rows 接近全表;MongoDB 用 db.item.find({ price: 100 }).explain("executionStats"),预期出现 COLLSCAN、totalDocsExamined 接近总条数。差异点不在引擎本身,而在有没有可用索引,这一条能直接推翻很多「谁更快」的印象式结论。
容易踩的坑:为了少引入一套数据库,把半结构化数据塞进 MySQL 的 JSON 列——可以存,但按 JSON 内部字段过滤时默认走不了普通索引,需要生成列加索引或使用多值索引,否则查询会退化成全表扫描;反过来,用 MongoDB 的 $lookup 硬做多集合关联也一样,不 explain 就上线,等数据量涨上来才发现每一步都在扫全集。