AI 应用的可观测性不建议从“把所有指标都埋上”开始,而是先选一条能定位问题的链路。通常从四类指标入手就够用:请求可用性(失败、超时、限流、输出解析失败)、分阶段延迟(检索、首 token、生成剩余部分、后处理)、token 用量与重试次数、输出可用性(空响应、结构校验失败、被截断、拒答)。这四类指标能回答“有没有坏、坏在哪一层、代价多大”这三个问题;其他的质量分、用户满意度可以后补。前提是每个请求都有可贯穿的 trace 标识,否则指标只是总量曲线,出问题时无法定位到具体请求。
先给每个请求生成 trace_id,把入口、检索、模型调用、工具调用、输出解析串成一条链路,再埋四类指标:可用性、分阶段延迟、token 与重试、输出可用性。适用场景是已经上线的对话、RAG 或 Agent 类应用;如果暂时没有全链路追踪,先用入口日志 + trace_id 起步也有效。验证方式是做故障注入,看错误能否被分类而非笼统记为失败;边界是流式输出、隐私字段、第三方供应商计费口径,这些都要在埋点前先定好规则。
先确认当前场景和目标
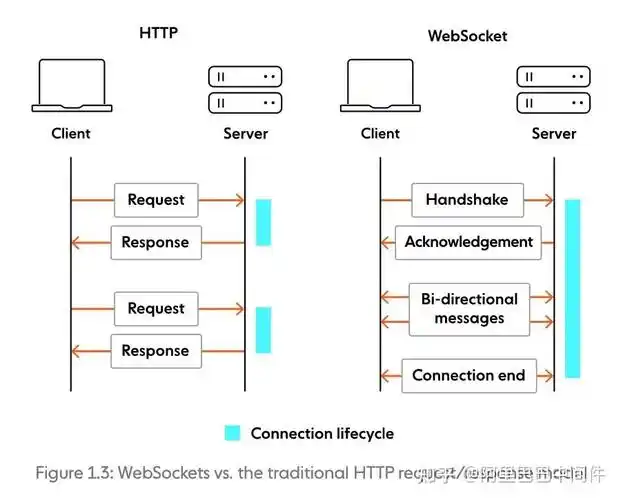
动手前先确认四件事,它们直接决定指标怎么定。第一,模型是自己部署还是调用第三方 API,自部署能拿到显存、队列等待、批处理等指标,第三方只能拿到响应状态和耗时,token 明细有时还需要本地估算。第二,是否流式输出;流式下“端到端延迟”意义会被削弱,必须拆成首 token 时间和生成总时长,否则慢请求会被误判。第三,链路里有没有检索和工具调用;有的话,检索命中为空、工具调用超时、工具返回值解析失败都要单独计数,否则这些错误会被吞进“模型回答不好”里。第四,出问题时你能改什么;如果只能改提示词和重试策略,指标就应围绕这两项的可控变量设计。
判断条件可以简单一些:如果当前只有单轮问答且没有外部依赖,先做请求量、失败分类、分阶段延迟三项即可;如果已经引入 RAG 或多步工具调用,就必须给每个阶段单独打点,并把 prompt 版本、模型名、知识库版本作为标签维度。没有这几个维度,看板只能看到总量波动,无法判断问题来自换模型、改提示词还是检索内容变化。
按这个顺序处理
建议按“先定链路,再定指标,最后定维度”的顺序做,不要反过来先铺图表。
- 确定一次请求的边界:在入口生成 trace_id,随请求透传到检索、模型调用、工具调用和输出解析;异步任务(如后台总结)单独开 trace_id,并在日志里记录父请求 id。
- 先埋最小四类指标:失败数按 error_type 分桶(超时、限流、鉴权、供应商 5xx、输出结构校验失败、客户端中断),延迟按阶段记录并且保留分位数,token 记录输入与输出并单独计重试,输出可用性记录 finish_reason、空响应、schema_ok。
- 加维度标签:prompt 版本、模型名与版本、场景或租户、检索库版本。标签数量要克制,高基数标签会拖慢查询。
- 定采样规则:错误和慢请求全量保留,成功请求按比例采样,但采样后仍要能按 trace_id 拼回完整链路。
下面是一段通用的埋点骨架,函数名和字段需要按你使用的客户端替换;重点是把首 token 时间、重试次数、结构校验结果放进同一条日志,而不是分散在多个系统里。
import json, logging, time, uuid

log = logging.getLogger("ai.trace")

def traced_chat(scene, prompt_version, model, call_fn, trace_id=None, **kw):
    trace_id = trace_id or str(uuid.uuid4())
    marks, t0 = {}, time.monotonic()

    def mark(name):
        marks[name] = round((time.monotonic() - t0) * 1000)

    try:
        out = call_fn(trace_id=trace_id, mark=mark, **kw)
        log.info(json.dumps({
            "trace_id": trace_id, "scene": scene, "model": model,
            "prompt_version": prompt_version, "status": "ok",
            "marks_ms": marks,
            "total_ms": round((time.monotonic() - t0) * 1000),
            "input_tokens": out.get("usage", {}).get("input"),
            "output_tokens": out.get("usage", {}).get("output"),
            "finish_reason": out.get("finish_reason"),
            "schema_ok": out.get("schema_ok"),
            "retry": out.get("retry", 0),
        }, ensure_ascii=False))
        return out
    except Exception as e:
        log.warning(json.dumps({
            "trace_id": trace_id, "scene": scene, "model": model,
            "prompt_version": prompt_version, "status": "error",
            "error_type": type(e).__name__,
            "marks_ms": marks,
            "total_ms": round((time.monotonic() - t0) * 1000),
        }, ensure_ascii=False))
        raise
error_type 直接用异常类名往往太散,建议在 catch 时映射成固定几类(超时、限流、上游错误、解析失败),日志里保留原始类名作为附加字段。call_fn 需要在内部调用 mark("first_token")、mark("retrieval_done") 等,这一步需要结合你的客户端回调位置确认。
改完后怎么验证
埋点做完不等于可用,建议做一次小规模故障注入来确认指标是否按预期分类。可执行的动作包括:临时把模型地址指向一个不可达地址,看是否被记为上游错误而不是通用失败;让输出校验故意失败一次,看 schema_ok 是否落到错误分桶;人为增加一次重试,确认 retry 字段有值且 token 统计没有丢;走一次带检索的请求,确认能从入口 trace_id 查回全链路各阶段耗时。
预期信号是:错误能被归到具体类型而不只是“失败了”;慢请求能定位到检索、首 token 或后处理中的某一阶段;分阶段耗时之和与端到端耗时之间的差值在可解释范围内;本地统计的 token 量与供应商账单量级大致对得上。如果这几项对不上,先修埋点的统计规则,不要急着设告警阈值。阈值建议等积累一段时间基线后再按分位数设定,避免上线初期频繁误报。
容易忽略的边界
- 流式输出与客户端中断:用户关页面时服务端可能仍记录为成功,需要单独记录客户端主动断开,否则可用性指标会偏乐观。
- 日志中的提示词原文:提示词和用户输入常含隐私内容,建议默认只落长度、哈希或脱敏摘要,确需原文时走单独的低权限存储。
- 重试的连锁影响:重试会同时放大 token 消耗和供应商配额占用,重试次数必须作为独立维度,不能只并入请求总量。
- 第三方令牌统计误差:部分供应商不返回逐请求 token 明细,本地估算只能用于趋势观察,不适合直接当计费依据。
- 指标口径变更:改字段名或统计方式会打断历史对比,建议在指标或日志里带 schema 版本,并在变更记录里写明口径。
如果当前基础设施还不支持全链路追踪,可以先只做入口日志加 trace_id,把失败分类和总耗时先跑起来;这属于临时手段,不代表最终方案,等链路追踪就绪后再把检索和工具阶段补上,并回填口径说明,避免新旧数据混在一起比较。