Spring Boot 整合 RabbitMQ 的难点通常不在写收发代码,而在于把「连接配置、交换机与队列声明、消息序列化、消费确认」这四件事弄对——只要这四项中有一件没对上,最常见的表现就是消息能发出去但消费端收不到,或者消费端一直重复收到同一条消息。
适用场景:你需要在现有 Spring Boot 服务里新增一条异步消息链路,或者把已有的同步调用改为通过队列解耦。操作动作:先用 spring-boot-starter-amqp 配好连接参数,让应用在启动时声明交换机、队列和绑定,再用 RabbitTemplate 发消息、@RabbitListener 收消息,并以 JSON 作为统一的消息体格式。验证方式:看管理后台队列是否出现、消息是否被消费掉、unacked 是否归零。边界:如果多个服务共用同一个 virtual host,或者消费端不是 Java 技术栈,就需要先统一消息格式和确认模式,再动业务代码。
先确认当前场景和目标
动手之前,可以先用几分钟确认这几项,很多「整合不成功」在写代码前其实就能避免:
- MQ 服务是否已经可访问:Broker 的 AMQP 端口(通常 5672)和管理后台端口(通常 15672)是分开的,容器或云上部署时经常只映射了后者。
- 你用的是独立的 virtual host 还是默认的
/:vhost 不同,队列名相同也是两套数据,在本机测试非常容易把两者搞混。 - 账号是否有权限:RabbitMQ 的账号需要针对某个 vhost 配置 configure、write、read 三类权限;默认 guest 账号一般只允许本机连接,远程或容器内连接会被拒绝。
- 消息格式是否需要跨语言:如果消费端还有其他语言的程序,建议直接把消息体定为 JSON 字符串,不要让默认序列化把 Java 类信息带进去。
- 消费失败时你希望怎么做:丢弃、入死信队列还是重新投递,这决定了后续 ack/nack 的写法,最好先定下来。
如果以上都能回答清楚,那么整合就只是把配置和几段样板代码填对;如果有任意一项不确定,先在管理后台手工建一个队列发一条消息验证连通性,比直接调业务代码更快。
按这个顺序处理
1. 加依赖和连接配置
依赖只需要 AMQP starter,配置写在 application.yml 里,替换成你自己的主机、账号和 vhost 即可:
<dependency>
  <groupId>org.springframework.boot</groupId>
  <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
spring:
rabbitmq:
host: 127.0.0.1
port: 5672
username: app
password: 按实际填写
virtual-host: /biz
publisher-confirm-type: correlated
listener:
simple:
acknowledge-mode: manual
prefetch: 20prefetch 表示单个消费者一次最多预取多少条未确认消息,数值越大吞吐越高,但单条消息处理时间较长时容易积压在内存里,建议按处理耗时来调整。
2. 声明交换机、队列和绑定
让应用启动时声明资源,避免手工在后台创建导致名字不一致:
@Configuration
public class RabbitConfig {
    public static final String EXCHANGE = "demo.exchange";
    public static final String QUEUE = "demo.queue";
    public static final String KEY = "demo.key";

    @Bean
    public Queue demoQueue() {
        return QueueBuilder.durable(QUEUE).build();
    }

    @Bean
    public DirectExchange demoExchange() {
        return new DirectExchange(EXCHANGE, true, false);
    }

    @Bean
    public Binding demoBinding(Queue demoQueue, DirectExchange demoExchange) {
        return BindingBuilder.bind(demoQueue).to(demoExchange).with(KEY);
    }

    @Bean
    public MessageConverter jsonConverter() {
        return new Jackson2JsonMessageConverter();
    }
}
注意:如果队列已经由别人建过,且属性(比如是否持久化、是否有死信参数)与这里声明的不一致,应用启动会报 PRECONDITION_FAILED,这时应当以已存在的队列为准,删掉本地重复声明,而不是去删线上队列。
3. 写发送端
@Service
public class DemoSender {
    private final RabbitTemplate rabbitTemplate;

    public DemoSender(RabbitTemplate rabbitTemplate) {
        this.rabbitTemplate = rabbitTemplate;
    }

    public void send(String orderId) {
        rabbitTemplate.convertAndSend(RabbitConfig.EXCHANGE, RabbitConfig.KEY, new OrderMessage(orderId));
    }
}
发送成功只代表消息进了 Broker,不代表被消费;需要业务上强保证时,可以再加上 confirm 回调或本地消息表,这部分按你们的可靠性要求决定。
4. 写消费端并明确确认方式
@Component
public class DemoListener {
    @RabbitListener(queues = RabbitConfig.QUEUE)
    public void handle(OrderMessage msg, Channel channel,
                       @Header(AmqpHeaders.DELIVERY_TAG) long tag) throws IOException {
        try {
            // 处理业务
            channel.basicAck(tag, false);
        } catch (Exception e) {
            channel.basicNack(tag, false, false);
        }
    }
}
这里用的是手动确认:ack 表示处理完成,nack 的第三个参数决定是否重新入队。消费逻辑本身不稳定时,不建议直接设为 true 重回队列,否则容易陷入反复失败的死循环,通常改为进入死信队列再人工处理。
改完后怎么验证
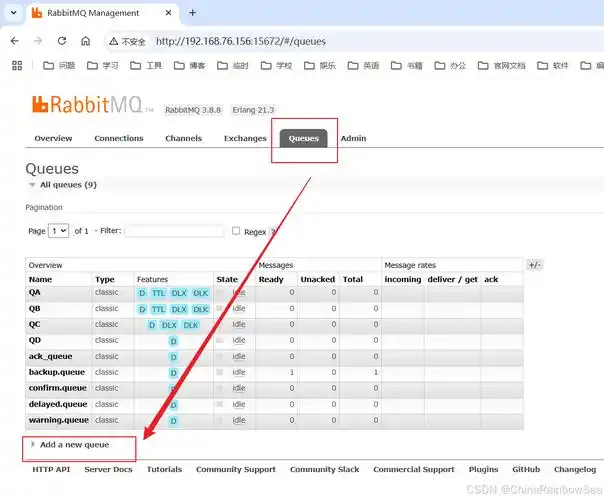
- 启动应用,看管理后台的 Queues 列表里是否出现
demo.queue,Exchanges 里是否有demo.exchange且绑定关系正确。 - 调用一次发送方法,观察队列的 Ready 数量是否短暂变为 1 并很快回到 0;如果一直停在 1,说明消费端没有连上或没在监听这个队列。
- 看消费端日志是否打印出消息内容;如果输出的是带类名的结构或报类型转换异常,说明发送端和消费端使用的 MessageConverter 不一致。
- 在消费方法里故意抛一次异常,观察 Unacked 数量是否下降、消息是进入死信还是消失,以此确认 ack/nack 分支真的按预期执行。
- 重启一次应用,确认没有 PRECONDITION_FAILED 之类的声明冲突报错。
预期信号是:Ready 与 Unacked 都回到 0,日志能打印出完整业务字段,失败消息的去向符合你设定的策略。
容易忽略的边界
- 端口混淆:5672 用于程序连接,15672 是 Web 管理后台,容器映射时两个都要暴露。
- 账号权限:guest 通常只允许本机连接,容器或远程部署需要用具备对应 vhost 权限的独立账号。
- 序列化兼容:Jackson2JsonMessageConverter 需要收发双方的类结构能对应;跨语言或类名变更时,建议改成显式发送 JSON 字符串,减少对类路径的依赖。
- 自动确认的风险:
acknowledge-mode为 auto 时,方法正常返回即视为确认,即使业务逻辑只是吞掉了异常,消息也不会重投,这对要求不丢消息的场景不适用。 - 大消息体:消息体积过大既影响 Broker 内存,也可能超过默认帧大小,超过阈值的内容通常改为存对象存储、队列里只传标识。
- 回退建议:如果暂时无法确认消费逻辑稳定性,可以先保留手动 ack + 死信队列的组合,把重试放到业务层控制;不建议用关闭确认或提高 prefetch 来掩盖处理失败。