在 M 系列芯片的 Mac 上跑本地大模型,真正要定的不是先装哪个 App,而是两件事:内存预算和推理后端。模型权重文件、上下文长度对应的 KV cache、系统与日常应用占用,这三部分都要落在同一块统一内存里;一旦超出,系统就会把内存换出到磁盘(swap),生成速度会降到很难正常使用的程度。所以配置的第一步是先做内存估算,再决定跑多大参数、多少量化、开多长上下文。
适用场景:单机、单人使用、以对话/代码补全/文档摘要为主的 macOS 本地推理。做法是先用通用运行时(Ollama、LM Studio 一类)验证硬件能否跑通,再按内存档位选量化和上下文,必要时换 llama.cpp 或 MLX 细调 GPU 卸载层数。验证看三点:生成速度是否稳定、活动监视器内存压力是否长期处于绿色、swap 是否持续增长。边界是统一内存与系统共享、无风扇机型长时间满载会降频;如果速度不达标,回退方向是降上下文、降量化或换更小的模型,而不是靠 swap 硬撑。
先确认当前场景和目标
先把自己的机器和任务写清楚,不然后面所有参数都没法判断。需要确认的信息包括:芯片型号和物理内存大小、macOS 大版本、模型主要用途(闲聊问答、代码补全、长文档摘要对上下文的要求差别很大)、是否需要给已有客户端提供 OpenAI 兼容接口、能接受的首字延迟和每秒生成 token 数大概是多少。
判断条件可以用一条粗算规则:量化后的模型文件大小 + 上下文带来的 KV cache + 系统预留,要明显小于物理内存。KV cache 随上下文长度和层数增长,开 32K 上下文和开 4K 上下文的内存占用不是一个量级。下面几条命令先把底数拿到,输出内容需要自己看,不要凭型号猜内存。
system_profiler SPHardwareDataType | grep -E "Chip|Memory"
sysctl -n hw.memsize        # 单位是字节
sw_vers                     # 确认 macOS 版本
sysctl -n hw.perflevel0.physicalcpu   # 性能核数量,线程数参考它
如果目标是“给 IDE 或自建工具提供本地接口”,那还要确认客户端是否只认 /v1/chat/completions 这类路径,这会直接决定你是用带兼容层的运行时,还是自己写一层转发。
按这个顺序处理
第一步,先用一个通用运行时验证硬件能跑通。装 Ollama 或 LM Studio,拉一个中等尺寸的量化模型,能正常出字再谈调优。这一步的意义是排除 Metal 后端、模型格式、权限这些基础问题,不要在还没跑通时就去改高级参数。
第二步,按内存档位选模型和量化。下面是偏保守的经验区间,具体还要结合你的上下文长度和同时开着的应用来确认:
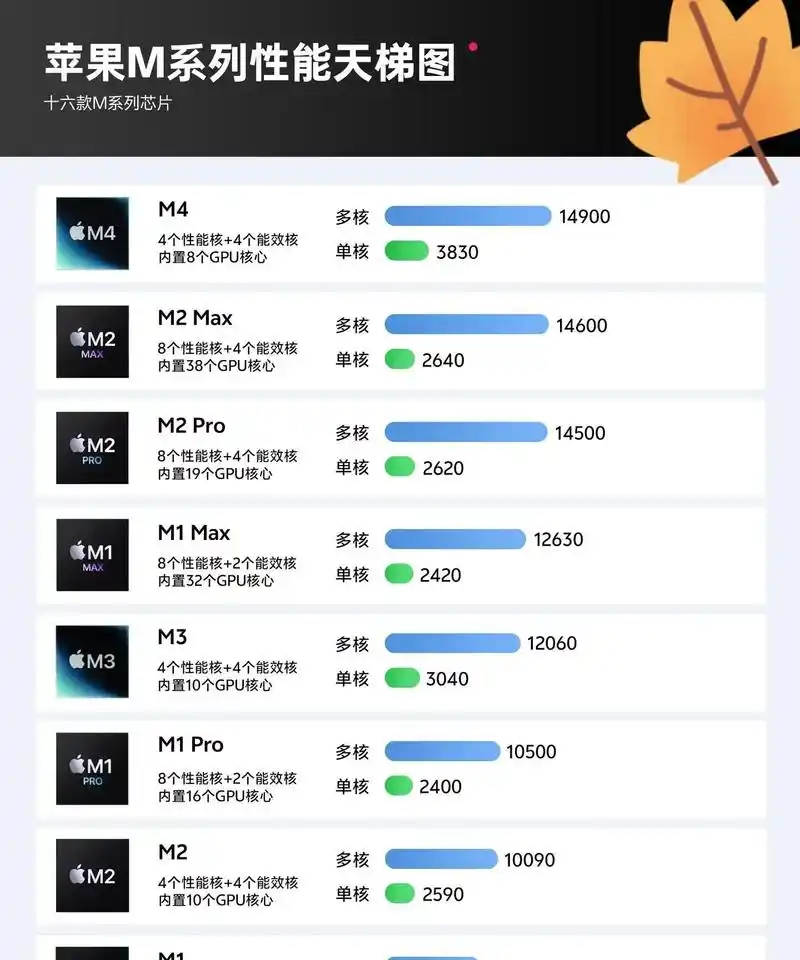
| 物理内存 | 建议起步 | 说明 |
|---|---|---|
| 16GB | 7B 级别 Q4 量化,上下文 4K | 给系统和浏览器留够余量,不建议开长上下文 |
| 32GB | 14B 级别 Q4,或 7B 级别更高精度 | 能开到 8K 上下文,仍要观察内存压力 |
| 64GB 及以上 | 30B 级别 Q4 可尝试 | 上下文仍建议从中等长度起步逐步加 |
第三步,用 llama.cpp 直接调 GPU 卸载层数和上下文。下面的片段是通用骨架,模型路径、量化文件名、上下文长度都要换成你实际的文件;-ngl 表示尽量把层放到 Metal 上,-c 是上下文长度,-t 参考上面查到的性能核数量。
./llama-cli -m ./models/你的模型-q4_k_m.gguf \
  -ngl 99 -c 4096 -b 512 -t 6 \
  -p "用三句话说明 KV cache 是什么"
如果你更依赖常驻服务和接口,用 Ollama 的 Modelfile 把参数固化,避免每次手敲:
FROM ./models/你的模型-q4_k_m.gguf
PARAMETER num_ctx 4096
PARAMETER num_gpu 99
PARAMETER num_thread 6

# 保存为 Modelfile 后执行
# ollama create 我的本地模型 -f Modelfile
# ollama run 我的本地模型第四步,接入客户端时用兼容接口。自建工具只需要把 base_url 指向本机运行时暴露的地址,模型名填你创建的那个。请求体用最小骨架先验证通路,确认能返回再叠加流式输出、工具调用这些能力。
curl -s http://127.0.0.1:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"我的本地模型","messages":[{"role":"user","content":"你好"}],"stream":false}'
端口以你实际运行时的配置为准,不要照抄。返回体里如果出现明显很短的响应或报错,先回到第三步检查模型是否加载成功。
改完后怎么验证
验证不要只看“能不能回话”,要同时看速度和内存两件事。
- 速度信号:llama.cpp 这类命令行工具在输出结束后会打印生成速度统计;用常驻服务时可以先加
--verbose观察一次完整请求的耗时。用一个固定 prompt 跑三次,看生成速度是否稳定,波动很大通常说明内存在换页或机器在降频。 - 卸载信号:
ollama ps可以看到模型是否整体放在 GPU 上;如果显示为部分 CPU 参与,说明当前参数下卸载不完整,可以适当降上下文或降量化。 - 内存信号:打开活动监视器看“内存压力”图表,再做一次同样的长回答。压力长期偏黄或偏红、或者 swap 使用量在涨,就说明配置已经越界,需要往里收。
- 接口信号:用上面的 curl 骨架连续请求五次,确认每次都返回合法 JSON,而不是第一次成功、后续超时。
对照目标是:固定 prompt 下生成速度稳定、内存压力不长期偏高、swap 基本不动、接口连续请求不失败。四项里有任何一项不满足,优先怀疑上下文长度和量化档位,而不是先去调线程数。
容易忽略的边界
统一内存是 CPU 和 GPU 共享的,浏览器、IDE、Docker 都在吃同一份预算;macOS 给 GPU 的可 wired 内存也有默认上限,不一定等于全部物理内存。需要调整时请用 sysctl iogpu.wired_limit_mb 这类参数,并明确这属于系统级改动,改之前先记录原值,出问题要能改回去。powermetrics 这类观察工具需要 sudo 权限,不要用管理员权限长期跑采集脚本。
无风扇机型(如 MacBook Air)长时间满载会降频,短测很快、连续跑十几分钟变慢是正常现象,不要把这种降速当成参数没调对。量化格式也不通用:GGUF 权重和 MLX 权重不能互相加载,换运行时就等于换模型文件。
不适合的情况也要说清楚:在笔记本的统一内存上做训练或全量微调不是这套配置的目标,多用户并发服务同样不适合;这两类需求应该考虑独立显存或专门的推理环境。如果调完仍然达不到可用速度,回退顺序建议是:先把上下文降到 4K 左右,再把量化从高精度换到 Q4 一档,最后才考虑换更小的参数规模。swap 只能救急,不能当成提速手段。