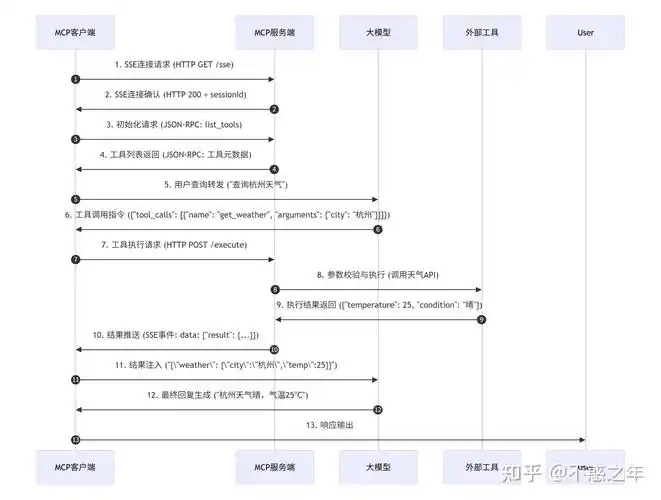
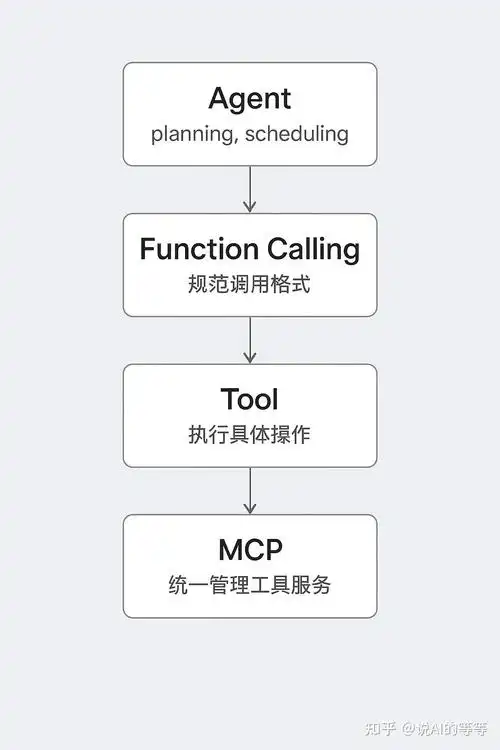
Function Calling 和 MCP 不在同一层,通常不是二选一的对立面:Function Calling 解决的是“模型如何用结构化参数表达要调哪个工具”,MCP 解决的是“工具和数据源以什么方式被客户端发现和调用”。如果你只是让一个模型调用自家两三个接口,先做 Function Calling 就够了;如果你要把工具复用到多个客户端、多个模型或独立部署的服务上,才值得抽一层 MCP。判断点在于调用方数量、工具变更频率和谁来维护这套集成。
先看三件事:模型是否支持工具调用、工具是否只在单一应用内使用、工具是否需要被多个客户端复用。单应用自用工具,直接写 Function Calling 定义并做参数校验即可;需要跨客户端复用或工具由别的团队维护时,把工具封装成 MCP 服务,由客户端发现后转成模型可用的工具列表。无论选哪种,都要保留参数校验和失败回退:模型侧能力缺失时,MCP 补不上;协议或客户端不兼容时,退回本地工具定义。最终以固定用例集上的工具选择与参数正确性作为验收信号。
先确认当前场景和目标
在动手写定义之前,先把下面几个事实确认清楚,它们直接决定选型,而不是靠偏好:
- 模型侧能力:所用的模型或 SDK 是否支持 tool/function calling 这类结构化调用输出。需要结合环境确认,不能假设所有模型都一样。如果模型只能输出纯文本,Function Calling 这条路要先换模型或加解析层,MCP 也不会自动解决这个问题。
- 调用方数量:工具只被一个应用调用,还是会被 CLI、IDE 插件、内部聊天入口等多个客户端调用。只有一方调用时,多引入一层协议通常是负担。
- 工具归属与变更频率:工具是自家代码顺手写的,还是由别的服务团队维护、接口会独立演进。后者更适合用协议层隔离。
- 运行形态:工具能否作为常驻进程或本地子进程启动,是否需要跨机器访问。这影响 MCP 服务怎么部署。
- 权限与审计:工具调用要不要记录谁在什么时候调了什么、凭据以什么身份使用。这部分需求在任何方案里都要单独设计,不能指望协议层自动兜住。
判断条件可以简化成一句:工具只服务一个应用、模型支持结构化调用,就先用 Function Calling;工具要被多个客户端复用、且需要独立版本管理,再引入 MCP,此时 Function Calling 仍然存在,只是工具列表来自 MCP 服务而不是硬编码。
按这个顺序处理
第一步,把所有工具摊平成清单,为每个工具写名称、用途描述和参数 schema。描述里写清“什么时候该用、什么时候不该用”,这是影响模型选择准确度的主要因素。下面是一段通用的工具定义样例,字段名按你所用 SDK 的约定替换:
{
  "name": "query_order",
  "description": "按订单号查询订单状态。仅当用户给出明确订单号时调用;用户只描述问题时不要调用",
  "parameters": {
    "type": "object",
    "properties": {
      "order_id": {"type": "string", "description": "订单号,纯数字,不要带前缀"}
    },
    "required": ["order_id"]
  }
}
第二步,单应用场景直接接 Function Calling。调用循环里必须做参数校验,把模型输出当成不可信输入处理;工具执行结果以结构化文本回填,不要抛异常给模型。下面只是骨架,函数名按实际 SDK 替换:
# 伪代码:call_model 和 run_tool 替换成你环境里的实际方法
resp = call_model(messages=messages, tools=[query_order_schema])
for call in resp.tool_calls:
    args = json.loads(call.arguments)
    check_against_schema(args, query_order_schema)   # 校验失败则回填错误说明
    result = run_tool(call.name, args)
    messages.append({"role": "tool", "tool_call_id": call.id, "content": result})
第三步,出现多客户端复用需求时,把工具挪进 MCP 服务,由客户端发现工具后转成模型可用的定义。此时原先写死的工具列表换成动态获取,校验逻辑不变:
# 伪代码:mcp_client 替换为你使用的客户端实现
remote_tools = mcp_client.list_tools()
tools_for_model = [to_function_schema(t) for t in remote_tools]
# 调用时由客户端转发到对应服务,返回值同样要过一遍 schema 校验与长度截断
第四步,补齐失败路径:工具名不存在、参数校验不通过、工具超时、返回体过大。这几类情况都建议转换成一句明确的文字结果回给模型,让模型有机会改参数重试或直接告诉用户做不到,而不是让整轮对话崩掉。
改完后怎么验证
验证不要只看一次对话是否顺畅,用一组固定用例跑,覆盖这些点:
- 该调用时调用:用户给出明确订单号,模型应发起 query_order 并带上正确参数。
- 不该调用时不调用:用户只是问“订单一般多久发货”,模型应直接回答,不发起工具调用。
- 参数非法:传入带前缀的订单号或空值,校验层应拦下并回填错误说明,而不是把请求打到下游。
- 工具报错:下游返回超时或空结果,模型应给出可理解的回复,不编造订单状态。
- 工具集合变化:MCP 场景下增删一个工具后,重新拉取列表,模型工具列表应同步更新,旧工具名不应再被调用。
预期信号是:日志里每次调用都能看到工具名、入参、校验结果和耗时;不需要工具的问答不会产生多余调用;错误路径有明确文字输出。如果观察到模型频繁选错工具,先改描述和参数命名,再考虑加路由或拆分工具,不要直接堆提示词。
容易忽略的边界
- 协议与客户端兼容性:MCP 服务端和客户端存在版本协商,需要结合环境确认客户端支持的范围。上线前先确认目标客户端能连上并正确列出工具,不要只在本地调试脚本里跑通过就算完成。
- 凭据范围:MCP 服务通常以自己的身份访问下游,不要把个人账号令牌直接塞进去;按最小权限单独申请凭据,并把调用记录和服务身份关联起来。
- 不适用条件:只有一个工具、一次性脚本、或者工具本身就是应用内部函数时,包一层 MCP 往往只增加部署和调试成本。反过来,模型不支持结构化调用时,MCP 也补不上模型侧能力。
- 回退建议:保留一份本地静态工具定义作为降级路径,MCP 服务不可达或客户端不兼容时切回本地定义,功能可以少一些,但对话不中断。降级开关要做成显式配置,并在日志里表明当前走的是哪条路径。
- 工具描述即接口:改描述可能改变模型行为,建议把工具定义和描述纳入版本管理,改动后重跑同一组用例再发布。