先分清一件事:内存涨不等于泄漏。可以照着操作的两条判断标准通常是同时成立——在不增加负载的前提下,经过一轮完整回收(GC、请求结束、连接释放)后内存仍然不回落;并且按时间采样时,进程 RSS 或 cgroup 匿名内存呈持续上升趋势,而不是阶跃之后保持平稳。这两条只满足一条时,先把采样数据留下来,不要急着改代码。
适用场景:单进程或容器内存随时间上涨,但不确定是真泄漏还是缓存、堆外内存、page cache 占位。操作动作:按“容器层→进程层→运行时层→代码分配层”逐层比对同一时间点的数字,只在上涨的那一层往下查。验证方式:用固定间隔采样 RSS 与 cgroup memory.current,看斜率是否单调;改完之后用同一脚本对比新旧斜率。边界:RSS 不降不等于泄漏,glibc arena 未归还和 page cache 都会让 RSS 看起来只涨不跌;容器限额与运行时上限不匹配时,堆 dump 里也看不出问题。
内存泄漏先定位在哪一层
从下往上依次是容器层、系统层、进程层、运行时层、代码层。哪一层的数字在涨,就只查那一层往下,不要跳层。
- 系统层:看
free -m的 available,不要看 free 列;再看/proc/meminfo里 Slab 与 SReclaimable 是否同步增长。available 长期稳定但 free 很小,通常是 page cache,不是泄漏。 - 容器层:看 cgroup v2 的
/sys/fs/cgroup/memory.current与/sys/fs/cgroup/memory.stat里的 anon、file。anon 持续涨才是进程自己占的;file 涨属于可回收缓存,OOM 前内核会先回收。 - 进程层:看
/proc/<pid>/status的 VmRSS 和 VmSwap。VmRSS 涨、VmSwap 也涨,说明内存压力已经被换出掩盖,实际占用可能比看到的更高。 - 运行时层:看 GC 日志或 heap 采样,判断回收后老年代或堆占用是否回落。回收后仍贴着上限,才算进入代码层。
- 代码层:只有前面几层都排除了,再去查对象存活、分配点、引用链。
判断依据只有一条:同一时间窗口内,哪一层的指标斜率持续为正。跨层数字对不上(比如容器 memory.current 涨但堆 used 不涨),往往说明问题在堆外或在缓存,不在业务对象上。
内存泄漏:先看这四个位置
- 日志:先看内核有没有杀过进程,执行
dmesg -T | grep -iE 'oom|killed process',或查看/var/log/kern.log;Java 进程打开 GC 日志,启动参数加-Xlog:gc*:file=/var/log/app/gc.log:time,uptime:filecount=5,filesize=50M,重启后即可从该文件比对每次 Full GC 后的 used。 - 命令输出:用下面这段脚本按分钟采样,先跑起来再谈结论。把
your-app换成实际进程的匹配串,日志写到/tmp/mem_watch.log。
再配合PID=$(pgrep -f 'your-app' | head -n1) while true; do ts=$(date '+%F %T') rss=$(awk '/VmRSS/{print $2}' /proc/$PID/status 2>/dev/null) swap=$(awk '/VmSwap/{print $2}' /proc/$PID/status 2>/dev/null) anon=$(awk '/^anon /{print $2}' /sys/fs/cgroup/memory.stat 2>/dev/null) echo "$ts pid=$PID rss_kb=$rss swap_kb=$swap anon_bytes=$anon" sleep 60 done >> /tmp/mem_watch.logpmap -x $PID | sort -k3 -n | tail -n 20看哪一段匿名内存在涨。 - 配置项:需要逐个核对进程实际生效值,而不是看默认值。Java 看
jcmd $PID VM.flags里的-Xmx、-XX:MaxDirectMemorySize、-XX:MaxMetaspaceSize;Go 看环境变量GOMEMLIMIT与GOGC;C/C++ 或依赖 glibc 的服务看MALLOC_ARENA_MAX;容器看编排文件里的 memory limit;连接池与本地缓存的 maxSize、TTL 在应用配置文件中确认。版本、默认值和限额这类会随版本变动的内容,以jcmd、systemctl show <unit>或对应版本自身的--help输出为准。 - 面板字段:容器场景看
container_memory_working_set_bytes,它比 usage 更接近 OOM 判定口径;同时看 JVM heap used、GC 后 used、线程数、打开的文件描述符数(ls /proc/$PID/fd | wc -l)。只看单一曲线容易误判,把 RSS 和堆 used 叠在同一张图上对比更直观。
内存泄漏:按可能性从高到低排除
- 无上限的本地缓存或连接池:确认动作是导出缓存条目数、连接池活跃连接数,看它是否随请求量单调增长。处理办法是给缓存加容量上限和 TTL,给连接池设 maxSize 与空闲回收。
- 容器限额与运行时上限不匹配:确认动作是对比
memory.current与堆 used 加MaxDirectMemorySize加 Metaspace 的合计;如果堆上限接近容器 limit,留不出堆外和线程栈的空间,就容易先被 OOM 杀掉。处理办法是把堆上限压到容器 limit 之下并留出余量。 - 线程、协程、连接、监听器没释放:确认动作是看线程数(
jcmd $PID Thread.print | grep -c '"')和 fd 数量是否随时间上升;Go 服务看curl http://127.0.0.1:PORT/debug/pprof/goroutine?debug=1的计数。处理办法是查未关闭的连接和未注销的监听。 - 堆外内存:确认动作是打开 Native Memory Tracking 后重启(
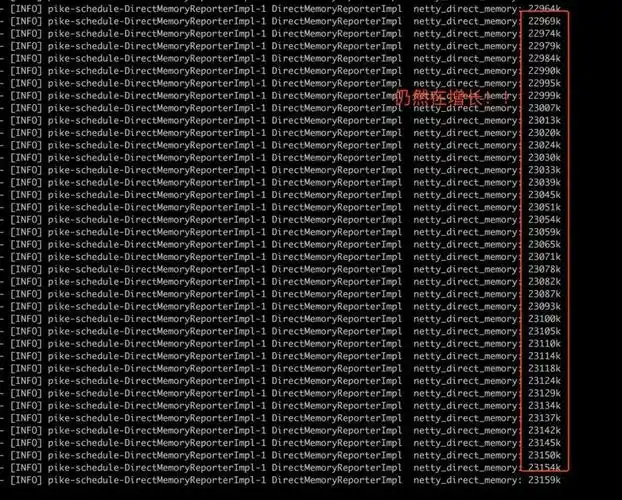
-XX:NativeMemoryTracking=summary),执行jcmd $PID VM.native_memory summary;或者用pmap -x看匿名段分布。这部分不会出现在 heap dump 里,最容易查错方向。 - 真正的对象引用泄漏:确认动作是连续触发两次回收后各取一次 heap,用
jmap -histo:live $PID | head -n 30对比实例数增量,再用jmap -dump:live,format=b,file=/tmp/heap.hprof $PID把 dump 拿下来做支配树分析。处理办法是找到持有引用的静态集合、ThreadLocal 或缓存,把强引用改弱引用或加清理。
一个常踩的坑:看到 free -m 的 free 很小就认定泄漏。Linux 会把空闲内存拿去做 page cache,available 才是可用量的参考;另外 glibc 多线程分配产生的 arena 在释放后未必归还给系统,RSS 会长时间保持高位。这两种情况下改业务代码基本无效,先看清 memory.stat 里 anon 和 file 的构成再说。
内存泄漏:改完怎么确认真的解决了
验证用同一套采样脚本,不要换口径。改前先留一份 /tmp/mem_watch.log,改后再跑一份,对比 RSS 与 anon 的斜率:改前是持续上升,改后应在一个水平区间内波动,并且 GC 后能回落到接近起点。
观察时长按原泄漏的速率倒推:如果原来一小时内能看出明显上涨,至少覆盖原来增长周期的数倍,通常建议不少于 24 小时并跨过一次业务高峰,否则低峰期的平稳说明不了问题。观察期间同时确认请求量和并发没有明显下降,负载变了,斜率对比就失去意义。
回滚办法要在改之前准备好:镜像保留上一个 tag 并确认可拉取;配置变更保存在版本库里,记录改前的完整文件和值;-Xmx、GOMEMLIMIT、缓存上限这类参数改动单独提交,回滚时只回退这一项。灰度时先回滚一个实例,观察 memory.current 与错误率恢复正常后再扩大范围;如果改前抓过 heap dump,保留到确认稳定再删,避免回滚后无从对照。