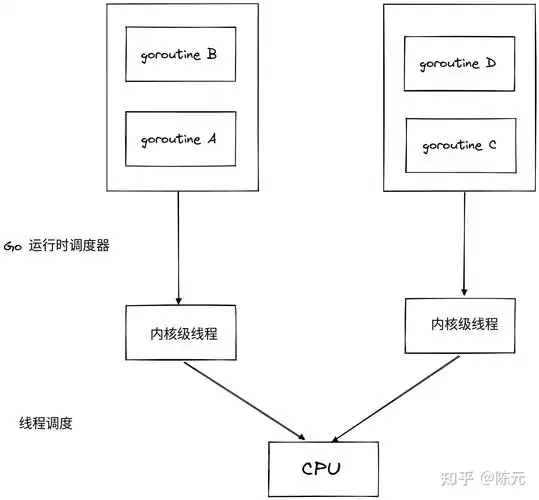
在 Go 里,大多数时候并不存在“goroutine 还是线程”这个二选一:业务代码写一个 go 语句,拿到的就是 goroutine,线程由运行时按 GOMAXPROCS 和阻塞情况自己管理。真正需要你判断的是另外几件事:这段逻辑要不要限制并发上限、有没有必须绑定线程的调用、是不是 CPU 密集到需要重新看并行度。goroutine 是 Go 运行时调度的用户态并发单元,线程是操作系统调度的执行单元;一个线程可以先后跑很多个 goroutine,只有在 cgo、某些需要固定线程的系统调用、或长时间占满 CPU 的循环里,两者的绑定关系才会影响你的写法。
如果任务在同一个 Go 进程内发起、以网络或磁盘等待为主,直接选 goroutine,用 channel 或信号量控制并发上限,不必手动管线程。只有涉及 cgo、需要固定线程的系统调用,或长时间占满 CPU 的计算循环,才需要关心 GOMAXPROCS 和 runtime.LockOSThread。先按受控并发跑起来,再用 -race、goroutine 数量和 trace 确认泄漏与调度情况,不要一上来就调参数。
先确认当前场景和目标
先把问题落到具体场景上,再谈选型。下面几条判断条件,建议按顺序过一遍,只要有一条成立,处理方式就会不同。
- 并发单元是否都在同一个 Go 进程内。跨进程、跨机器调度不属于 goroutine 和线程的比较范围,那是网络和队列的问题。
- 任务主要在等什么。等网络、等磁盘、等锁,goroutine 的创建和切换成本通常较低,可以开得比 CPU 核数多;纯计算循环则不同,goroutine 数量超过可并行执行的核数,通常只会增加调度开销。
- 是否调用 cgo 或依赖固定线程的系统调用。这类调用执行期间会占用一个线程,需要
runtime.LockOSThread时,goroutine 与线程就绑在一起了。 - 生命周期是否跟着请求走。要被取消、要能被回收的并发任务,应该带
context,否则容易留下无法退出的 goroutine。 - 是否需要限制并发上限。目标不是“能开多少个 goroutine”,而是“下游能承受多少并发”。
如果上面几条你都答得出来,说明场景已经清楚,可以直接进入下一步;如果答不出“任务主要在等什么”和“下游能承受多少并发”,先补这两个信息,选型结论会随之明确。
按这个顺序处理
第一步,先用 context + WaitGroup 写出可直接运行的骨架,把取消路径留出来。这一步不追求性能,只求逻辑正确、能退得干净。
ctx, cancel := context.WithCancel(context.Background())
defer cancel()

var wg sync.WaitGroup
for i := 0; i < n; i++ {
    wg.Add(1)
    go func(id int) {
        defer wg.Done()
        defer func() {
            if r := recover(); r != nil {
                // 记日志,不要让单个任务拖垮整个进程
            }
        }()
        handle(ctx, id)
    }(i)
}
wg.Wait()
第二步,加并发上限。这里的上限是并发任务数,不是线程数,也不是 GOMAXPROCS。用带缓冲的 channel 当信号量是最省事的做法,errgroup.SetLimit 是常见的替代写法。
sem := make(chan struct{}, 8) // 8 是并发上限,按下游承受能力调整
for _, task := range tasks {
    select {
    case <-ctx.Done():
        break
    case sem <- struct{}{}:
    }
    wg.Add(1)
    go func(t Task) {
        defer wg.Done()
        defer func() { <-sem }()
        handle(ctx, t)
    }(task)
}
第三步,判断要不要碰线程相关的东西。只有当调用 cgo、某些要求调用线程固定不变的库,或需要独占一个线程做特殊操作时,才在任务入口加 runtime.LockOSThread(),并在退出时 defer runtime.UnlockOSThread()。普通业务代码不需要这一步。
第四步,才考虑 GOMAXPROCS。默认值通常够用,只有在容器里 CPU 配额和运行时识别到的核数明显对不上,或 CPU 密集任务确实跑不满时,才去调整,并且改完要重新做一次验证。
改完后怎么验证
验证要围绕“会不会泄漏、有没有竞争、并发是否受控”三件事做,而不是看某个数字好不好看。
- 用
go test -race跑一遍相关包和用例,重点看共享变量、map、计数器是否被多个 goroutine 同时读写。输出报出竞争点就按栈信息改,不要靠加重试绕过。 - 在长跑前后打印
runtime.NumGoroutine(),观察任务结束后数量是否回落到接近起始水平。持续上涨且不回落,通常是某个 goroutine 阻塞在 channel、锁或未取消的 context 上。 - 取消请求后确认能退出:调用 cancel 后,
wg.Wait()应该在可接受的时间内返回。返回不了就是有任务没有监听ctx.Done()。 - 需要看调度行为时,用
go tool trace抓一段执行记录,或用GODEBUG=schedtrace=1000观察调度器周期性输出。这些输出字段随 Go 版本会有差异,看趋势即可,不要拿单次输出当结论。 - 压测时同时看延迟分布和内存占用。并发上限调高后延迟变差、内存上涨,说明瓶颈在下游或对象分配,而不是 goroutine 数量不够。
容易忽略的边界
goroutine 里未捕获的 panic 会终止整个进程,这一点和“线程崩了不影响别的线程”的直觉相反,所以每个入口都建议带上 recover 和日志。
goroutine 的栈初始很小、按需增长,单个开销低,但如果每个 goroutine 都持有大对象、长切片或者大缓冲,内存放大的效果同样明显。深递归和大局部变量也会让栈持续增长,不能只看“goroutine 很轻”这句结论。
绑定线程要成对出现。LockOSThread 之后忘记解锁,这个线程不会被其他 goroutine 复用;在 cgo 或阻塞型系统调用较多的场景下,线程数可能比预期增长得快,需要结合运行环境确认上限。
GOMAXPROCS 不是越大越好。CPU 密集任务下,超过可用核数的并行度通常会带来更多切换;较早的 Go 版本在容器中对 CPU 配额的识别也有限制,是否需要在启动时按配额设置,要结合自己使用的 Go 版本确认。
如果调整后发现下游压力过大或延迟抖动,优先回退并发上限,把 sem 的容量调小再观察,而不是继续加大 goroutine 数量。回退顺序建议是:先降并发上限,再检查是否有未取消的 context,最后才动 GOMAXPROCS。