Go HTTP 服务出现内存上涨时,最先要分清的是:Go 堆里的对象确实还在被引用、无法回收,还是 runtime 已经把内存标记为空闲、只是尚未归还给操作系统。这两种情况的处理路径完全不同。前者要改代码,后者多半只需调整观察口径或内存归还策略。建议先用一次堆采样和一次 goroutine 采样把问题归类,再决定是否动业务代码,不要在拿到证据之前就靠改 GC 参数把内存压下去。
排查 Go HTTP 服务内存泄漏,建议先在独立管理端口开 pprof,在相同负载下取两次间隔的inuse_space堆采样做差集,同时看 goroutine 数是否单调增长、强制 GC 后HeapAlloc是否回到基线。堆差集集中在业务调用栈,才按请求生命周期逐项排查;若堆本身平稳而 RSS 不降,更可能是 runtime 未归还内存或容器指标口径问题,不要误改代码。
先确认当前场景和目标
先确认现象的形状,再决定要不要按“泄漏”处理。RSS 单调爬升直到 OOMKilled 是一种;流量高峰后阶梯上升、随后长期不回落是另一种;还有一种是曲线平稳但容器 memory.current 接近 limit。三种情况对应的可疑点差别很大。
需要先拿到的信息:
- 进程的 RSS 曲线和容器的
oom_kill计数,判断是否真的会触发 OOM; - Go 版本、
GOGC、是否设置了GOMEMLIMIT,这些直接影响堆上限和归还行为; - 服务是否跑在 cgroup 内存限额的容器里,限额是否明显小于宿主机内存;
- 是否有 cgo 调用、大文件 mmap、大量
sync.Pool使用,这些会让 RSS 与 Go 堆对不上; - 能否复现:稳定压测流量,或至少有一个足够长的观察窗口。
判断条件可以先定成两条:一是每次强制 GC 后 HeapAlloc 是否回到近似基线,回不去说明仍有对象被引用;二是空闲时 NumGoroutine 是否随时间单调增长,增长通常意味着有 goroutine 卡在 channel、锁或网络读上。两条都不成立,就先按“未归还”方向查,而不是按泄漏查。
按这个顺序处理
1. 先开一个只在内网可达的管理端口
不要把 pprof 挂在面向公网的业务路由上。单独起一个监听地址,绑到 127.0.0.1 或内网网卡,用独立 mux 注册:
import (
    "net/http"
    "net/http/pprof"
)

func startAdmin(addr string) {
    mux := http.NewServeMux()
    mux.HandleFunc("/debug/pprof/", pprof.Index)
    mux.HandleFunc("/debug/pprof/heap", pprof.Handler("heap").ServeHTTP)
    mux.HandleFunc("/debug/pprof/goroutine", pprof.Handler("goroutine").ServeHTTP)
    go http.ListenAndServe(addr, mux) // addr 建议 127.0.0.1:6060
}
如果进程已经在跑,也可以先用 GODEBUG=gctrace=1 启动一次,观察每轮 GC 的堆大小是否在抬高,这一行日志足够判断“GC 后仍剩很多”。
2. 取两次堆采样做差集,而不是只看一次
单次堆采样只能看到当前占用的分布,看不出增长。建议在相同负载下间隔若干分钟各取一次,用 -base 对比:
curl -s -o /tmp/heap1.pprof "http://127.0.0.1:6060/debug/pprof/heap?gc=1"
# 保持同样负载,间隔一段时间后再取
curl -s -o /tmp/heap2.pprof "http://127.0.0.1:6060/debug/pprof/heap?gc=1"

go tool pprof -sample_index=inuse_space -base /tmp/heap1.pprof /tmp/heap2.pprof
差集里持续为正的调用栈才是嫌疑点。如果差集集中在 net/http 的读写缓冲、某个业务结构体的构造函数、或 encoding/json 的临时对象上,就往对应的请求处理路径查。
3. 同时取 goroutine 采样
curl -s -o /tmp/gor.pprof "http://127.0.0.1:6060/debug/pprof/goroutine?debug=2"
grep -c "^goroutine " /tmp/gor.pprof
隔一段时间再取一次,比较总数和重复出现的栈。大量 goroutine 停在同一个位置,通常比堆采样更直接地指向泄漏点。
4. 按常见模式逐项核对
下面几类在 Go HTTP 服务里反复出现,建议按清单过一遍,命中哪条改哪条:
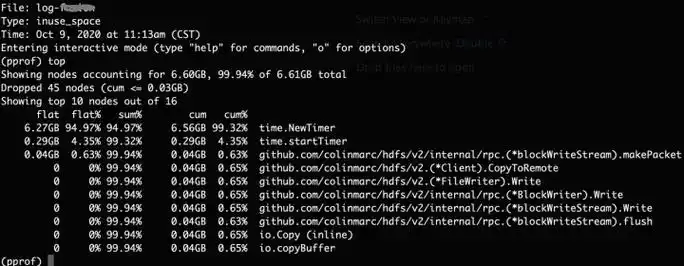
- 出站请求的
resp.Body没关闭,或关闭前没用io.Copy(io.Discard, resp.Body)读完,导致连接和缓冲滞留; - 循环里用
time.After建定时器,到期前不释放,改成复用一个time.NewTicker并defer ticker.Stop(); - 用全局
map或切片做缓存但没有淘汰策略,key 随请求参数无限增长; - 请求体没有用
http.MaxBytesReader之类的限制,单次大包把峰值抬高; - 每个请求都
template.Parse、regexp.MustCompile或新建客户端,把本可复用的对象放进包级变量; - 把请求级
context存进长生命周期的结构体,导致整条链路无法回收; - 自定义
http.Transport未设置连接复用相关参数,或每次请求都新建 Transport。
改的时候一次只改一处,保留改动前的采样文件,否则后面无法确认是哪条起的作用。
改完后怎么验证
验证要在相同或相近的负载下做,否则对比没有意义。建议的动作和预期信号:
- 用同样的压测或真实流量跑一段时间,重新取
inuse_space差集,原先持续为正的那个调用栈应不再单调增长。 - 停掉压测、等连接自然结束后再取一次 goroutine 数,应回落到接近启动时的水平;如果仍是高位,说明还有 goroutine 卡住。
- 手动触发一次 GC 后看
HeapAlloc,应能回到与启动阶段相近的量级,而不是停在一个越来越高的台阶上。 - 观察 RSS 的窗口要拉长。Go runtime 归还内存并不保证立即反映到 RSS,短期内 RSS 不降不能直接判定没修好,应看它是否停止单调上涨并最终进入平台期。
- 如果是多实例部署,先只改一台,对比这一台的 OOMKilled 次数、重启次数和 RSS 曲线,再决定是否全量。
容器里可以顺手对照 memory.current 与进程 RSS,确认限额和实际占用之间还有多少余量。
容易忽略的边界
几个容易把结论带偏的地方:
- 采样率限制:堆采样默认按一定字节数抽样,大量小对象的泄漏可能在差集里看不明显。可以临时调
runtime.MemProfileRate提高精度,但这会增加开销,只适合在预发或短时排查,用完改回。 - pprof 本身的开销与暴露风险:不要长期把管理端口暴露在公网或没有鉴权的路由上;采样期间 CPU 和内存都会有额外占用。
- RSS 不等于 Go 堆:cgo 分配、mmap 的文件映射、线程栈都不完整体现在堆采样里。堆采样干净但 RSS 继续涨,要往这些方向查。
- 内存归还策略差异:不同 Go 版本对空闲内存归还操作系统的行为不完全一致,容器里看到的 RSS 下降可能明显滞后。这属于观察口径问题,不要当成泄漏去改业务代码。
- sync.Pool 与缓存的边界:Pool 里的对象会计入堆,但属于预期占用;把 Pool 当成泄漏去删,反而会增加分配压力。
- 回退建议:如果一时定位不到具体调用栈,可以先用
GOMEMLIMIT或调整GOGC把堆上限压住,避免 OOM 影响可用性;这只是缓解手段,不能替代修复,且需要结合本机内存和容器限额确认取值,压得过低会带来更频繁的 GC。任何一处改动上线前都保留回滚路径。