消息堆积能不能“快速”清掉,取决于堆积是怎么形成的。同样是队列里几十万条消息,messages_ready 高说明没有消费者接得住,问题在消费能力;messages_unacknowledged 高说明消息已经投出去但没被确认,问题多半卡在消费端处理、预取设置或连接假死。先分清这两种,再决定是加消费者、调预取、换队列结构,还是直接丢弃,否则盲目加机器往往只是让下游更堵。
处理 RabbitMQ 堆积的建议路径:先用管理插件或 rabbitmqctl 看清 ready、unacked、consumers 三个指标,判断是消费能力不足还是消费端卡住;能加并发就加并发并下调 prefetch,处理逻辑支持批量就改成批量确认;确认消息可以丢弃时才用 purge_queue 或死信转移,这一步不可回退。改完后看 ready 是否持续下降、unacked 是否稳定在预取值附近、消费者错误日志是否清净。内存或磁盘告警、quorum 队列复制开销、下游数据库承压,都是加并发前必须先确认的边界。
先确认当前场景和目标
不是所有堆积都要“清空”。先确认三件事:这条队列承载的业务是否允许延迟、是否允许丢消息、消息是否有 TTL 或死信路由。允许丢的消息可以直接清,不允许丢的只能加速消费或转移,两者处理方式完全不同。
接着看队列的实际状态。用管理插件页面或命令行把关键指标拉出来:
# 查看指定 vhost 下队列的消息分布与消费者数
rabbitmqctl list_queues -p / name messages messages_ready \
  messages_unacknowledged consumers
如果不想登录节点,管理 HTTP API 也能拿到同样的字段,注意 vhost 需要 URL 编码,默认 vhost / 写作 %2F:
curl -u user:pass \
  http://rabbitmq-host:15672/api/queues/%2F/your_queue_name
判断条件可以按这个顺序过一遍:
consumers为 0:没人消费,先查消费者进程是否掉线、绑定的路由键和队列名是否对得上。messages_ready高、consumers正常:消费能力不足,考虑加并发或降低单条处理耗时。messages_unacknowledged接近或等于预取值乘以消费者数:消费端卡在处理环节,先查下游依赖和是否有消息一直不 ack。- 队列所在节点已经触发内存或磁盘告警:此时生产者可能被流控阻塞,先处理资源问题,别急着加消费者。
按这个顺序处理
第一步是把消费端的并发和预取调到一个合理区间。并发数不是越大越好,要按单条消息的处理耗时、下游数据库或第三方接口的承受能力来定;预取过大会让消费者一次拿太多消息压在内存里,预取过小则吞吐上不去。以 Java 客户端为例,AMQP 层面是 basicQos,Spring AMQP 对应的是监听容器参数,具体属性名请对照你使用的版本核对:
// 通用骨架,按实际客户端 SDK 调整
channel.basicQos(20);   // 单个消费者未确认消息上限

# Spring Boot 配置示例(属性名以所用版本为准)
spring.rabbitmq.listener.simple.prefetch=20
spring.rabbitmq.listener.simple.concurrency=4
spring.rabbitmq.listener.simple.max-concurrency=8
第二步看消费逻辑本身。单条消息里如果有同步远程调用、逐条写库、逐条发通知,这类耗时是最值得先砍的:能批量写就攒批写,能异步就挪到线程池,确认(ack)放在业务真正成功之后,避免“先 ack 后处理”造成丢消息。这一步通常比单纯加机器更有效,也更省资源。
第三步才是扩容。多实例消费同一条队列是可行的,但要确认消费端对重复投递是否幂等——RabbitMQ 是至少一次投递语义,消费失败重入、连接闪断重投都可能让同一条消息被处理两次。如果单队列吞吐已经到瓶颈,可以考虑按业务键拆成多条队列分流,而不是继续在一条队列上加消费者。
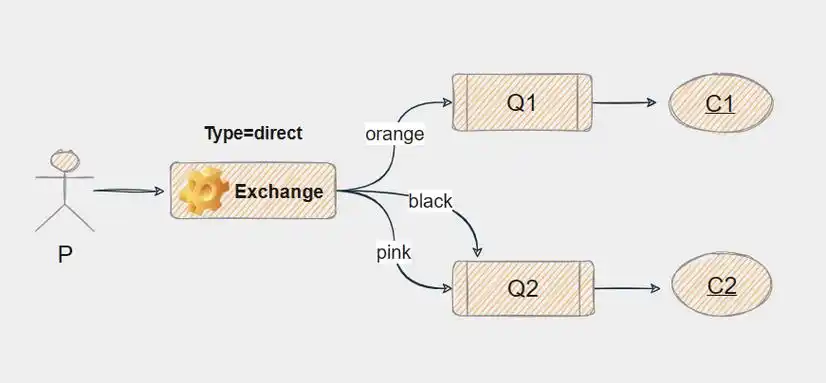
第四步是转移或丢弃,只在确认业务允许时做。把堆积消息转到临时队列慢慢消化,用 shovel 插件或自己写一个只负责转发的消费者都可以;直接清空则用下面的命令,执行前务必确认队列名和 vhost,这一步没有撤销:
# 高风险操作:清空队列内所有 ready 消息,不可恢复
rabbitmqctl purge_queue -p / your_queue_name
改完后怎么验证
验证不要只看一次数字,要看趋势。连续观察几分钟,确认 messages_ready 是单调下降而不是来回抖动;如果一边下降一边有新消息进来,要同时看生产速率和消费速率的关系,消费速率持续高于生产速率才算真正追上。
再看 messages_unacknowledged:它应该稳定在“消费者数 × 预取值”附近小幅波动。如果它持续顶到上限不动,说明消费端还是有卡点,加并发只会让更多消息卡在未确认状态。同时检查消费者日志里是否有反复重试、反序列化失败、连接被服务端断开这类记录,这类错误会让消息不断重回队列。
最后确认下游没有被拖垮:数据库连接池占用、慢查询数量、第三方接口的错误率,这些是判断“清理过程是否引发新问题”的直接信号。管理页面的消息速率图也可以作为辅助观察,但不要用单点数值下结论。
容易忽略的边界
清空队列看起来最省事,但它只适用于明确可以丢弃的消息。带有业务补偿、对账、通知性质的消息被清掉后,往往要靠人工补数据找回来,代价比慢慢消费高得多。
队列类型也影响处理方式。quorum 队列的每条消息需要多数节点确认,堆积时磁盘和网络开销比经典队列明显,大规模堆积下加消费者不一定线性见效;镜像队列在节点故障切换时也可能带来额外延迟。这些都需要结合集群的实际部署确认,不能照搬单机经验。
资源和权限方面,节点触发内存或磁盘告警时会阻塞生产者,此时清理堆积只是缓解表象;管理插件的账号权限、vhost 隔离、purge_queue 所需的配置权限也要提前确认,避免在生产环境执行到一半报权限错误。如果方案上线后 ready 仍不下降,回退方向是先恢复原来的并发和预取值,把消费端错误日志和下游指标排查清楚,再决定是继续扩容还是改为分流。