单体拆微服务不是“把代码按目录拆开再部署一遍”,而是先把业务边界、数据归属和调用关系理清,再逐步搬迁。判断这件事是否值得做、能不能做成,通常先看三个前提:单体内是否已有清晰的模块边界;团队是否有独立的发布和运维能力;业务是否真的存在“部分模块需要单独扩容或独立迭代”的压力。三者都不成立时,先做模块化和接口收敛,比直接上微服务更稳妥。
单体拆微服务一般按“识别边界—定接口—拆数据—独立部署—补可观测性—灰度迁移”推进,每一步都以可回退为前提。适用场景是模块耦合可辨、有独立发布诉求的系统;如果团队运维能力不足、事务强一致要求高、数据表高度交织,建议先做模块化单体,把拆分目标压缩到一两个边界最清晰的模块,验证接口和数据分离是否可行后再继续。
先确认当前场景和目标
动手前需要先确认几类信息,这些信息决定拆分是“按业务域拆”还是“按读写或按变更频率拆”。
- 业务边界:列出单体中的核心实体和它们之间的写操作关系。两个模块如果频繁在同一事务里改同一批表,通常不适合第一批拆出去。
- 变更频率:统计哪些模块改动最频繁、哪些模块几乎不动。优先拆改动频繁且影响面收敛的模块,迁移风险更可控。
- 扩容诉求:是否存在某个模块的负载明显高于其他模块,需要独立伸缩。没有这类诉求时,微服务带来的运维成本往往大于收益。
- 团队结构:拆分后每个服务是否有明确的负责人。无人长期维护的服务,拆出去只会把问题从代码里转移到部署和告警里。
- 一致性要求:确认哪些流程必须强一致。强一致流程在拆分会变成跨服务调用,需要用事务消息或补偿处理,不能默认“拆完再说”。
目标也要写成可判断的句子,例如“订单模块可以独立发布,不因商品模块改动而回归全站”,而不是“提升系统性能”。目标越具体,后面验证越容易。
按这个顺序处理
建议按下面的顺序推进,每一步都留出回退空间,不要一次性把所有模块迁走。
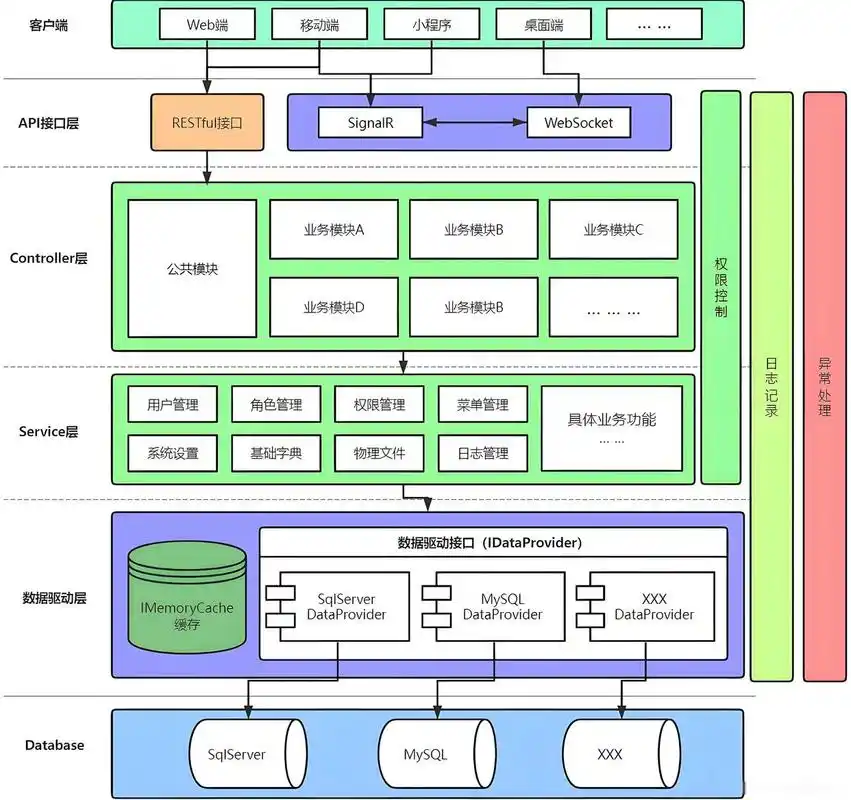
第一步:在单体内部先做模块化
先在原工程里按候选边界整理包结构,把跨模块的直接调用改为通过接口或门面调用,禁止跨模块直接访问对方的数据表。这一步不改变部署形态,但能提前暴露耦合点。可以用简单的依赖检查确认模块间是否还有越界调用。
# 示例:用 grep 粗略检查是否还有跨模块直接访问数据表
# 仅为检查思路,实际命令需按项目目录结构调整
grep -rn "from order_table" src/billing/ | head -50
第二步:确定服务边界和接口契约
为每个候选服务写出输入、输出和失败语义。契约要能回答:调用超时怎么处理、重复请求是否幂等、对方不可用时本服务返回什么。接口先以内部 HTTP 或消息的形式定义,不必急着选框架。
{
  "service": "order",
  "operation": "createOrder",
  "idempotencyKey": "client-provided-key",
  "timeoutMs": 3000,
  "onDownstreamFailure": "reject-or-queue"
}
上面这段是契约描述的骨架,用于和调用方对齐语义,不是某个框架的固定配置,落到项目里需要替换成实际字段。
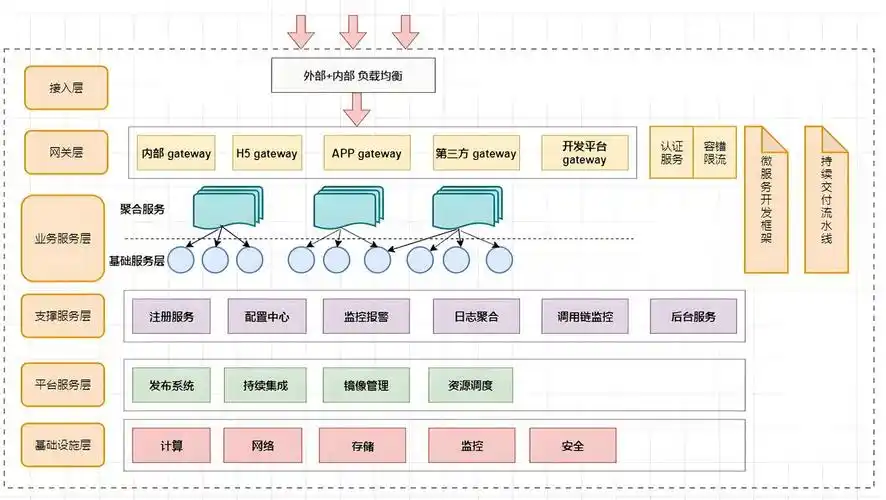
第三步:拆分数据归属
每个服务只拥有自己的表,其他服务通过接口读取。跨库查询改为接口聚合或冗余只读字段。数据拆分通常比代码拆分更难,建议先选一张关联较少的表做试点,确认双写或同步方案可行后再扩大范围。需要保留旧表一段时间作为对照,不要立刻删。
第四步:独立部署与调用治理
把选定的模块做成可独立启动的进程,补上超时、重试上限、熔断和限流。重试要配合幂等,否则会放大重复写入。服务发现和配置管理可以用现有基础设施,没有的话先用手工配置跑通链路。
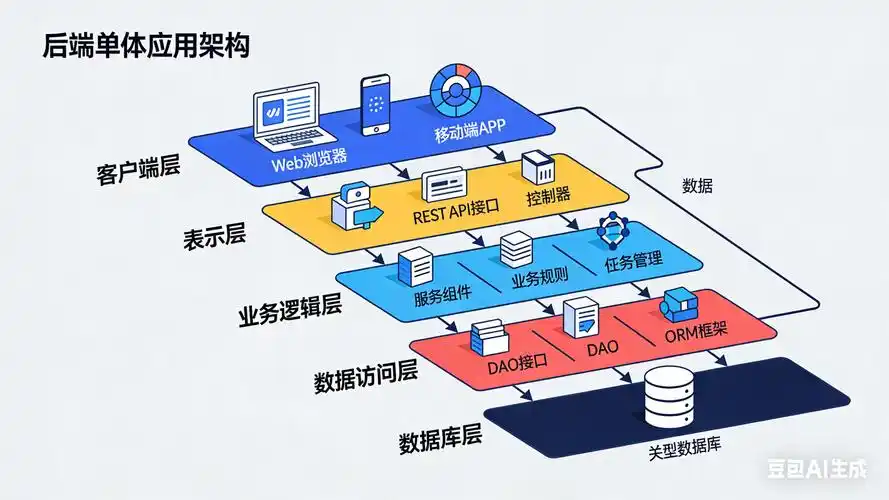
第五步:灰度迁移流量
通过开关或路由把一部分请求切到新服务,其余仍走单体。开关要能按请求维度回退,并记录切换状态,避免出现“一半旧逻辑一半新逻辑”却没人知道的情况。
改完后怎么验证
验证不能只看服务是否启动成功,重点看拆分后的行为是否和原来一致。
- 接口对照:对同一个业务请求,分别走单体和走新服务,比对返回结构和关键字段。可以准备一批固定输入做回归。
- 失败路径:人为让下游超时或返回错误,确认调用方按契约返回明确错误或进入队列,而不是静默丢数据。
- 数据一致性:抽样核对新服务写入的数据与旧表是否一致,重点检查跨服务流程中的补偿是否被触发。
- 可观测性:确认日志里能通过请求标识串起跨服务调用,告警能定位到具体服务而不是只报“接口异常”。
- 回退演练:实际执行一次开关回退,确认流量能切回单体且数据不冲突。
预期信号是:核心流程在新旧两条路径上结果一致,异常路径有明确处理,回退操作可在短时间内完成。若某项验证不通过,先停在该步骤修正,不要继续扩大拆分范围。
容易忽略的边界
- 强一致事务:原本在一个数据库事务里完成的流程,拆分后需要用消息或补偿实现,最终一致存在时间窗口。对账务、库存扣减这类场景,需要单独评估是否值得拆。
- 联表查询和报表:跨库联表会显著变复杂,通常改为数据同步到只读库或由服务提供聚合接口,报表口径要重新对齐。
- 分布式事务与重复消费:消息重投、网络超时都会造成重复处理,接口必须支持幂等,消费端要有去重依据。
- 运维成本:服务数量增加后,部署、日志、配置、证书和告警都成倍增加。团队没有相应工具链时,可以先只拆一个服务试运行。
- 不适用条件:业务规模小、团队人数少、模块间事务耦合深的系统,通常更适合继续做模块化单体。
- 回退建议:每个服务保留可切回单体的路由开关,数据和代码在观察期内保持双轨,确认稳定后再清理旧路径。回退方案要提前演练,不要等出问题再临时拼。