召回率低,先从“失败发生在哪一层”拆开,不要一上来就换嵌入模型或加 rerank。RAG 的召回失败通常有三类:目标文档根本不在索引里(切块切断了、同步漏了)、在索引里但 query 表述与文档措辞差异太大导致没被匹配到、被匹配到但排在第 20 名之外被 top-k 截断。三类的处理动作完全不同,先归类再改策略,能省掉大量无效调参。
RAG 召回率低的优化顺序建议是:先建一小组带标注的问题-文档对,把失败样本归因为“库中没有、切块丢失、表述不匹配、排序截断”四类;再按归因分别动切块、混合检索、query 改写和 top-k,而不是直接换模型。验证时固定同一批 query 比较 recall@k,并逐条复看失败样本;若语料更新频繁或索引无法同步重建,混合检索带来的收益会被脏索引抵消,需要保留纯向量路径作为回退。
先确认当前场景和目标
在动检索策略之前,需要先确认几件事实,否则改完也无法判断有没有变好。
- 有没有评测集:至少准备几十条真实用户问法和对应正确文档的问题对。没有的话,先把线上出现过的差评对话抽出来做一份,这一步的投入通常比调参更值。
- top-k 当前是多少:很多所谓“召回率低”,其实是 top-k=3 或 5 太窄,正确文档排在第 8 位。把 k 临时放大到 20 或 50 跑同一批问题,如果召回明显回升,说明问题在排序或截断,不在检索本身。
- 语料形态:长文档、FAQ 短条目、表格、代码块的处理方式差别很大。表格被按行切碎、标题层级丢失,都是常见的召回损失来源。
- query 特征:用户是口语化提问、还是带产品名和错误码的精确查询。后者对纯向量检索不友好,前者对纯关键词检索不友好。
- 可用元数据:是否有产品线、文档类型、时间、租户等字段可做前置过滤。有过滤条件时,先缩小候选池往往比改检索算法见效更快。
一个实用的归因判断:拿失败样本逐条看,正确文档在原始语料里能不能找到对应段落。找不到,是切块或同步问题;能找到但检索没命中,是表述匹配问题;命中了但排名靠后,是排序与截断问题。
按这个顺序处理
- 先把 top-k 与候选池放大,确认瓶颈位置。用同一批问题跑 k=5、10、20、50 的召回情况,记录正确文档是否进入候选池以及大致位次。只有确认“进池但排后”时,rerank 才有意义;没进池的样本,加 rerank 也救不回来。
- 调切块,按结构而不是按字数。优先在标题、段落、列表项边界切;表格保留表头一起切;给每个 chunk 带上来源标题和层级路径作为可检索文本的一部分。chunk 之间保留少量重叠,避免一句关键结论被切断。若文档较长,可考虑小块检索、返回时扩到所在父段落,减少上下文碎片化。
- 加关键词检索,做混合召回。含专有名词、编号、错误码、缩写的 query,全文检索往往比向量更稳。中文需要确认分词器对领域词的处理,必要时补充自定义词典。下面是通用骨架,函数名与字段按你实际使用的检索组件替换:
# 通用骨架:混合召回 + 融合去重 + 截断
# vector_store.search / keyword_index.search 需替换为你的实际实现
def retrieve(query, k=20, extra_filters=None):
    vec_hits = vector_store.search(embed(query), top_k=k, filters=extra_filters)
    kw_hits  = keyword_index.search(query, top_k=k, filters=extra_filters)

    # RRF 融合:只看名次,不看不同来源的分数量纲
    merged = {}
    for hits in (vec_hits, kw_hits):
        for rank, h in enumerate(hits):
            merged[h.doc_id] = merged.get(h.doc_id, 0.0) + 1.0 / (60 + rank)

    ordered = sorted(merged.items(), key=lambda x: x[1], reverse=True)
    return [doc_id for doc_id, _ in ordered[:k]]   # 再去取原文,避免重复拉取
融合后再去重、再截断。如果两侧命中的是同一篇文档的不同 chunk,建议在返回前按父文档合并,减少同一来源占满上下文。
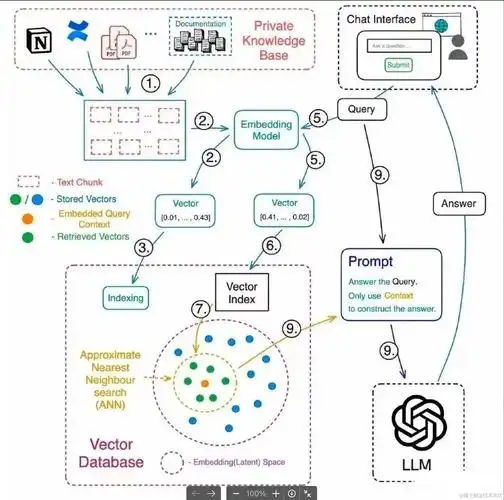
- 处理 query 侧。对口语化提问,可以先用一次轻量改写把口语转成领域术语再检索;也可以生成 2 到 3 个不同角度的子查询并行召回后合并。多查询会成倍增加检索开销,延迟敏感的链路要限制条数。
- 加前置路由与元数据过滤。先按产品线、文档类型或时间范围过滤,再做检索。过滤字段要在入库时写入,事后补字段通常要重建索引。
- 最后再考虑 rerank。在候选池足够大(例如 30 到 50 条)的前提下做精排,对“进池但排后”的样本帮助更明显。rerank 输入被截断时要注意,长 chunk 的关键句可能在尾部被切掉。
改完后怎么验证
验证的关键是控制变量:同一批评测问题、同一个 k、同一份语料快照,比较改动前后的 recall@k 和失败类型分布。只看平均值容易误判,逐条复看失败样本更有价值。
- 召回层面:原先失败的样本中,正确文档进入候选池的比例是否变化;正确文档在候选池中的位次是否前移;命中是否稳定(同一问题多跑几次结果是否一致)。
- 噪声层面:召回变多的同时,无关文档是否也大量涌入。若上下文被噪声占满,最终回答质量可能反而下降,需要同时看答案侧的表现。
- 成本与延迟:混合检索相当于每次多打一路索引,多查询则是成倍放大。记录检索耗时和送入模型的 token 量变化,确认在可接受范围内。
- 回归检查:保留一份不参与调参的盲测问题,只在新策略定稿后跑一次,避免对评测集过拟合。
预期信号是:原本“库里没有”的失败样本数量不变(这类要靠补数据解决),而“表述不匹配”和“排序截断”类样本减少。如果多数失败样本属于第一类,说明优化方向应该转向语料覆盖与解析质量,而不是继续调检索参数。
容易忽略的边界
- 切块策略改动必须重建索引。只改配置不重建,检索行为不会变。重建期间建议双索引并存,确认新索引可用后再切流量,旧索引保留一段时间作为回退。
- 关键词索引与向量索引要同步。文档更新、删除时如果只更了一侧,会出现召回到已下线内容或旧版本内容的脏命中。增量同步链路要能对账。
- 元数据过滤不是越严越好。字段填错或缺失会导致整批文档被过滤掉,表现为“突然召回不到”。过滤条件建议先宽松上线,观察命中分布后再收紧。
- 中文分词与同义词表需要维护。领域词被切碎会让关键词检索失效,同义词表长期不更新会逐渐偏离真实问法。
- 不适用情形:如果语料本身缺失、PDF 解析后正文大量丢失、或文档版本与用户问题不在同一时期,任何检索策略优化都只能有限改善,应优先修数据链路。