nvidia-smi 右上角显示的 CUDA Version 并不代表机器上装的是哪个版本的 CUDA Toolkit,而是当前驱动能够支持的最高 CUDA Runtime 版本。因此它和 nvcc --version、/usr/local/cuda 软链、pip 安装包里的 CUDA 运行时不一致,是常见现象,本身不构成故障。真正要判断的只有一件事:应用实际使用的 CUDA Runtime 版本有没有超过驱动支持的上限。没有超过,就按正常状态处理,不要为了「显示一致」去改环境;超过了,才需要升级驱动、调整运行时版本或更换容器基础镜像。
先分清三层版本:nvidia-smi 的 CUDA Version 是驱动支持上限,nvcc --version 是本机编译工具链,应用运行时的 CUDA 版本可能来自 pip wheel 或容器镜像。判断条件只有一条——运行时的 CUDA 版本不高于驱动支持上限即可正常工作。若程序报「CUDA driver version is insufficient for CUDA runtime version」,才说明越界,方向是升级驱动或降低运行时版本,而不是去改 nvidia-smi 的显示。
先确认当前场景和目标
先确认读者面对的是哪一类不一致,处理方式差别很大。请确认以下信息:
- 驱动侧:nvidia-smi 顶部的 Driver Version,以及右上角 CUDA Version。后者是驱动能支持的最高 Runtime 版本。
- 工具链侧:nvcc
--version输出的版本,以及 /usr/local/cuda 指向哪个目录。多版本并存时,软链指向和环境变量 PATH 可能不是同一套。 - 运行时侧:真正运行的程序链接的是哪份 libcudart。PyTorch 这类 pip 安装包通常自带 CUDA 运行时,与系统 nvcc 无关;自行编译的程序则依赖编译时的 Toolkit。
- 运行环境:是否在容器里。容器内的 nvidia-smi 读到的是宿主机驱动,镜像里的 Toolkit 版本是独立安装的。
判断条件可以归纳为:若「运行时 CUDA 版本 ≤ nvidia-smi 显示的 CUDA Version」,属于正常差异,不需要处理;若超过,或者程序已经报驱动版本不足,才进入修复流程。另外,如果只是 nvcc 与 nvidia-smi 数字不同,而程序运行正常,这仍然属于正常差异。
按这个顺序处理
第一步,把三项信息取全,不要只看一处就下结论。
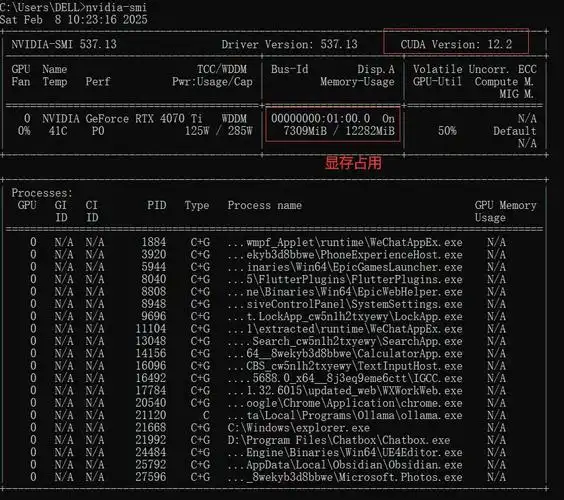
nvidia-smi
nvcc --version
cat /usr/local/cuda/version.json 2>/dev/null
ls -l /usr/local/cuda
ldconfig -p | grep libcudart
第二步,确认运行时实际版本。最直接的办法是调用 CUDA 的 driver API 和 runtime API 各取一次版本号,一次看清上限和实际值。下面这段代码需要在装有 CUDA Toolkit 的机器上用 nvcc 编译。
// ver.c
#include <stdio.h>
#include <cuda_runtime_api.h>
int main(void) {
    int drv = 0, rt = 0;
    cudaDriverGetVersion(&drv);
    cudaRuntimeGetVersion(&rt);
    printf("driver support: %d.%d\n", drv/1000, (drv%1000)/10);
    printf("runtime       : %d.%d\n", rt/1000, (rt%1000)/10);
    return 0;
}
// 编译:nvcc ver.c -o ver
// 运行:./ver
第三步,按结果分流。如果 driver support 大于等于 runtime,说明版本关系合法,应转去排查程序的其他报错,例如 GPU 架构是否被当前 Toolkit 支持、权限是否到位、显存是否不足。如果 driver support 小于 runtime,处理方向有三个,按代价从低到高排列:更换应用使用的 CUDA 运行时版本,比如换用对应 CUDA 版本的 pip wheel 或镜像 tag;在驱动侧安装厂商提供的 CUDA 兼容包,让旧驱动在有限范围内承载较新的运行时;升级显卡驱动,这一步通常需要 root 权限并重启,多人共用的机器需要提前约定时间窗口。
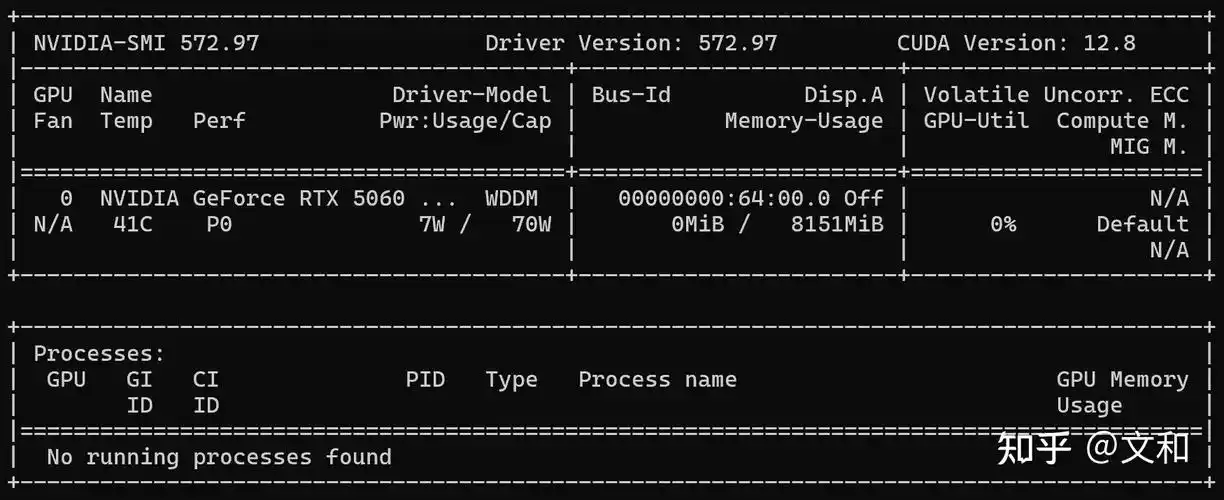
第四步,容器场景单独处理。镜像内的 Toolkit 版本可以随意,只要不高于宿主机驱动支持上限即可。若容器内 nvidia-smi 报错或缺失,问题出在容器运行时没有正确挂载驱动设备,处理方向是检查容器的显卡驱动挂载配置,而不是在镜像里再装一遍驱动。
改完后怎么验证
验证分三层,从底层往上走。
- 驱动层:重新执行 nvidia-smi,确认 Driver Version 已变化、没有报错,并记录新的 CUDA Version 上限。
- 运行时层:重新编译运行上面的 ver.c,或对 Python 环境执行
python -c "import torch; print(torch.__version__, torch.version.cuda, torch.cuda.is_available())",确认 runtime 数字不高于 driver support,且 cuda.is_available() 为 True。 - 应用层:跑一个最小可复现用例,例如一次小规模张量运算或一次推理请求,确认原先的「CUDA driver version is insufficient」类报错消失,进程能正常完成。
预期信号是:driver support 与 runtime 的关系由越界变为满足,应用不再因为版本关系中断。如果驱动升级后 nvidia-smi 正常、而应用仍然报错,通常说明问题不在驱动版本,需要回到程序本身的日志继续排查。注意升级驱动后第一次运行可能较慢,属于正常的模块加载过程,不宜据此判断是否生效。
容易忽略的边界
- 不要用改 /usr/local/cuda 软链的方式去「对齐」nvidia-smi 显示。软链影响的是编译期工具链,动过之后其他依赖旧 Toolkit 的项目可能编译失败;多版本环境建议通过环境变量或容器隔离来切换。
- pip 安装的深度学习框架多数自带 CUDA 运行时,升级系统驱动不一定改变程序使用的运行时版本,升级系统 nvcc 也不会。要换运行时版本,换对应版本的 wheel 更直接。
- 厂商提供的 CUDA 兼容包有版本适用范围,只覆盖特定区间的运行时与驱动组合,超出范围时不生效;同时它不是性能方案,只是让旧驱动能承载较新运行时的过渡手段。
- 较新的 Toolkit 可能不再支持老旧 GPU 架构。这种情况下驱动和运行时版本都对得上,程序仍会失败,需要改用该架构仍被支持的 Toolkit 版本。
- 驱动升级涉及重启,且在没有备份的共享机器上回退不便。建议先确认当前驱动版本号并记录,必要时通过系统包管理器保留可回退的旧版本。
- 若判断结论是「仅显示不一致、程序正常」,正确做法是不做任何改动,把这层差异当作正常的版本关系记录下来,避免为了统一显示引入新的兼容问题。