llama.cpp 加载 GGUF 模型文件的关键点,是让可执行程序、GGUF 文件和运行参数三者对应上:程序要能识别该 GGUF 的量化类型和架构,文件路径要能被正确读到,上下文、线程、显存卸载等参数要落在机器承受范围内。只把 .gguf 文件拖进目录通常不够,还要确认程序来自哪个版本分支、模型是否经过完整下载、启动输出里有没有正常打印模型元信息。GGUF 是 llama.cpp 使用的模型容器格式,加载动作由 llama.cpp 的 CLI 或服务端程序完成,并非独立工具完成。
把 GGUF 交给 llama.cpp 时,先确认三件事:可执行程序支持该 GGUF 的架构与量化,文件完整且路径可读,启动参数与内存/显存匹配。处理顺序是:检查程序能力 → 校验 GGUF 文件 → 用最小参数加载 → 观察日志中的元信息与首轮推理 → 再逐步加 GPU 卸载、上下文长度等参数。若启动报 unknown model architecture 或加载到一半失败,先回退到 CPU、减小上下文,再排查版本与量化兼容性,不要直接在原参数上反复加码。
先确认当前场景和目标
llama.cpp 加载 GGUF 的问题,通常出现在这种场景:手上已经有一个 .gguf 模型文件,想在本机或服务器上跑一次推理,但不确定该用哪个可执行程序、参数怎么给、加载失败时从哪里查。动手前,需要先确认以下信息,否则后面的报错很难归类。
- 模型来源与完整性:GGUF 文件是单文件还是被拆成多个分片(常见命名带 00001-of-0000x)。分片模型必须全部分片放在同一目录,只给第一个分片路径。
- 模型架构与量化:GGUF 元信息里记录了架构(如 llama、qwen2、gemma 等)和量化类型(如 Q4_K_M、Q8_0)。老版本 llama.cpp 可能不认识新架构或新量化。
- llama.cpp 的获取方式:是发行版预编译包、自己源码编译,还是某个封装工具的依赖。不同来源版本差异大,加载能力以你实际拿到的二进制为准。
- 硬件条件:纯 CPU、单卡 GPU 还是多卡;内存和显存是否足够放下模型加 KV cache。上下文长度越长,KV cache 占用越大。
这四类信息里任何一项不清楚,都可能把“参数问题”误判成“模型损坏”。建议先把模型文件名、大小、分片情况记录下来,再决定用哪个程序加载。
按这个顺序处理
下面是一个通用处理路径,具体命令名和参数名要以你本机程序的 --help 输出为准,不同版本存在参数改名或合并的情况。
1. 确认可执行程序存在且能运行
在 llama.cpp 目录或安装路径下,先运行帮助命令,确认程序能启动、能看到模型路径、上下文、GPU 层数等参数。如果连帮助都报动态库缺失,说明是运行环境问题,不是 GGUF 问题,应先解决依赖。
./llama-cli --help
# 或
./main --help
新版 llama.cpp 的主程序通常叫 llama-cli,较早版本叫 main;服务端程序通常叫 llama-server。以你目录中实际存在的文件为准。
2. 用最小参数加载一次
首次加载不要直接堆 GPU 参数,先用 CPU、短上下文跑通,排除模型文件本身的问题:
./llama-cli -m /path/to/model.gguf -p "hello" -n 32 -c 512参数含义:-m 指定 GGUF 路径,-p 给一段提示词,-n 限制生成 token 数,-c 指定上下文长度。分片模型只写第一个分片路径,程序会自动找同目录的其他分片。
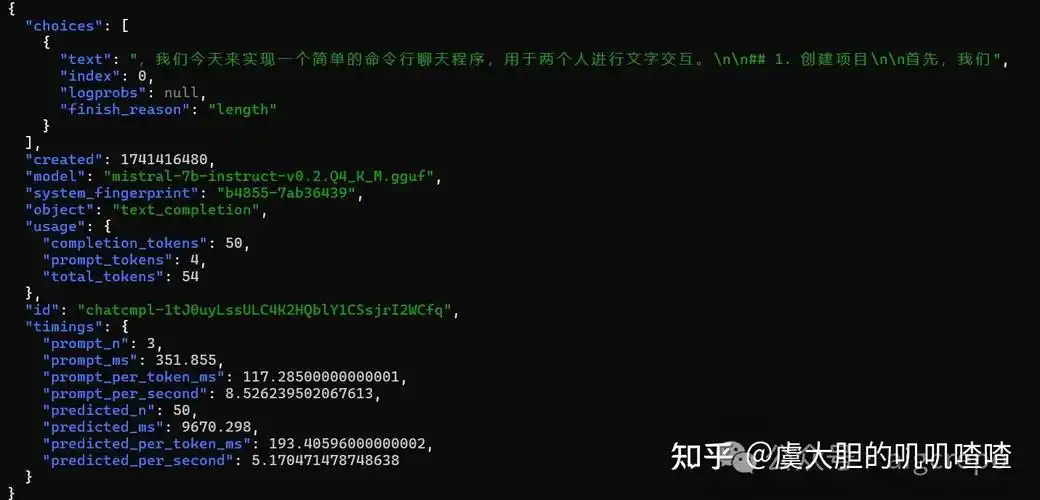
3. 观察启动日志中的模型元信息
正常加载时,日志会打印模型架构、参数规模、量化类型、层数、上下文长度上限、张量数量等信息,随后进入推理并输出生成内容。这些信息是你判断“加载成功”的主要依据。若日志在读取元信息阶段就报错,通常是文件不完整、格式不对或程序版本过旧。
4. 按需增加 GPU 卸载
CPU 跑通后,再逐步加 GPU 参数。常见做法是设置卸载到 GPU 的层数,从较小值开始,观察显存占用和加载是否成功:
./llama-cli -m /path/to/model.gguf -p "hello" -n 32 -c 2048 -ngl 20-ngl 表示卸载到 GPU 的层数。设置太大导致显存不足时,通常会看到分配失败或回退到 CPU 的日志。此时应减小层数或上下文长度,不要一次性开到模型全部层数。
5. 需要接口时改用服务端程序
如果要通过 HTTP 调用,用 llama-server 加载同一个 GGUF,加载逻辑相同,只是入口变成服务进程:
./llama-server -m /path/to/model.gguf -c 2048 -ngl 20 --host 127.0.0.1 --port 8080启动后先确认日志已加载模型并进入监听状态,再发请求验证。端口和监听地址按实际环境调整,对外暴露前需要确认访问控制。
改完后怎么验证
验证分两层:加载层和推理层。只看进程没退出不够,要看到模型元信息和正常输出。
- 加载层信号:日志中出现模型架构、量化类型、层数、上下文上限等元信息;没有 unknown architecture、failed to load model、invalid magic 之类的错误;分片模型要看到所有分片都被读取。
- 推理层信号:给一句简单提示词,能在合理时间内输出连贯文本;调整
-n后输出长度随之变化,说明生成循环正常。 - GPU 层信号:加
-ngl后,日志显示部分层被分配到 GPU;显存占用上升但未触发分配失败;输出质量与纯 CPU 一致。 - 服务端信号:llama-server 启动后监听端口,用一次最小请求确认能返回结果,再检查模型名或元信息接口是否可访问。
如果 CPU 能跑通、加 GPU 后失败,问题基本可以定位在显存或卸载层数上,而不在 GGUF 文件本身。这个对比是后续排查的重要依据。
容易忽略的边界
- 版本兼容性:新架构或新量化类型的 GGUF 需要较新的 llama.cpp 才能识别。用旧二进制加载新模型,常见表现是报未知架构或张量类型不支持。建议模型和程序来自相近时间段的发布,不要拿很久以前的程序加载新模型。
- 文件完整性:下载中断的 GGUF 可能大小对但张量损坏,加载到中途才报错。分片模型少一个分片同样会失败,需要核对分片数量和命名。
- 量化与内存的取舍:量化越低,内存占用通常越小,但输出质量和稳定性需要自己评估。不要为了塞进显存盲目选极低量化,也不要假设换量化能解决加载错误。
- 上下文长度的隐性成本:
-c设得越大,KV cache 占用越高,显存或内存不足会在加载后段或首轮推理时才暴露。建议先小后大。 - 权限与路径:容器、服务账户或沙箱环境下,程序可能读不到模型目录;路径含空格或非 ASCII 字符时,注意引号处理。
- 不适用与回退:如果目标是在受限设备上运行超大模型,靠调参数通常无法绕过资源上限,此时应换更小参数规模或更高压缩的量化模型。加载失败时,回退顺序建议是:回到最小 CPU 参数 → 换用与模型匹配的 llama.cpp 版本 → 重新校验文件完整性 → 再尝试 GPU 卸载。