单机多卡要选张量并行(TP)还是流水线并行(PP),关键不在于哪个“更先进”,而在于限制来自哪一层:如果单卡放不下整个模型、但单层还能放下,通常先上 TP;如果单层算子本身就超出单卡显存,或者卡数多到 TP 的集合通信成为瓶颈,才考虑 PP,或者 TP+PP 混合。卡数在单机 NVLink 域内、注意力头数能被卡数整除,是选 TP 的两个前提条件,先确认这两点再决定。
判断路径可以压成一句:单卡装得下模型只是吞吐不够,先用 DDP;单卡装不下但单层装得下,用 TP,且 TP 度数建议不超过可用注意力头数、尽量落在同一 NVLink 域;单层都装不下或 TP 通信压不住,再上 PP,并保证 micro-batch 数大于 stage 数。验证要同时看每卡显存是否均衡、单步耗时是否稳定、输出与单卡基线是否在容差内一致。
先确认当前场景和目标
先把范围缩小到“单机多卡”,并且明确是推理还是训练:训练还要额外容纳优化器状态、梯度和激活,显存压力通常比推理高一截;推理则主要看权重加 KV cache。以下几项信息必须逐条确认,缺一项都可能选错:
- 模型总量与最大单层:总参数量决定能否切分,最大单层的参数量(通常是 attention 投影或大的 FFN 层)决定 TP 是否够用。如果单层已经超过单卡显存,TP 很难救场,PP 才有意义。
- 卡数与互联条件:是否在同一台机器、是否处在同一 NVLink 域、是否被 NUMA 或 PCIe switch 隔开。TP 每一步都要做集合通信,对互联带宽敏感;PP 只在 stage 之间传激活,通信量小但存在空泡。
- 整除约束:TP 度数一般要能整除注意力头数和隐藏维度;PP 的 stage 数要能整除层数,否则需要做不均匀切分。
- 延迟或吞吐目标:推理场景下 PP 会增加首个 token 的等待时间,交互式服务一般更倾向 TP;离线批处理可以用 PP 换显存。
- 框架支持度:确认当前框架/推理引擎是否已实现自动 TP 或 PP,还是需要自己改模型代码。没有现成切分实现时,PP 的改造成本通常高于 TP。
按这个顺序处理
第一步,先粗估单卡显存,判断是否真的需要并行。不要凭参数量拍脑袋,直接从权重文件统计,再乘每参数字节数。
# 统计权重总参数量,放在模型目录同级执行
import glob
from safetensors import safe_open

total = 0
for f in glob.glob("model_dir/*.safetensors"):
    with safe_open(f, framework="pt") as sf:
        for k in sf.keys():
            total += sf.get_tensor(k).numel()

print("params:", total / 1e9, "B")
# fp16 权重约 total * 2 字节,int8 约 total * 1 字节
# 再额外留出 KV cache / 激活 / 通信缓冲的余量
如果按这个估算,单卡余量足够,只是吞吐不够,先上 DDP,不要过早引入 TP 或 PP 的复杂度。
第二步,单卡放不下但单层放得下,选 TP。把线性层按输入维或输出维切到各卡,每张卡只持有一部分权重,前向和反向各插入一次 all-reduce 或 all-gather。需要改模型代码时,典型做法是把 nn.Linear 换成按输出维切分的列并行版本:
# 列并行示意:每张卡只持有 out_features / tp_size 的输出通道
# 需替换:原始 Linear 层、tp_size、通信组初始化方式
import torch
import torch.nn as nn

class ColumnParallelLinear(nn.Module):
    def __init__(self, in_f, out_f, tp_size, tp_group):
        super().__init__()
        assert out_f % tp_size == 0
        self.tp_size = tp_size
        self.tp_group = tp_group
        self.rank = torch.distributed.get_rank(tp_group)
        self.weight = nn.Parameter(torch.empty(out_f // tp_size, in_f))

    def forward(self, x):
        out = x @ self.weight.t()
        # 行并行层不需要 gather;若下游是行并行层可直接传下去
        return out
启动时 TP 度数建议取 2、4、8 这类能覆盖注意力头数的值,例如 8 卡单机 TP=8 或 TP=4 各一组。如果没有现成的切分实现,优先用框架自带的 TP 能力,不要自己重写反向通信逻辑。
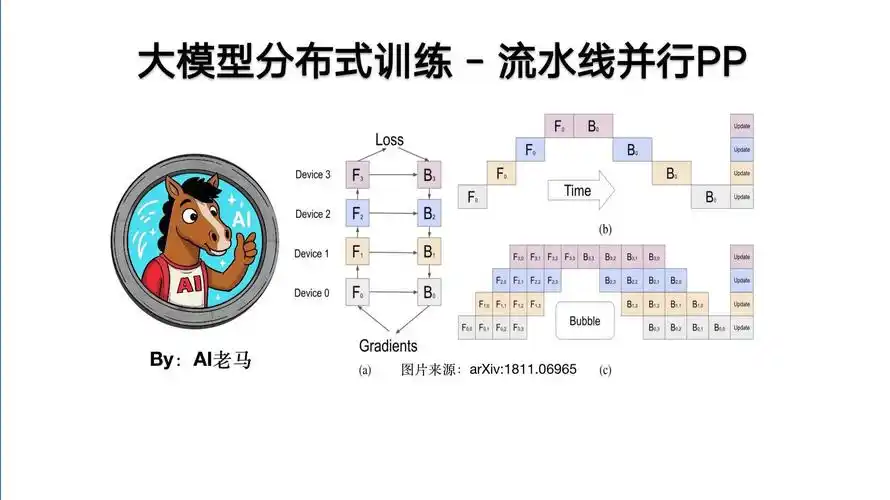
第三步,单层都放不下,或者 TP 通信已经成为瓶颈,改用 PP。把模型按层切成若干个 stage,每个进程只跑自己那段,激活在 stage 之间点对点传递。示意骨架:
# 流水线切分示意:按层均分到各 stage,需替换层列表和 pp_size
import torch.nn as nn

layers = model.layers          # 待切分的层列表
pp_size = 2
per = len(layers) // pp_size
stages = [nn.Sequential(*layers[i * per:(i + 1) * per]) for i in range(pp_size)]
local_stage = stages[pipe_rank].to(device)
# 首尾 stage 各自保留 embedding / lm_head,注意这两层显存不均衡
启动命令只改并行参数,其余保持不变,便于对比:
torchrun --nproc_per_node=8 --nnodes=1 train_or_serve.py \
  --tp_size 4 --pp_size 2 --micro_batches 8
# 替换:nproc_per_node 与机器卡数一致;micro_batches 建议大于 pp_size第四步,决定是否需要混合。单机 8 卡内,TP=8 常常已经够用;如果模型特别深、单卡仍吃紧,用 TP=2 或 4 叠 PP=4 或 2,比单纯加大 TP 更省通信。混合时先固定 PP 切分,再在 stage 内部开 TP,便于分别调参。
改完后怎么验证
并行配置改完,不要直接看吞吐,先确认“算得对”,再看“跑得快”。建议按下面顺序观察:
- 正确性对齐:固定一条小批量输入,用单卡基线跑一次 logits 或输出,再跑并行版本,用 torch.allclose 比较,容差按 dtype 选(fp16 可以放宽到 1e-3 量级)。数值差异过大通常说明切分维度或通信组接错了。
- 每卡显存是否均衡:nvidia-smi 或框架自带显存日志,逐卡看占用。TP 应该基本均匀;PP 常常因为 embedding、lm_head 落在首尾 stage 而偏高,需要单独确认。
- 是否出现 OOM 或重试:先跑较小 batch 跑通,再逐步加到目标 batch,观察显存峰值而不是平均值。
- 单步耗时与波动:记录若干步的 step time 和 token/s。TP 的预期信号是耗时随卡数下降但边际变缓;PP 的预期信号是显存明显下降但存在空泡,耗时不一定随卡数线性改善。
- 通信开销占比:用 profiler 或框架日志看集合通信或 stage 间传输的时间比例。如果通信占比接近甚至超过计算,说明并行策略不适合当前互联,需要回退。
训练场景还要多看一项:连续若干步的 loss 曲线,和单卡小规模基线的前若干步趋势相比不应出现明显跳变或持续发散。
容易忽略的边界
- 整除不成立时不要硬上:注意力头数或层数不能被并行度数整除,部分实现会直接报错,部分会静默补 padding,导致显存和计算浪费。此时优先换并行度,而不是改模型结构。
- 互联条件比卡数更重要:TP 在跨 NUMA 或走 PCIe switch 的卡间通信会明显变慢,同样 8 卡、拓扑不同结果可能完全不同。部署前确认卡是否在同一高带宽域,必要时用环境变量把进程绑到对应设备。
- PP 的空泡依赖 batch:micro-batch 数不大于 stage 数时,流水线几乎填不满,实际收益很小。交互式推理还需要接受首 token 延迟增加,这一点通常比吞吐更影响体验。
- 与 ZeRO、量化、推理引擎叠加时要重新验证:参数分片、权重量化、KV cache 分页策略都会改变显存分布,之前算好的 TP/PP 组合可能不再适用,升级框架后需要重跑前面的对齐验证。
- 回退路径要提前想好:如果 TP 通信压不住,回退到更小的 TP 度数加 PP;如果 PP 空泡太大,回退到 TP 加更小 batch。把权重 offload 到 CPU 或降低精度只适合当作临时止血,会带来额外传输开销,不建议当作长期的性能方案。