Redis 持久化文件变大,先要分清是「数据本来就有这么多」还是「重写机制没生效、写入历史堆积」。前者调参基本没用,只能从数据生命周期和实例拆分上想办法;后者才是 BGREWRITEAOF、auto-aof-rewrite-*、save 策略这些动作能解决的。所以在动任何配置之前,先把两个数字摆在一起看:info memory 里的 used_memory_human,和磁盘上 dump.rdb 或 appendonlydir 的实际体积。
持久化文件大小的判断标准是「文件体积和内存中有效数据量是否量级相当」。两者接近,说明文件大是数据量决定的,应优先考虑过期键清理、大 key 拆分和实例分片,而不是反复调 rewrite 参数;文件明显大于内存有效数据,通常是 AOF 重写未触发、关闭了 RDB 压缩或存在大量惰性过期键,可以先从 AOF 重写和 save 策略入手。所有改动建议先在从库或低峰期执行,并确认磁盘余量足够容纳新旧两份文件。
先确认当前场景和目标
这一步的目的是避免用错工具。先确认三件事:持久化类型、Redis 版本量级、以及你希望达成的目标。目标不同,处理手法完全不同——为了省磁盘、为了缩短重启加载时间、为了减少 fork 时的卡顿,三者的取舍并不一致,有时还会冲突。
- 持久化类型:只开了 RDB,还是 AOF 开着(Redis 7.0 起 AOF 在
appendonlydir目录下拆成 base 文件、incr 文件和 manifest,du要算整个目录,不要只看单个 aof 文件)。 - 数据规模:
dbsize、used_memory_human、maxmemory是否设置了上限。如果maxmemory为 0 且数据持续增长,文件变大只是结果,不是问题本身。 - 使用约束:是否允许重启、是否有从库可以承接持久化、磁盘剩余空间是否够重写期间新旧文件并存。
判断条件可以简化成一句:文件体积与 used_memory 在同一量级,说明是数据量导致;文件体积远大于内存有效数据,说明是历史增量或压缩策略导致。前者往下看数据与架构,后者往下看重写和参数。
按这个顺序处理
先量化,再定位,最后才改配置。顺序反了容易在没搞清成因的情况下关掉持久化,把磁盘问题换成数据安全问题。
第一步:把现状量出来
# 文件体积(AOF 要看整个目录)
du -sh /var/lib/redis/dump.rdb /var/lib/redis/appendonlydir 2>/dev/null

# 持久化状态与最近一次重写/落盘结果
redis-cli info persistence

# 内存与键数量
redis-cli info memory | grep -E 'used_memory_human|used_memory_peak_human'
redis-cli dbsize

# 相关参数
redis-cli config get save
redis-cli config get appendonly
redis-cli config get auto-aof-rewrite-percentage
redis-cli config get auto-aof-rewrite-min-size
redis-cli config get rdbcompression
redis-cli config get maxmemory
重点看 aof_current_size 与 aof_base_size 的比值、rdb_last_bgsave_status、aof_last_bgrewrite_status。如果重写状态长期不是 ok,或者 auto-aof-rewrite-percentage 被设成 0,AOF 只会一直追加,文件自然膨胀。
第二步:按成因选动作
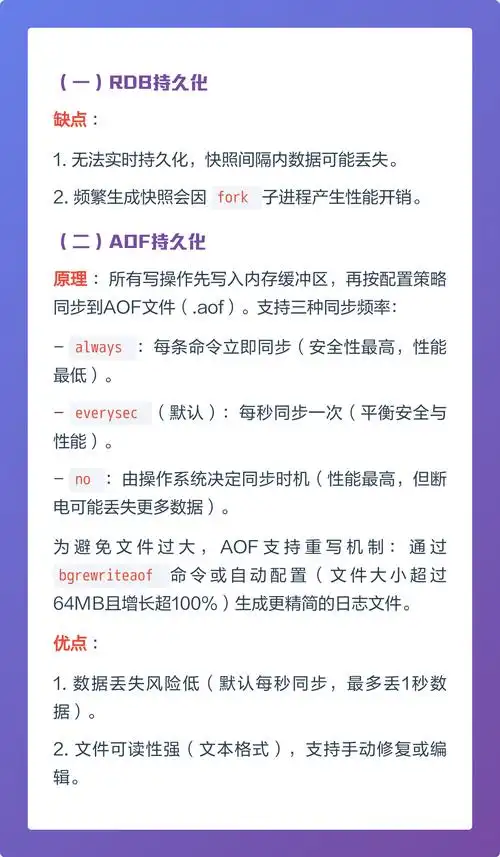
- AOF 只增不减:先手动触发一次重写
redis-cli bgrewriteaof,观察文件是否回落。若回落明显,说明是重写阈值问题,把auto-aof-rewrite-percentage和auto-aof-rewrite-min-size调到与数据量匹配的值,并确认aof-use-rdb-preamble处于开启状态(重写后的 base 文件用 RDB 格式,通常比纯文本 AOF 小)。 - RDB 体积大于内存有效数据:确认
rdbcompression是否被关掉;确认是否存在大量已过期但未被访问删除的键。Redis 的过期删除是惰性加定期采样,长期不访问的过期键会留在 RDB 里,重启后会以「已过期」状态重新参与清理,但文件里确实占着空间。 - 存在明显大 key:用
redis-cli --bigkeys(线上建议加-i控制扫描节奏)粗筛,再用MEMORY USAGE key确认。大 hash、大 list、大 zset 是一个文件里最占体积的部分,拆分这些键的收益通常比调参数更直接。 - 数据本身就该这么大:这时不要在单实例上反复折腾。可行的方向是按业务拆分实例或做分片,让每个实例的持久化文件回到可管理范围;另一个常见做法是把持久化集中到从库,主库按需关闭 RDB,但要评估主库宕机后的数据丢失窗口是否可接受。
改 save 策略时建议保守:先在从库上调整并观察一轮,确认没有影响复制和加载,再推到主库。修改后记得在配置文件里落地,仅用 config set 是临时的。
改完后怎么验证
验证的核心是确认三件事:文件确实变小了、重写/落盘链路正常、以及这次改动没有引入新的延迟问题。
- 文件体积:再执行一次
du -sh,对比改动前后的数值;AOF 还要看aof_current_size是否稳定在aof_base_size附近,而不是继续线性增长。 - 持久化状态:
info persistence中rdb_last_bgsave_status与aof_last_bgrewrite_status应为 ok,aof_rewrite_in_progress回到 0。若长时间卡在 1,先查磁盘空间和 fork 情况。 - fork 成本:看
latest_fork_usec的变化趋势。文件变小通常会让下次加载更快,但 fork 耗时更多取决于内存页规模,不要把它当作必然改善。 - 加载演练:在从库或预发环境用同一份文件实际启动一次,确认能正常加载、键数量与
dbsize对得上。这是唯一能确认「文件变小但没有丢数据」的动作。
预期信号是:文件体积回落到与有效数据量匹配的量级,重写周期稳定,加载时间在可接受范围内。如果体积回落但加载变慢,问题多半在键的数量而不是字节数,需要回头看大 key 和过期键。
容易忽略的边界
几处容易踩到的地方,动手前先确认:
- 磁盘余量:AOF 重写和 RDB 落盘期间会同时存在新旧两份文件,短暂占用接近两倍的磁盘。空间不足时重写会失败,反而留下更大的 incr 文件。建议先留出与当前文件体积相当的余量。
- fork 与内存:执行
bgrewriteaof或bgsave会 fork 子进程,写压力大时 COW 可能让实际内存占用上升。如果实例内存已接近上限且没有开maxmemory,建议在低峰期做,或先切到从库验证。 - 关闭持久化不是解决方案:为了避免文件大而直接关掉 AOF/RDB,等于把磁盘问题换成数据丢失问题。至少在从库保留一份,并确认主库宕机时的恢复路径。
- 版本兼容:Redis 7.0 之前 AOF 是单文件,7.0 起是多文件目录,运维脚本、备份任务和监控采集如果写死了
appendonly.aof路径,切换版本后会静默失效。混合使用 RDB 与 AOF 时,重启优先加载 AOF,改动其中一侧前要清楚这个优先级。 - 回退建议:调整
save或auto-aof-rewrite-*之前,先备份原配置文件并记录当前参数值,出问题时用config set逐项还原。已经执行的重写无法回退,所以第一次改动尽量放在从库或可重建的实例上。