搜「RabbitMQ 和 Kafka 的区别」的人,多数不是要从零选型,而是手上已经有一套或两套中间件,正在决定新需求接哪边,或者怀疑现有实现用错了方向。判断区别先别读对比表,先定位卡在哪一步:是路由与消费模型没弄清,还是吞吐、成本、运维没法估。下面按排查顺序给可核对的位置和可直接执行的命令,每一步都能在环境里验证。
建议先确认业务语义:需要复杂路由、逐条确认与重投递,偏 RabbitMQ;需要分区内顺序、历史回放、多消费组各自位点,偏 Kafka。用依赖文件、管理面板和 consumer group 位点核对现状,再在相同消息大小与确认模式下做小规模压测。没有本环境数据之前,不要拿别人的吞吐数字下结论。
RabbitMQ RocketMQ Kafka区别
这一步的典型状态是三个中间件都叫消息队列,分不清差异落在哪。确认是否卡在这一步:如果仓库里还没定客户端、部署清单里也没有对应镜像,说明还在选型;如果已有一套在跑、只是想确认够不够用,直接看第 5 节。可核对的位置是项目依赖文件、容器编排文件和各自的管理面,不是博客里的对比表。
# 1) 项目实际引入了哪些客户端(在仓库根目录执行)
grep -REn 'spring-kafka|kafka-clients|spring-rabbit|amqp-client|rocketmq-client' pom.xml build.gradle package.json go.mod 2>/dev/null

# 2) Kafka:topic 的分区、副本与消费组位点
kafka-topics.sh --bootstrap-server broker:9092 --describe --topic your-topic
kafka-consumer-groups.sh --bootstrap-server broker:9092 --describe --group your-group

# 3) RabbitMQ:队列积压与消费者数(在节点或容器内执行)
rabbitmqctl list_queues name messages messages_ready messages_unacknowledged consumers
三者的区分点不在能不能收发,而在两个可核对的事实。RabbitMQ 看管理插件 15672 端口 Exchanges 页的 Type 与 Bindings,路由规则写在 exchange 和 binding 上;Kafka 看 topic 的 partition 数与 consumer group 的 offset 列,进度按分区位点推进;RocketMQ 控制台看 topic 下的队列数和消费进度,思路接近 Kafka 但管理面不同。如果核对完发现项目里只有一种客户端,那三选一其实是伪问题,真正要解决的是现有中间件的用法。
Kafka和RabbitMQ的区别与优缺点
这一步通常发生在已经倾向 Kafka,或已有 Kafka 集群又要接入 RabbitMQ 的时候。确认方法很直接:看代码里写的是 @RabbitListener、basicConsume,还是 @KafkaListener、poll,再看配置里有没有 acknowledge-mode、enable-auto-commit、auto.offset.reset 这类开关。
可核对的位置有四个:消费者注解与监听容器配置;RabbitMQ 管理面板 Queues 页的 Ready、Unacked、Consumers 三列;Kafka 的 __consumer_offsets 内部 topic 是否在持续写入;kafka-consumer-groups.sh --describe 输出里的 LAG 列。LAG 持续增长而消费者进程正常,一般是消费逻辑慢或分区数不足,换中间件解决不了。
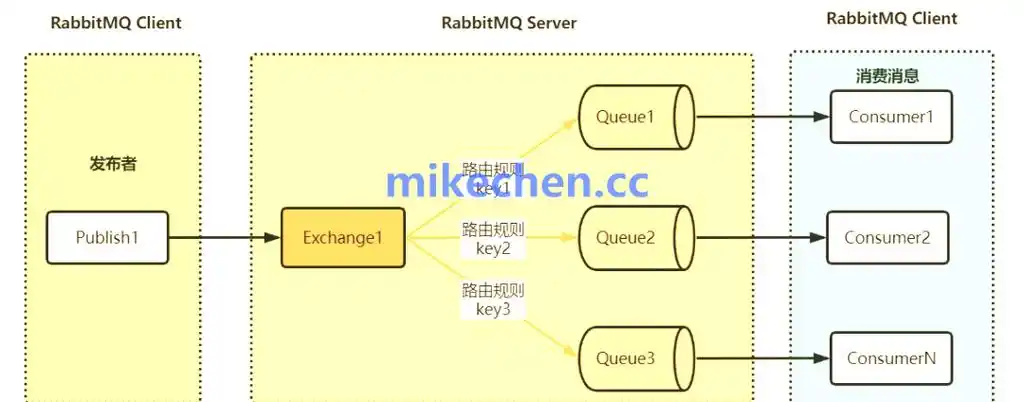
优缺点只在具体口径下成立。RabbitMQ 的长处是路由灵活,单条 ack、requeue、死信这套语义直观,适合按规则分发和逐条重试;代价是队列大量堆积时,内存与磁盘策略要专门配置。Kafka 的长处是分区日志带来的顺序与可回放,多个消费组各自维护位点;代价是要理解分区、rebalance 和位点提交,消费端一般按批处理。两边都不是装上就能用,差异主要在消费模型而不是部署难度。
最容易踩的坑:把 RabbitMQ 的队列当成 Kafka 的 topic,期望多个消费组各自读全量。RabbitMQ 同一队列内是竞争消费,一条消息只投给一个消费者;要做广播,得让每个消费者各有一个队列绑到同一个 exchange,核对位置是该 exchange 的 Bindings 列表。反过来,在 Kafka 里逐条提交 offset 再指望低延迟重试,也会抵消批量的意义。核对方式:kafka-consumer-groups.sh --describe 看每个 partition 对应的 CONSUMER-ID 是否唯一。
RabbitMQ和Kafka:各自站在什么位置
RabbitMQ 站在消息代理的位置:生产者发到 exchange,exchange 按 binding 投递到一个或多个 queue,消费者从 queue 取。它的判断口径写在 exchange 类型上,direct、topic、fanout、headers 四种各管一类路由,能不能实现某条投递规则,看管理面板 Exchanges 页的 Bindings 列表就能确认,不用猜。
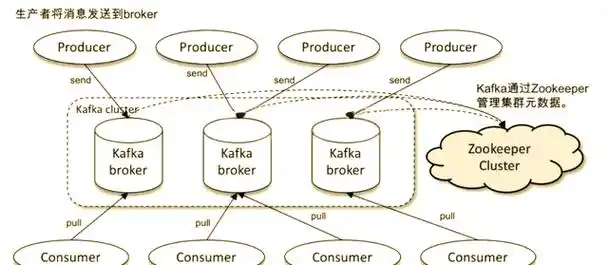
Kafka 站在分布式提交日志的位置:消息按 key 进入 partition 追加写,消费者用 group 加 offset 标记读到哪。判断口径看 topic 的分区数与保留配置,执行 kafka-configs.sh --bootstrap-server broker:9092 --describe --entity-type topics --entity-name your-topic,会列出 retention.ms、cleanup.policy 等项;顺序性只在同一 partition 内成立,取决于 key 和分区器的选择。
要做基准对比,Kafka 自带 kafka-producer-perf-test.sh 和 kafka-consumer-perf-test.sh;RabbitMQ 侧一般用 rabbitmq-perf-test(需要另行安装)或直接看管理面板 Overview 的 message rates 曲线。跑的时候固定消息大小、确认模式、持久化开关和消费者数量,否则数字没有比较意义。这些结果只代表当次环境,作为方向参考,不要当成结论外推。
RabbitMQ和Kafka:性能、成本、运维、上手四个口径分开比
性能
量法:Kafka 用 kafka-producer-perf-test.sh --topic t --num-records 100000 --record-size 1024 --throughput -1 --producer-props bootstrap.servers=broker:9092 跑一轮,再改 record-size 和 acks 复跑;RabbitMQ 用 rabbitmq-perf-test 指定生产者消费者数量和消息大小,或读管理面板的 publish、deliver 速率。要固定持久化与 ack 设置,否则比较对象不一致。延迟看 p99,不要只看平均值,两边尽量同机同网测试。
成本
成本分机器和人力。Kafka 的磁盘占用取决于 retention 与副本数,可以看 topic 的保留配置,host 上用 kafka-log-dirs.sh --describe 列各目录大小;RabbitMQ 的堆积策略影响内存和磁盘,看管理面板 Overview 的内存告警阈值与队列是否走 lazy 策略。用云托管时,价格以对应产品页的计费项与实例规格页为准,注意区分按实例规格计费和按消息量计费,页面价格随区域变动,结算以控制台订单为准。
运维
Kafka 盯 UnderReplicatedPartitions 和 kafka-topics.sh --describe 输出里 Isr 与 Replicas 是否一致,扩分区时要注意带 key 的消息分布会变;RabbitMQ 盯队列堆积、内存与磁盘告警,用 rabbitmqctl status 或管理面板顶部的告警条确认,集群模式与队列类型(classic、quorum)要提前定。升级前建议先看官方文档对应版本的升级说明,版本差异需要结合自己的环境确认。
上手
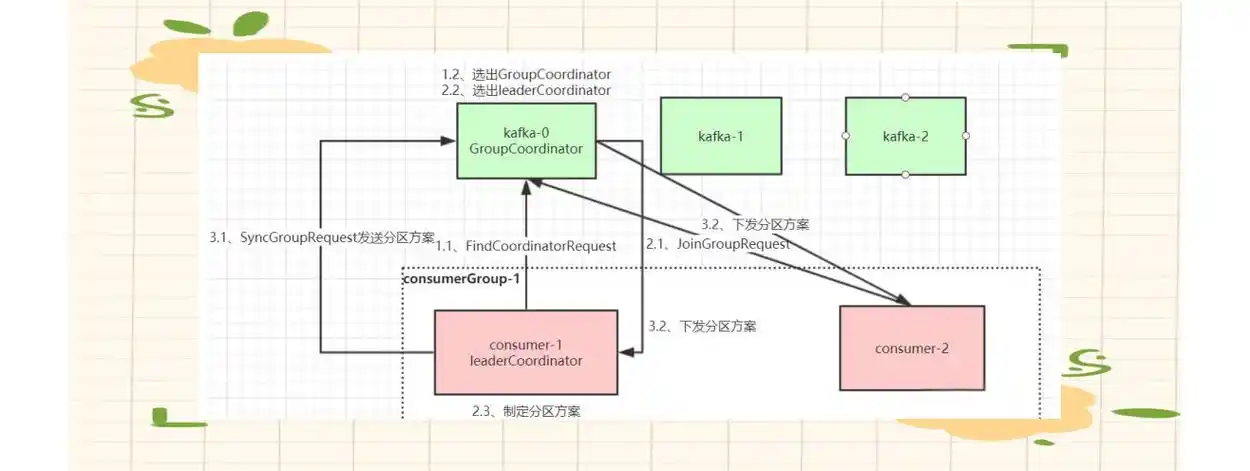
RabbitMQ 概念少,本地起一个带管理插件的容器,浏览器进 15672 就能看到 exchange 和 queue,一次收发的链路很快能跑通;Kafka 要先理解 partition、consumer group、offset 提交和 rebalance,本地起单节点后建议先用 kafka-console-producer 与 kafka-console-consumer --group 手动发几条,观察 LAG 列的变化。判断自己是否过关:能不能不查文档说出消息落在哪个队列或哪个分区、消费失败后重投递发生在哪里。
RabbitMQ和Kafka:什么情况选哪一边
后台任务分发、需要按规则路由到多个下游、失败要逐条重试或延迟重试,消息量在单机可承受范围,选 RabbitMQ。前置条件是团队能维护对应运行时或直接使用托管实例,消费端实现了幂等和死信处理。验证方式:测试环境配好 DLX 与 TTL,人为制造消费异常,确认管理面板 Unacked 与死信队列的变化符合预期。
事件采集、日志或变更数据流入下游、需要回放历史数据、多个消费组各读各的,选 Kafka。前置条件是有磁盘和分区规划、能接受位点与 rebalance 的运维成本、消费端按批处理。验证方式:用 perf 工具在目标分区数下跑一轮,并确认 kafka-consumer-groups.sh --describe 的 LAG 能接进监控。
已有其中一套集群且运行稳定,新需求只是小流量时,先复用现有中间件,除非新需求的语义明显不匹配,比如要回放却只有 RabbitMQ,或要复杂路由却只有 Kafka。前置条件:把新需求的消息量、保留时长、消费方式列成表,逐项对照现有集群配置,确认容量和语义都能覆盖再动手,否则改造成本通常比选型本身更高。