搜「Zabbix和Prometheus的区别」的人,通常不是要一份产品介绍,而是手里有一批要监控的对象,不确定该上哪一套;或者已经在用其中一套,被采集频率、标签基数、历史数据占用这些细节卡住,想找一个十分钟内能自己跑出来、看得见差异的对比办法。下面按实际排查顺序给判断口径和可直接执行的命令。
Zabbix 是配置驱动的采集、存储、告警一体化平台,强项在固定资产:主机、网络设备、SNMP、模板化巡检。Prometheus 是拉取式时序库加标签查询,强项在频繁变化的实例和需要自由聚合的应用指标。先按“被监控对象是否频繁增删、是否需要多维度聚合”筛掉一边,再用 node_exporter 做一次十分钟对比,看采集模型和数据结构差异。两套并存时不要让它们互相镜像采集同一批指标,否则历史数据和告警都会重复。
Zabbix和Prometheus:各自站在什么位置
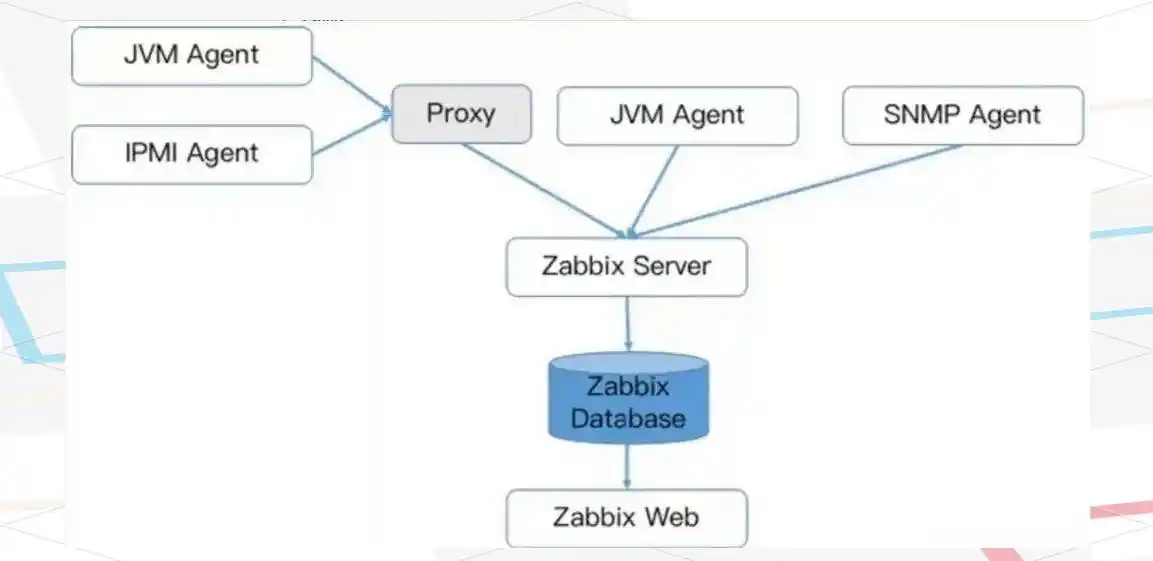
Zabbix 的重心是“一台设备对应一组配置”。在 Zabbix 前端给主机挂模板,模板里是一个个 Item,Item 的 type 决定采集方式,常见的有 Zabbix agent、Zabbix agent (active)、SNMP、trapper 等;服务端能开多少采集进程由 zabbix_server.conf 里的 StartPollers、StartPreprocessors 控制。能核对的判断口径是:打开“数据采集 → 主机”,看一台机器挂了几个模板、多少个 Item、Item 类型分布如何,再对照 zabbix_server.conf 的进程数配置,就能判断这套部署更偏主机巡检还是偏被动上报。
Prometheus 的重心是“一个目标对应一个 /metrics 端点”。谁被抓、多久抓一次、带什么标签,全在 prometheus.yml 的 scrape_configs 里。能核对的判断口径是 promtool check config prometheus.yml 是否通过,以及 Prometheus 页面 Targets 里每个目标的 up 状态和最近一次抓取耗时。这两条口径都不依赖版本,换环境也能复现。
Zabbix和Prometheus:性能、成本、运维、上手四个口径分开比
性能
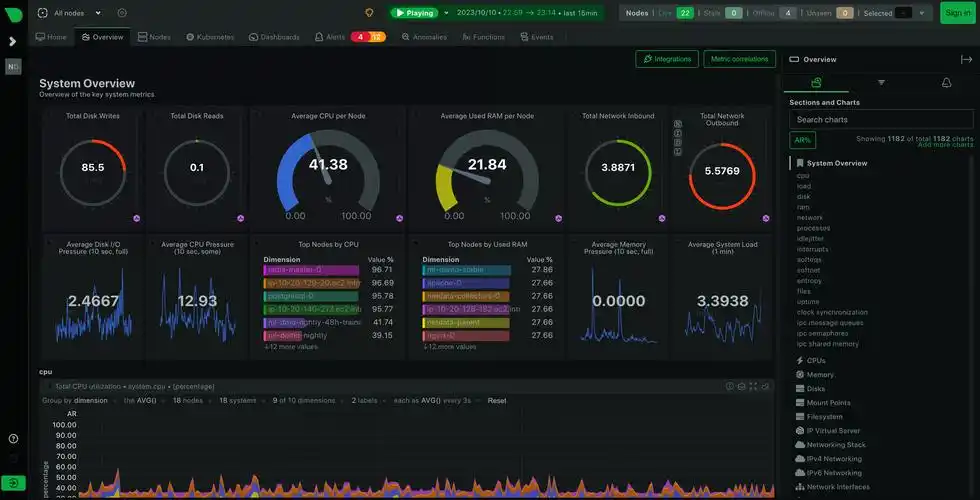
Zabbix 看的是每秒写入值数(NVPS),可以从服务端的内部监控项 zabbix[wcache,values] 观察,也可以在自己搭的测试实例上用 zabbix_sender 灌一批 trapper 数据看写入队列。Prometheus 看的是活跃序列数和单次抓取耗时,查询方式:
curl -s 'http://127.0.0.1:9090/api/v1/query?query=prometheus_tsdb_head_series'
curl -s 'http://127.0.0.1:9090/api/v1/query?query=scrape_duration_seconds'
两边压力来源不同:Zabbix 的压力主要落在关系库写入和 poller 进程上,Prometheus 的压力主要落在序列基数上。所以比较性能时不能只比“能采多少台”,要先固定采集间隔和指标数量再比。
成本
Zabbix 的历史数据存在关系库的 history 系列表里,可以用数据库自身统计查占用,MySQL 下:
SELECT table_name, ROUND(data_length/1024/1024,1) AS mb
FROM information_schema.tables
WHERE table_schema='zabbix' AND table_name LIKE 'history%';
Prometheus 用本地 TSDB 块,占用看 prometheus_tsdb_storage_blocks_bytes,保留周期由启动参数 --storage.tsdb.retention.time 决定。要换算成钱,去云厂商控制台创建实例页的“规格 / 磁盘 / 存储容量”那一栏看当前报价,别拿旧截图对比,价格和规格这类会变的东西必须现查。
运维
Zabbix 的配置在库里,改模板会影响一批主机,变更通常走前端或 API,回滚靠备份。Prometheus 的配置在文件里,可以进 Git,改完用 curl -X POST http://127.0.0.1:9090/-/reload 热加载(前提是启动时加了 --web.enable-lifecycle)。哪边更好取决于你们团队习惯管库还是管文件,不要假设文件一定更轻。
上手
Zabbix 装上之后在前端点几下就能出图,适合不写代码的运维。Prometheus 要先装 exporter、写抓取配置,再学 PromQL 才能查出想要的东西,但 exporter 覆盖面广,应用侧埋点也容易接。
Zabbix和Prometheus:什么情况选哪一边
- 资产相对固定,主要是物理机、虚拟机、交换机路由器,需要 SNMP、需要中文界面和权限分级:选 Zabbix。前置条件是能接受关系库存历史数据,并且有人维护模板。
- K8s 或容器环境,实例频繁扩缩容,指标需要按标签自由聚合,告警走 Alertmanager:选 Prometheus。前置条件是能维护 YAML 和服务发现配置,并接受 PromQL 的学习成本。
- 已经在用 Zabbix,只想补容器和应用层的观测:让 Prometheus 只抓容器和应用指标,Zabbix 继续管主机与硬件告警,两边分工,不要重复抓同一批系统指标。
“看需求”没有意义,判断点就两句话:被监控对象会不会自己出现和消失;查询时是否需要按任意标签组合聚合。两个都答“会”,偏 Prometheus;两个都答“不会”,偏 Zabbix。
Zabbix和Prometheus:一次能复现的对比做法
在任意一台 Linux 上装好 node_exporter 和 Prometheus 二进制包,新建配置 prom.yml:
global:
  scrape_interval: 15s
  evaluation_interval: 15s
scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['127.0.0.1:9100']
然后依次执行,注意替换二进制路径:
promtool check config prom.yml
./node_exporter --web.listen-address=:9100 &
./prometheus --config.file=prom.yml --storage.tsdb.retention.time=1h --web.enable-lifecycle &
curl -s http://127.0.0.1:9100/metrics | head -n 5
curl -s 'http://127.0.0.1:9090/api/v1/query?query=node_load1' | head -c 400
同一台机器上再取两个 Zabbix Item 做对照,前提是已装 zabbix_agentd 并在服务端配好主机:
zabbix_get -s 127.0.0.1 -k system.cpu.load[all,avg1]
zabbix_get -s 127.0.0.1 -k vfs.fs.size[/,pfree]预期差异很清楚:zabbix_get 一次只针对一个 key 返回一个数值,要拿十个指标就发十次请求;/metrics 一次返回成百上千行,带 job、instance 等标签,PromQL 查询返回的是带标签的时序数组而不是单个值。跑完这一步,选型基本就有感觉了。
最容易踩的坑是把两边的曲线叠在一起比“谁更准”。Zabbix 的 Item 按配置的采集间隔取值,Prometheus 按 scrape_interval 抓取,采样时刻不同,负载这类瞬时值必然对不齐。要比就固定同一间隔、同一时间段,先看数据结构与查询方式是否满足你后续的聚合需求,再谈数值差异。