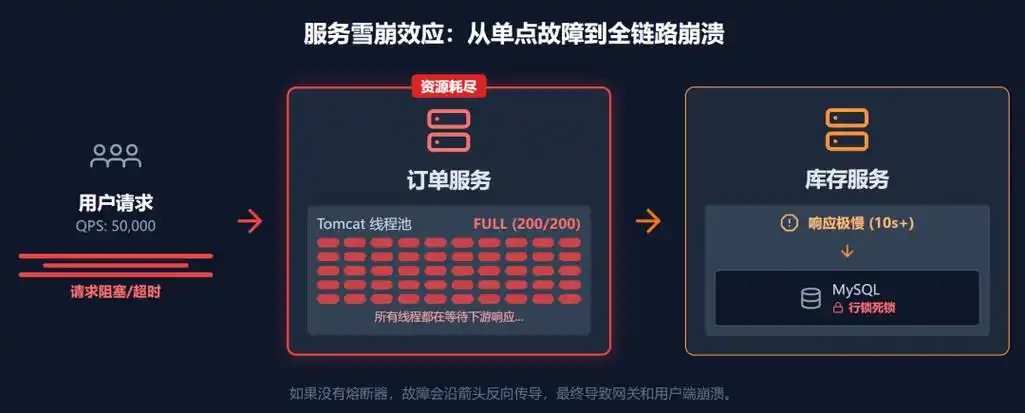
微服务接口超时重试导致雪崩,通常不是因为重试本身写错了,而是重试次数、超时时间、重试范围三者没有一起算过账。一个请求失败后放大成多次调用,下游本来只是慢,被重试打成排队堆积,最终连健康实例也拖垮。要避免这种情况,先要判断当前调用链是否值得重试,再决定在哪一层重试、重试几次、超时怎么设,最后用可观察的信号确认放大效应没有发生。下面按场景判断、处理顺序、验证方法、边界限制四步展开。
接口重试不雪崩的核心是控制调用放大倍数:只对幂等且可恢复的失败(连接失败、明确的 5xx、超时)重试,默认只读接口重试,写接口谨慎;重试次数通常 1 到 2 次,总超时预算固定,单次重试的超时非递增分配;重试放在靠近调用方的一层,链路上不要每层都重试。判断标准是下游错误率是否随重试被放大,验证方式是看调用量和 P99 延迟是否在异常时同步平稳上升而非陡增,边界是重试无法解决容量不足和长时间故障。
先确认当前场景和目标
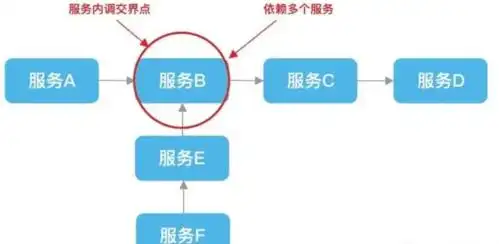
先确认问题成立的前提:调用链上是否存在“超时即失败、失败即重试”的配置,且重试发生在多个层级。如果网关、服务 A、服务 B 都对同一个下游做重试,一次用户请求的实际调用次数是各层重试次数的乘积,这个乘积才是雪崩的来源。读者需要先确认几件事:
- 调用方向:是同步 HTTP/RPC 调用,还是异步消息。同步调用才需要讨论超时重试,异步通常靠重投和消费幂等处理。
- 被调接口是否幂等:查询、按主键读取可以重试;扣款、下单、发消息这类接口重试要有幂等键,否则会重复副作用。
- 失败类型:连接超时、读超时、连接被拒、明确的 5xx、限流返回,处理方式不同。参数错误、404、鉴权失败重试没有意义。
- 调用链有几层会重试:把网关、上游服务、客户端 SDK 的重试配置都查一遍,避免相乘。
- 超时预算:入口请求的整体超时是多少,分给这次调用的时间够做几次重试。
判断条件可以先用一句:该接口幂等、失败类型可恢复、链路只有一层重试、整体超时预算允许,四个条件同时满足才值得配置重试。
按这个顺序处理
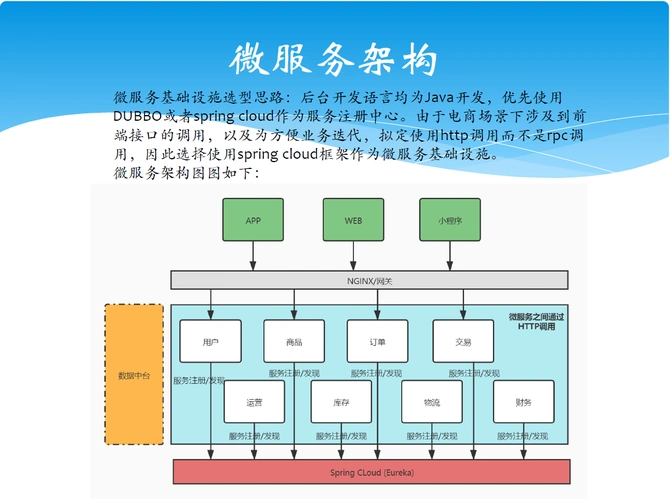
第一步,收敛重试层级。通常只在最靠近业务调用方的一层做重试,网关层对后端服务的重试要关闭或限定为极少数幂等接口,避免多层叠加。检查客户端 SDK、负载均衡、服务网格里是否默认带了重试,这些默认值最容易和业务代码里的重试重复。
第二步,按接口区分策略,不要全局一刀切。可以用一个简单的配置表把接口和策略对应起来:
# 通用策略配置骨架,字段名按实际框架替换
retry:
  read_query:
    enabled: true
    max_attempts: 2          # 首次 + 1 次重试
    retry_on: [connect_timeout, read_timeout, http_502, http_503]
    backoff: fixed            # 短间隔,避免放大
    backoff_delay_ms: 20
  write_order:
    enabled: false            # 写接口默认不重试
    note: 需要重试时必须带幂等键
  total_timeout_ms: 800       # 整次调用的总预算
第三步,超时时间要一起算。单次调用超时 + 重试间隔 + 重试调用超时,三者之和不能超过上游给这次调用的预算。常见做法是重试的超时小于首次超时,让重试有收敛空间,而不是每次重试都等到同样久。
第四步,加重试的熔断与退避。重试前先看下游近期的失败情况,连续失败就快速放弃,避免在故障期间持续放大流量。退避间隔建议固定短间隔或指数退避,但要有上限,不要退避到把上游请求线程全部占住。
第五步,把结果分为三类处理:可重试失败按策略重试;不可重试失败直接返回明确错误;超时预算耗尽直接失败并记录,不要用重试掩盖慢调用。慢调用本身应通过限流、隔离、扩容处理,重试不是解决慢调用的手段。
改完后怎么验证
验证的目标是确认调用放大倍数在预期范围内,而不是看某个百分比收益。可以先在测试环境构造下游延迟和失败,再做以下观察:
- 统计一次入口请求落到下游的实际调用次数。对只读接口应为 1 到 2 次,不应出现被多层重试乘以更多次的情况。
- 观察下游在故障期间的总请求量变化。如果下游错误率上升时总请求量陡增,说明重试正在放大流量,需要下调重试次数或关闭该层重试。
- 观察调用方线程池或连接池的占用。重试期间连接数和等待线程不应持续攀升到打满。
- 看整体超时日志。入口超时数量应在故障期间可控增长,而不是因为重试把请求时间拖长导致大面积超时。
- 对写接口做幂等验证:同一次重试不应产生两条业务记录。
预期信号是:下游出现短暂慢或少量失败时,调用总量只有轻微上升,业务成功率在重试后恢复;下游持续故障时,调用方快速失败而不是堆积。如果观察不到这些信号,优先回到第一步检查是否还有隐藏的重试层。
容易忽略的边界
重试策略有几类场景不适用:下游容量不足、整体故障或数据库锁冲突时,重试只会加重问题,这时应该限流、熔断或降级,而不是加大重试。非幂等接口在未加幂等键前不要开启重试,回退方案是关闭该接口重试并在业务层做补偿或对账。
还有一些实现层面的限制需要注意:部分 HTTP 客户端重试只对连接错误生效,对读超时不生效;部分负载均衡或服务网格的默认重试次数不为零,升级或改配置后可能被重新打开,需要纳入配置检查。重试次数增加会占用调用方的连接和线程资源,在连接池较小的服务里,重试可能先耗尽本地资源再影响下游。
最后,超时和重试配置通常与熔断阈值、限流阈值联动,改其中一个就要复核相邻配置;如果拿不准,优先把重试次数降到最小、把重试范围收窄到明确的幂等接口,再逐步放开,这样出问题时回退成本最低。