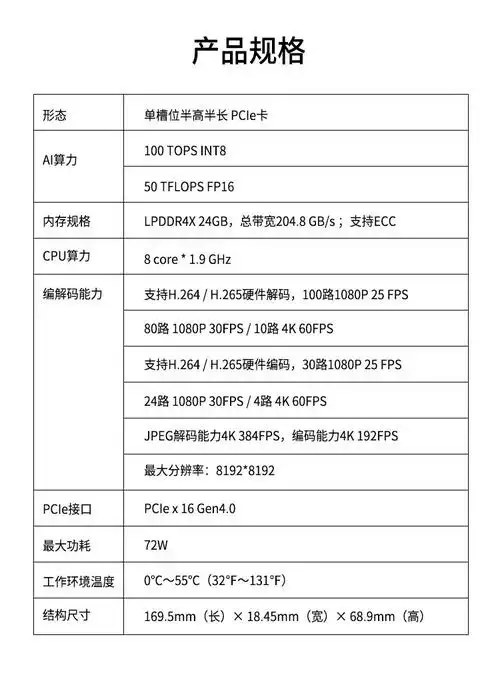
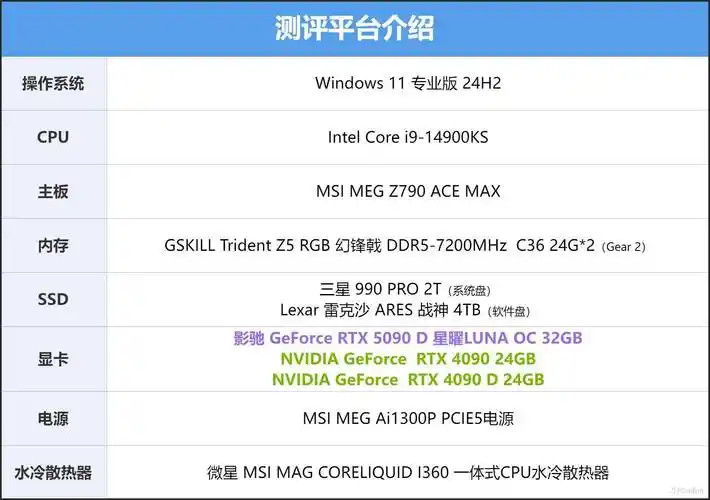
判断 Llama 微调需要什么显卡,先不要按显卡型号下单。更可靠的判断顺序是:模型参数规模、微调方式、训练序列长度、单卡 batch、计算精度和卡数。通常 7B/8B 模型做 QLoRA,24GB 显存显卡可以先作为起步;做 LoRA 时要缩短序列或把 batch 设为 1;13B 模型建议从 24GB 显存起步,但参数稍长就容易吃紧,48GB 级更从容;70B 模型和多卡全参微调不要按单张消费卡规划。全参微调对显存的要求明显高于 LoRA 和 QLoRA,消费卡通常不是全参微调的首选。
如果目标只是把 Llama 7B/8B 做领域适配,24GB 显存显卡通常可以先跑 QLoRA;LoRA 要保守设置序列长度和 batch;13B 建议 24GB 起步并准备 48GB 级回退;70B 与全参微调不要按单卡消费卡规划。先跑通最小 batch 和短序列,观察显存峰值、loss 和保存重载,再决定加卡、换量化或上云。驱动、CUDA、训练框架和量化库的兼容性需要结合本机环境确认。
先确认当前场景和目标
先确认你要做的是领域适配、指令微调,还是继续预训练或全参微调。领域适配和指令微调通常可以先走 LoRA/QLoRA;全参更新会保留更多可训练参数,对显存和卡数要求更高。还要确认是否必须本地训练、能否接受 4bit 量化、最大序列长度、数据是否已脱敏、评估集是否准备好。
- 模型规模:7B/8B、13B、70B 不是同一档显存需求。
- 微调方式:全参、LoRA、QLoRA 的显存占用和可训练参数不同。
- 序列长度与 batch:长序列和较大 batch 会显著抬高显存峰值。
- 精度与优化器:bf16/fp16、优化器状态、梯度检查点都会影响占用。
- 卡数与部署:单卡、多卡、是否上云,决定后续扩展方式。
一个保守判断是:先用最小可行配置跑通,不要把“能加载模型”当成“能稳定微调”。加载成功只说明权重放得下,训练还要放激活、梯度和优化器状态。
按这个顺序处理
- 定基线:先选 7B/8B 或 13B,优先 QLoRA,序列从 512 或 1024 开始,batch 设为 1,用梯度累积补有效 batch。
- 估显存:按权重、激活、梯度和优化器状态粗算,但最终以 nvidia-smi 观察到的峰值为准。
- 准备环境:核对驱动、CUDA、PyTorch、transformers、peft、bitsandbytes 的匹配关系。
- 先单卡最小配置跑通,再逐步加序列或 batch,不要一次把参数拉满。
- 记录每次配置、显存峰值、step 时间和保存结果,便于回退。
下面是一个通用 QLoRA 加载骨架,模型路径、量化类型和计算精度要按你的环境替换;如果训练脚本已经封装,不要直接照搬,只把对应参数映射进去。
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
import torch

MODEL_PATH = '/path/to/llama'
bnb = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type='nf4',
    bnb_4bit_compute_dtype=torch.bfloat16,
)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_PATH,
    quantization_config=bnb,
    device_map='auto',
)
这段只负责加载,实际训练还需要用 peft 包装可训练层。启动时先用单进程或单卡,确认能跑通再改多卡。下面命令里的 train.py、max_seq_length 是示例训练入口和自定义参数,需要换成你仓库实际支持的参数。
export MODEL_PATH=/path/to/llama
export OUTPUT_DIR=/path/to/output
torchrun --nproc_per_node=1 train.py \
  --model_name_or_path $MODEL_PATH \
  --output_dir $OUTPUT_DIR \
  --per_device_train_batch_size 1 \
  --gradient_accumulation_steps 8 \
  --max_seq_length 1024 \
  --learning_rate 2e-4 \
  --gradient_checkpointing true
改完后怎么验证
验证不要只看训练是否退出。先看显存峰值是否稳定,再看 loss、step 时间和保存重载。建议在短序列小 batch 下跑一段基线,再改配置对照;不要用一次 OOM 或一次 loss 波动判断方案好坏。
- 显存:用 nvidia-smi 周期观察 memory.used,确认不会持续上涨到 OOM。
- 训练日志:loss 可以有波动,但不应长期不降或变成异常值;学习率、梯度累积和有效 batch 要一起记录。
- 吞吐:记录每 step 时间或每秒 token 数,作为加卡或换量化的对照。
- 保存与重载:QLoRA 需要确认 adapter 能保存、能合并或能按框架要求加载。
- 评估:用固定验证集看任务指标,避免只看训练 loss。
可以执行:
nvidia-smi --query-gpu=memory.used,memory.total,utilization.gpu --format=csv
watch -n 5 nvidia-smi
预期信号是显存占用在若干 step 后趋于稳定、训练 step 能持续完成、checkpoint 能保存并重新加载;如果显存逐步爬升,先查数据长度分布、缓存和日志累积,不要直接加卡。
容易忽略的边界
显卡型号不是唯一变量。驱动与 CUDA 版本、PyTorch 与 bitsandbytes 的匹配、flash-attn 等可选加速库、多卡通信库 NCCL、文件系统和 checkpoint 写入权限,都可能让同一张卡表现不同。量化加载能降低显存,但不等于全参训练;QLoRA 适合参数高效微调,不适合必须更新全部权重的场景。长序列、较大 batch 和多卡全参会把显存需求迅速抬高。
不适用条件要提前写清楚:70B 全参微调通常不应按单张 24GB 消费卡规划;8k 以上长序列在消费卡上要谨慎;需要高吞吐或严格交付时间时,本地单卡可能不是合适选择。回退建议是先把序列降到 512 或 1024、batch 设为 1、开启梯度检查点、改用 QLoRA,再考虑加卡或上云;CPU offload 和 swap 只能作为临时止血,不应写成性能提升方案。模型许可、数据权限和云卡计费也要在开始训练前确认。