向量数据库召回效果差,先别急着调 HNSW 的 M 或 IVF 的 nprobe。要先分清是哪一类失败:是目标文档根本没进候选集(召回不到),还是进了候选集但排序靠后(排序不到)。前者要从 embedding 一致性、分块质量、过滤条件上找,后者才轮到索引参数和重排。调错方向,参数调得再细也不会有改善。
判断向量库召回差,建议按“评测集 → embedding 与归一化一致性 → 分块 → 过滤与候选量 → top_k 与索引参数 → 混合检索与重排”的顺序排查。适用场景是有明确查询意图、能拿到一批人工标注相关文档的检索或 RAG 场景。操作上先固定几十条 query 和期望文档 id 跑基线,再逐项改动。验证看同一评测集上的 recall@k、空结果率和延迟变化;如果调大 efSearch 或 nprobe 后召回明显回升,说明瓶颈在近似搜索,否则多半在向量表示或分块本身。索引参数放大会占用更多内存和查询时间,改动前保留可回退的旧集合。
先确认当前场景和目标
并不是所有“召回差”都值得调参。如果查询本身表述含糊、语料里确实没有对应内容,或者用户查的是精确编号、日期这类字符串,稠密向量检索本来就不擅长,调索引参数只会让你更快地返回不相关结果。建议先确认下面几件事,再决定是否进入调参流程。
- 问题定义:能否列出至少几十条真实查询,并标注每条查询对应的正确文档或段落 id。没有这份基准,任何参数改动都无法比较,只能凭感觉。
- 失败类型:对每条查询看正确文档是否出现在返回的前 k 条里。完全没出现属于召回缺失;出现了但排在第 20 位,属于排序问题。
- 数据规模与索引类型:集合有多大、用的是 HNSW、IVF 还是暴力检索,是否开了量化(如 PQ、SQ)。小集合用暴力检索就能拿到理论上限,可以当作参照。
- 过滤条件:查询是否带 tenant_id、分类、时间范围等 metadata 过滤。过滤比例高时,候选集会被压得很小,这是召回变差最常见的原因之一。
- 写入可见性:新写入的数据是否已经可查。多数库的索引构建是异步的,刚写入就查不到不代表召回参数有问题。
如果上面几项里有任何一项不清楚,先补齐信息;如果基准已经具备,直接按下一步走。
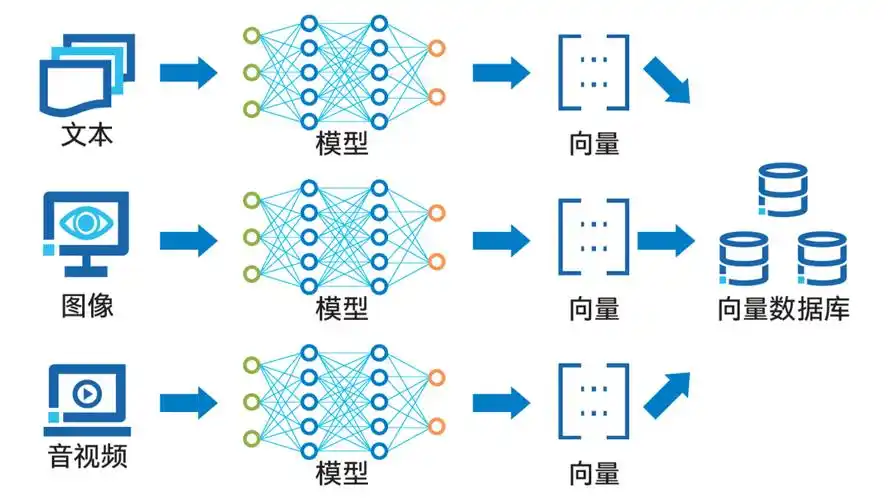
按这个顺序处理
顺序很重要:越靠前的步骤收益越大、成本越低,也越容易被跳过。
- 固化评测集并跑基线。把查询、期望文档 id、当前 top_k、返回结果记录下来,形成可重复运行的脚本。后续每改一项都重跑一次。
- 核对 embedding 一致性。写入侧和查询侧必须是同一个模型、同一版本、同一维度、同一归一化方式。向量做了 L2 归一化,索引却按内积或余弦配置,或者反过来,会系统性拉低相似度排序。部分模型对查询和文档要求不同的前缀或指令文本,也需要确认查询侧是否加了。
- 检查分块。分块过大时,一个段落里混入多个主题,向量会被稀释;过小则缺少上下文,语义指向不清。建议按段落或标题等语义边界切分,保留适度重叠,并检查切分是否把答案句和它的主语切到了两个块里。
- 看过滤和候选量。如果用了后置过滤(先取 top_k 再过滤),过滤率高时结果可能大面积为空。这种场景改成前置过滤,或先扩大取回数量再过滤,效果通常比调索引参数明显。
- 加大 top_k 与索引搜索参数,判断上限。把 top_k 从 5 提到几十,同时临时调大 efSearch 或 nprobe,看召回是否回升。回升说明是近似搜索的损失;不回升说明问题在向量表示或分块,应回到第 2、3 步。
- 补充混合检索与重排。稠密向量对编号、专有名词、缩写不敏感,加入关键词(稀疏)检索做分数融合能补这一类召回。重排模型只改善排序,不解决召回缺失,不要指望它把没检索到的文档捞回来。
下面是通用接入骨架,参数名和取值需要按你实际使用的库替换,仅用于说明改动位置:
# 检索参数配置骨架(字段名按所用量数据库调整)
retrieval:
  top_k: 20            # 先放大,确认召回上限后再收敛
  metric: cosine       # 必须与向量是否归一化保持一致
  index:
    type: hnsw
    M: 16              # 常见默认量级,需结合内存预算确认
    ef_construction: 200
  search:
    ef_search: 128     # 逐级上调观察召回变化
  filter:
    mode: pre          # 高过滤率场景优先前置过滤
    fields: [tenant_id, category]

# 伪代码:对比两套参数的召回差异
def recall_at_k(queries, params):
    hit = 0
    for q in queries:
        ids = search(q.vector, top_k=params.top_k, ef_search=params.ef_search)
        if q.expected_id in ids:
            hit += 1
    return hit / len(queries)
一次只改一个变量,否则无法判断是哪一项起了作用。建议把参数写成配置项而不是散落在代码里,方便回退。
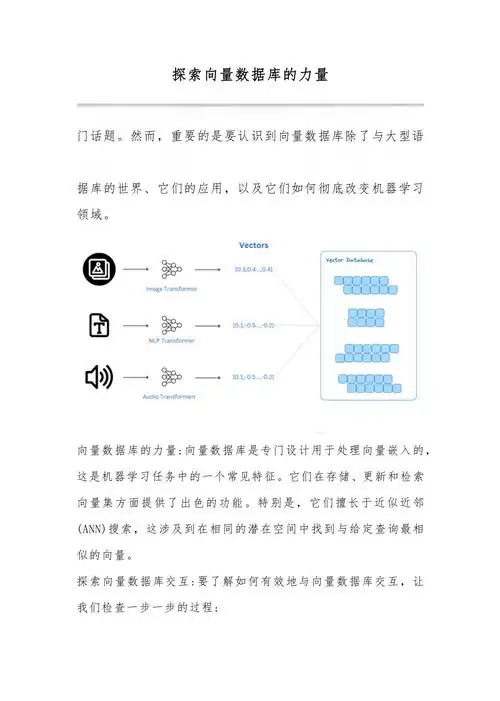
改完后怎么验证
验证要在同一份评测集上进行,对比基线而不是对比印象。
- 候选内命中率:正确文档出现在前 k 条的比例是否上升,这是判断召回是否改善的主要信号。
- 排序指标:如果正确文档本来就在候选里,只是位置靠后,看它排到前列的比例是否改善,这一步主要反映重排的作用。
- 空结果率:带过滤条件的查询里,返回为空的比例是否下降。空结果率居高通常指向过滤模式而非索引参数。
- 延迟与资源:调大 efSearch、nprobe 或 top_k 后,单次查询耗时和内存占用会上升,需要同时记录,确认改善不是以不可接受的开销换来的。
- 交叉检查:从失败样本里抽几条人工看,确认返回的文档在语义上是否真的相关。指标上升但人工看仍不相关的,通常是标注集或分块有问题。
预期信号可以这样理解:调大搜索参数后召回明显回升,说明此前受限于近似搜索;调大后基本不动,说明瓶颈在向量表示、分块或数据本身,继续加参数收益很小。
容易忽略的边界
- 换 embedding 模型必须全量重建。新旧向量混在同一个集合里,相似度不可比,召回会变得不可预测。重建期间建议双集合并行,验证通过后再切换。
- 索引参数与内存强相关。HNSW 的 M 增大会显著提高内存占用,图结构重建耗时也长;IVF 的 nlist 需要与数据量匹配,太小则每个簇过大,检索退化为近似全扫。
- 过滤字段是否建了索引。在部分实现里,未建索引的 metadata 字段做过滤会退化成扫描,查询耗时会突然变长,这类问题容易被误判为向量检索变慢。
- 版本与参数名差异。不同库、不同大版本对同一概念使用不同参数名,默认值也不同,改动前需要结合你所部署版本的实际行为确认,不要直接照搬别处的配置。
- 不适用条件。查询主要是精确匹配编号、短关键词或强结构化条件时,稠密向量检索本身不合适,应优先走关键词或结构化查询,再考虑融合。
- 回退建议。参数调整保留旧配置和旧索引,出现召回下降或延迟不可接受时能快速切回;对线上集合做重建类操作前,确认有快照或可恢复路径。