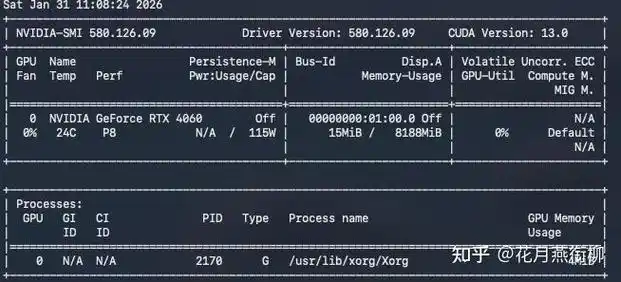
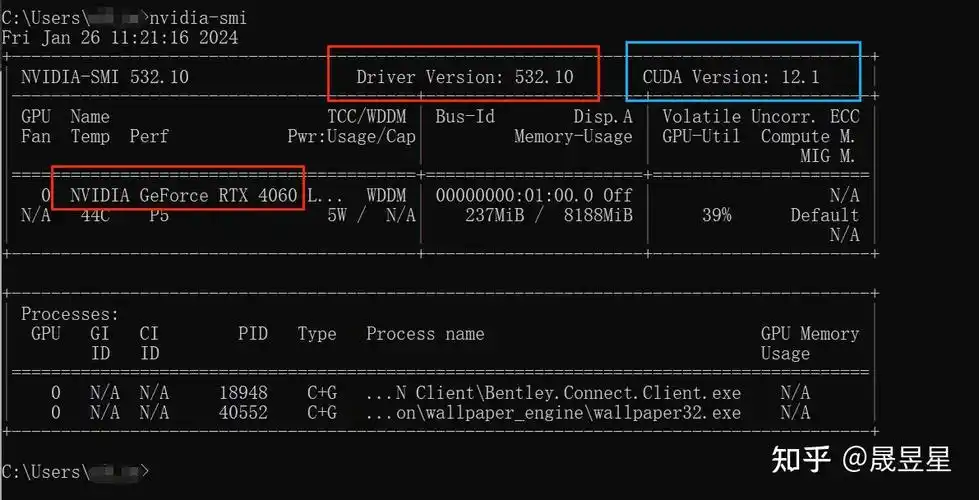
看 CUDA 运行时和驱动版本的对照,关键不是让两个版本号相等,而是判断方向:驱动能支持的最高 CUDA 运行时版本 ≥ 实际加载的运行时版本。驱动偏低会直接报 CUDA driver version is insufficient for CUDA runtime version;驱动偏高通常不影响旧运行时,因为驱动 API 向后兼容。所以先要分清手上两个数字各代表什么:nvidia-smi 右上角的 CUDA Version 是驱动支持的上限,nvcc --version 或框架自报的版本是实际运行时。
先确认两件事:驱动上限看nvidia-smi,运行时版本看nvcc --version或框架输出。比较方向是“运行时 ≤ 驱动上限”,相等并非必要条件。满足就不用动;不满足时优先升级驱动,或者改用与驱动匹配的运行时镜像、conda 环境,不要靠改/usr/local/cuda软链接来绕过。
先确认当前场景和目标
这个问题通常在几种场景下成立:新装机器跑深度学习框架报 CUDA 版本不足;容器镜像里自带的运行时比宿主机驱动新;一台机器要同时跑两个依赖不同 CUDA 版本的项目;或者只是想知道“我到底该装哪个版本的 CUDA”。不同场景的处理方向不一样,先确认三件事。
- 报错属于哪一层:是
nvidia-smi本身不可用(驱动或内核模块问题),还是驱动正常但运行时报版本不足(运行时问题)。前者不是版本对照能解决的。 - 运行时是谁提供的:系统级
/usr/local/cuda、conda 环境里的 cudatoolkit、pip 安装的框架自带 runtime、还是容器镜像。同一台机器上这几处版本可能互不相同。 - 是否在容器内:容器共享宿主机驱动,但运行时来自镜像。容器里跑不通时,先比对宿主驱动上限和镜像运行时版本。
目标也明确:让实际加载的运行时版本落在驱动支持的范围内,且不改动不该改的系统组件。
按这个顺序处理
按从外到内的顺序查,避免一上来就重装驱动。
- 查驱动支持的上限:执行
nvidia-smi,记录右上角 CUDA Version 和 Driver Version。如果命令不存在或报错,先解决驱动安装问题。 - 查工具链运行时版本:执行
nvcc --version,看 release 字段。 - 查框架实际用的运行时:Python 生态里以框架自报为准,因为它可能加载自带的 runtime。
- 查实际加载的库路径:确认进程真正链接的是哪个
libcudart,而不是软链接指向。 - 比较并决定动作:运行时 ≤ 驱动上限,通常无需处理;运行时 > 驱动上限,升级驱动成本最低,其次是换匹配的运行时环境。
# 1. 驱动与驱动支持的上限
nvidia-smi

# 2. 本地 CUDA 工具链版本
nvcc --version
ls -l /usr/local/cuda

# 3. 框架侧自报的运行时版本(以 PyTorch 为例)
python -c "import torch; print(torch.__version__, torch.version.cuda, torch.cuda.is_available())"

# 4. 确认进程实际链接到的运行时库
ldd $(python -c "import torch,os;print(os.path.join(os.path.dirname(torch.__file__),'_C*.so'))") 2>/dev/null | grep -i cudart
需要同时看驱动 API 和运行时 API 两个数字时,可以直接调用 CUDA 接口,比翻日志可靠:
#include <cuda_runtime.h>
#include <cstdio>
int main() {
    int rt = 0, drv = 0;
    cudaRuntimeGetVersion(&rt);
    cudaDriverGetVersion(&drv);
    printf("runtime=%d driver=%d\n", rt, drv);
    return 0;
}
// 编译:nvcc check.cu -o check && ./check
两个数字含义是:driver 表示驱动支持的最高运行时版本,runtime 表示程序编译或链接时用的运行时版本。runtime 高于 driver,说明该程序在当前驱动上跑不起来,这是判断的核心依据。
改完后怎么验证
改动后不要只看安装日志成功,按下面几项确认。
- 重新执行
nvidia-smi,驱动版本和 CUDA Version 是否已更新。刚装完驱动若不重启、不重新加载内核模块,可能出现版本显示未变或设备不可用。 - 重新打开终端再执行
nvcc --version,确认 PATH 和/usr/local/cuda指向预期版本。 - 用框架做一次最小可用性检查:
torch.cuda.is_available()为 True,并尝试在 GPU 上分配一个小张量、做一次加法并同步,确认没有版本相关报错。 - 容器场景在容器内重复上述检查,不要只在宿主机验证;容器内看到的驱动来自宿主,运行时来自镜像。
- 如果项目有自己的构建步骤,重新编译一次带 CUDA 的扩展,确认编译期和运行期用的是同一套运行时。
预期信号是:没有“运行时版本不足”或“找不到 libcudart”两类错误,且上述命令输出的版本关系符合运行时 ≤ 驱动上限。若验证失败,先回退本次改动再继续排查,不要在失败状态上叠加更多修改。
容易忽略的边界
- 向后兼容和同主版本兼容不是一回事:驱动 API 对旧运行时向后兼容,但同一主版本内的小版本兼容有前提条件,跨主版本不能想当然。具体关系需要结合驱动的 release notes 和框架要求确认。
- 软链接不等于实际加载:把
/usr/local/cuda指向另一个版本,只影响编译期查找,不改变已经装好的框架所链接的 runtime。 - conda 和 pip 会自带 runtime:装完框架后系统
nvcc的版本可能和框架实际用的是两套,判断时以框架自报版本为准。 - 升级驱动有权限和可用性代价:需要 root 或管理员权限,共享机器、云主机、托管集群上不一定能自行升级,通常要走镜像或工单。这类环境下更现实的做法是用与宿主驱动匹配的容器镜像运行,而不是动驱动。
- 不适用条件:如果
nvidia-smi就不可用,问题在驱动或设备层面,版本对照解决不了;如果是多卡通信、显存不足一类现象,也不要先怀疑版本不匹配。 - 回退建议:改动驱动前记录当前驱动版本和可用镜像,出问题时回退到原驱动版本或原镜像标签,比逐个尝试运行时版本更快收敛。