Python 读取 CSV 出现中文乱码,通常不是 Python 本身的问题,而是「文件用什么编码写出来的」和「open / read_csv 用什么编码读」不一致。先别急着改代码,先把「解码报错」和「能读出来但字符是乱码」分开看:前者会抛 UnicodeDecodeError,说明编码猜错;后者不报错,往往是编码能用但选错了,或者表头带了 BOM。判断清楚再改,通常一次就能定位。
处理顺序建议:先确认文件来源(Windows 版 Excel 导出的 CSV 常是 GBK/GB18030,或带 BOM 的 UTF-8),再试 utf-8-sig,不行再试 gb18030;用 csv 模块时加 newline='',读出来用 repr 看表头和首行。不要用 errors='ignore' 掩盖问题,也不要对来源不明的文件硬编码编码,重要文件先备份再改写。
先确认当前场景和目标
问题成立的前提是:同一个 CSV 文件在 Excel 或记事本里中文正常,在 Python 里读出来是「锟斤拷」「」「�」之类,或者直接抛 UnicodeDecodeError。如果原文件本身就乱,Python 换什么编码都救不回来,需要先找到正确的原始文件。
动手前建议确认三件事:
- 文件来源:从 Excel「另存为 CSV」、从数据库导出、还是程序生成。Windows 中文环境下的 Excel 导出的 CSV,常见编码是 GBK 系;带 BOM 的 UTF-8 会在文件开头多出几个字节,读进第一列后表现为表头前面有奇怪字符。
- 报错形态:是解码失败,还是解码成功但字符不对。两者处理路径不同。
- 读取方式:用内置 csv 模块还是 pandas。pandas 最终也走编码参数,但多列类型推断,问题会藏得更深一点。
另外确认 Python 版本是 3.x,open() 才有 encoding 参数;Python 2 的写法不在本页讨论范围内。
按这个顺序处理
第一步看文件头几个字节,判断有没有 BOM,这一步不需要安装任何库。把路径换成你的文件:
from pathlib import Path

head = Path('data.csv').read_bytes()[:4]
print(head)   # UTF-8 BOM 通常是 b'\xef\xbb\xbf' 开头
第二步用 utf-8-sig 读一次。它能同时兼容「带 BOM 的 UTF-8」和「不带 BOM 的 UTF-8」,是通用首选。csv 模块要加 newline='',否则 Windows 换行会被拆出空行:
import csv

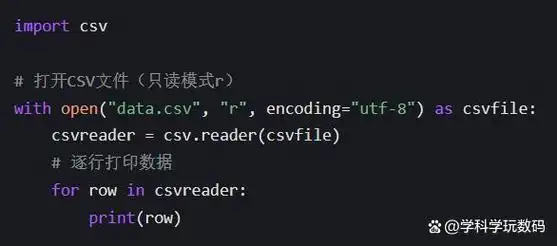
with open('data.csv', 'r', encoding='utf-8-sig', newline='') as f:
    reader = csv.reader(f)
    header = next(reader)
    first = next(reader, None)

print(header)
print(first)
第三步,如果第二步抛 UnicodeDecodeError,再试 gb18030。gb18030 覆盖面比 gbk 广,作为兜底更稳。可以写一个小函数把「先试哪个、失败换哪个」固定下来,路径和编码列表按你的环境替换:
def read_csv_text(path, encodings=('utf-8-sig', 'gb18030')):
    for enc in encodings:
        try:
            with open(path, 'r', encoding=enc, newline='') as f:
                return f.read(), enc
        except UnicodeDecodeError:
            continue
    raise ValueError('候选编码都无法解码,请抽样确认文件实际编码')

text, used = read_csv_text('data.csv')
print('实际使用编码:', used)
print(text[:200])
用 pandas 的话,参数是同一个思路:
import pandas as pd

df = pd.read_csv('data.csv', encoding='utf-8-sig')
print(df.columns.tolist())
print(df.head(3))
如果读取没问题、但用 pandas 或 csv 写回文件后又被 Excel 打开成乱码,问题在写出环节。写 UTF-8 时加 BOM,Excel 通常能正确识别中文:
df.to_csv('out.csv', index=False, encoding='utf-8-sig')整个过程中不建议用 errors='ignore' 或 errors='replace' 去「读通」。它们会让坏字节被静默丢掉或替换成占位符,字段内容已经变了,后面很难发现,只适合临时查看结构,不适合进入数据流程。
改完后怎么验证
不要只看 print 出来「像中文」就结束。建议做三个检查:
- 用 repr 看表头和首行,能暴露不可见字符和前导 BOM:
print(repr(header[:3])),正常结果里不应该出现 \ufeff 或 \ufffd。 - 核对列数和字段数:
print(len(header), len(first)),与源文件表头逐个数一遍,避免换行或分隔符被误解析导致列错位。 - 抽查关键列:挑一两行含中文的字段,和 Excel 里看到的内容逐字对比,包含标点、空格和全角半角。
读取稳定后,再看一次行数是否和使用 sum(1 for _ in f) 之类的粗糙计数接近,能发现空行或缺行问题。验证通过再把这个编码参数固化到读取函数里,不要在多处重复写死。
容易忽略的边界
编码判断有几个容易踩的限制。gb18030 不是万能的,繁体中文文件可能是 big5,部分系统导出可能带 utf-16 的 BOM,这些都需要结合文件来源确认,不能见到乱码就一律换成 gb18030。用字符集检测库(如 charset-normalizer)猜编码时,样本太短或中文占比低,结果不稳定,只能作为提示,不能当结论。
另外注意:读取权限不足或被其他程序占用时会报 PermissionError,这和编码无关,别混在一起排查;从标准输入、网络流读 CSV 时,编码可能已被上游解码,重复指定 encoding 会出错;修改并覆盖原文件前建议先备份,尤其是原始数据只有一份的时候。如果环境不允许改文件编码,退一步的做法是在读取层做解码,把统一后的文本交给后续处理,而不是反复改写源文件。