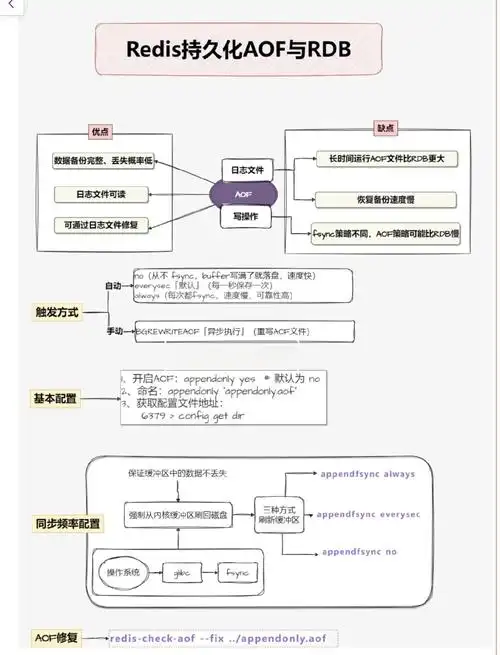
Redis 持久化选型没有普适答案,判断依据主要落在两件事上:重启后能接受丢多少写入,以及恢复时能等多久。RDB 是某一时刻的全量快照,文件紧凑、加载快,但两次快照之间的写入会丢;AOF 记录写命令并按策略刷盘,丢数据的窗口更小,代价是文件更大、恢复更慢、重写时更吃磁盘和内存。承载真实数据的实例通常建议先开 AOF(appendfsync everysec),再保留 RDB 做归档备份;纯缓存、数据能从数据库重建的实例,可以只留 RDB,甚至直接关闭持久化。版本支持混合持久化时,可以先开它,让 AOF 文件前缀以 RDB 形式保存,缩短加载时间。
先判断实例是缓存还是真实数据源:可重建的缓存可以只留 RDB 或关闭持久化;不可重建的数据优先追加 AOF 并按 everysec 刷盘,同时保留 RDB 做备份,版本支持时开启混合持久化。改完用 INFO persistence 观察 rdb_last_bgsave_status、aof_last_write_status,并拿一份副本做重启加载演练。边界是:everysec 仍可能丢最后一小段写入,AOF 重写与 fork 会带来磁盘和内存压力,托管实例的参数往往要在控制台改而不是改 redis.conf。
先确认当前场景和目标
动手改配置之前,先把下面几项确认清楚,否则很容易选了不适合自己环境的方案。
- 数据性质:重启后丢失的数据能不能从 MySQL 等上游重建。能重建,RDB 就够;不能重建,AOF 的优先级要提上来。
- 可接受的丢数据窗口:这是排序的条件。业务能接受丢最近若干分钟的数据,RDB 的快照间隔可以覆盖;要求尽量少丢,就得靠 AOF 的刷盘策略,而不是把 RDB 的 save 间隔调到很小——那会让 fork 和磁盘写入变频繁。
- 恢复时间要求:RDB 加载是全量读文件,通常比逐条重放 AOF 快;实例数据量大、故障恢复窗口紧,就需要考虑混合持久化或 RDB 兜底。
- 磁盘与 IO 余量:AOF 文件会持续增长,重写期间新旧文件同时存在,磁盘需要留出空间;磁盘 IO 本来就紧张时,everysec 刷盘和后台重写都可能带来延迟抖动。
- 部署形态与版本:单机、主从、哨兵、集群,决定每个节点要不要持久化;是否为云托管实例,决定你能改哪些参数;版本是否支持
aof-use-rdb-preamble,决定能否使用混合持久化。
按这个顺序处理
- 先记录当前状态。执行
redis-cli CONFIG GET appendonly appendfsync save dbfilename dir,把结果留档,再执行redis-cli INFO persistence看当前的 rdb 与 aof 状态。没有基线,后面改了也说不清变化。 - 按数据性质定主方案。缓存型实例:保留 RDB 的 save 规则,用
BGSAVE或定时任务把 dump.rdb 归档到备份存储。数据型实例:开启 AOF,刷盘策略先取everysec,不轻易上always;always每条写入都刷盘,延迟代价明显,只适合写入量很小又极度在意丢数据的场景。 - AOF 与 RDB 并存,但要分工。AOF 负责减少丢数据,RDB 负责备份和快速加载,两者不是互斥选项。下面是一份通用起点,路径、文件名按自己环境替换:
# redis.conf 片段,仅示意关键项,按实例角色调整
dir /data/redis
appendonly yes
appendfsync everysec
appendfilename "appendonly.aof"
# 版本支持时开启,形成 RDB 前缀 + AOF 增量
aof-use-rdb-preamble yes

# RDB 保留为备份与快速恢复手段
save 900 1
save 300 10
dbfilename dump.rdb
stop-writes-on-bgsave-error yes
关于 no-appendfsync-on-write 需要单独取舍:设为 yes 可以缓解刷盘期间的阻塞,但故障时可能丢的数据窗口随之变大,磁盘 IO 不紧张时建议保持默认 no。
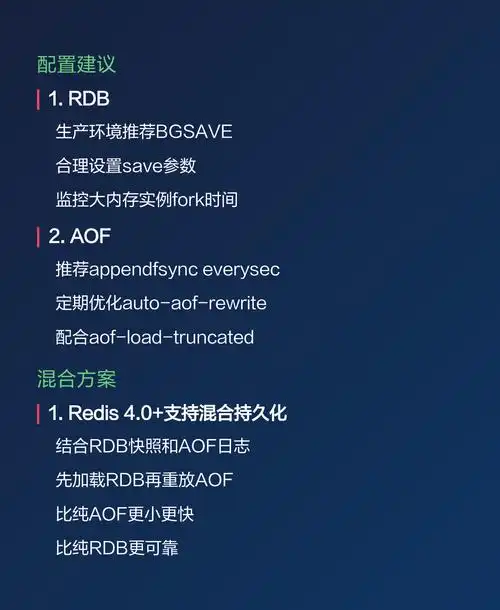
- 考虑混合持久化。版本支持
aof-use-rdb-preamble yes时,AOF 重写后的文件前半部分是 RDB 格式、后半部分是增量命令,加载更快,写盘体积也小一些。开启后要确认重写流程正常,不能只看配置项是否为 yes。 - 决定从库与备份节点怎么配。主库承担写入,从库可以有独立的持久化策略;用于备份的节点通常会保留 RDB 并把文件同步到对象存储,避免备份动作和主库争抢同一块盘的 IO。
改完后怎么验证
改配置只是一半,另一半是把“能恢复”这件事验证出来。线上实例不要直接重启做实验,先复制一份数据到测试实例再演练。
- 看运行时状态:执行
redis-cli INFO persistence,重点看rdb_last_bgsave_status、aof_last_write_status是否为 ok,aof_rewrite_in_progress、rdb_bgsave_in_progress是否已回落为 0。出现 err 或长期卡在 in_progress,说明磁盘或进程有问题。 - 主动触发一次快照:执行
redis-cli BGSAVE,随后观察rdb_last_bgsave_time_sec和latest_fork_usec,与实例内存规模对照,判断 fork 开销是否可接受;如果 fork 耗时明显偏长,说明内存页复制压力大,需要评估实例规格或换用其他节点执行。 - 做一次真实加载演练:把测试实例停掉,把
appendonly.aof或dump.rdb放进dir指向的目录,重启后核对DBSIZE与抽样 key 的值是否符合预期。只有这一步通过,才能说持久化配置是有效的。 - 观察磁盘增长:持续看 AOF 文件大小和重写频率,确认磁盘余量能覆盖一次重写所需的额外空间,避免磁盘写满导致写入被拒。
容易忽略的边界
- everysec 不是零丢失。它把丢数据窗口压到很小,但进程崩溃或机器掉电时,最后一次刷盘之后写入的命令仍可能丢失,不能按“绝对不丢”来做业务承诺。
- 托管实例参数常常改不了。云上的 Redis 往往只开放部分参数,持久化策略要在控制台或规格里选,直接改配置文件可能无效,甚至被重启覆盖,动手前先确认入口。
- 关闭持久化是有效选项,但要写进运维约定。纯缓存实例关闭 AOF 和 RDB 可以减少 fork 和磁盘压力,代价是重启后实例为空,需要确认上游能快速回填、且有预热方案。
- 内存与持久化要一起看。开启 RDB 后 fork 会带来写时复制开销,内存占用较高时可能触发换页;同时
maxmemory与淘汰策略要和持久化目标一致,否则可能出现该保留的数据先被淘汰。 - 版本差异要确认。混合持久化相关参数在较早版本中不一定存在,配置写进去可能被忽略或导致启动报错;升级或迁移版本后,建议重新核对一遍相关配置项是否生效。
- 回退方案。如果开启 AOF 后发现磁盘或延迟不可接受,可以先把
appendfsync调回 everysec、临时提高重写触发阈值,再决定是否关闭 AOF;关闭前务必先做一次 BGSAVE 并确认 dump.rdb 已落地,避免回退过程中出现无可用恢复文件的状态。