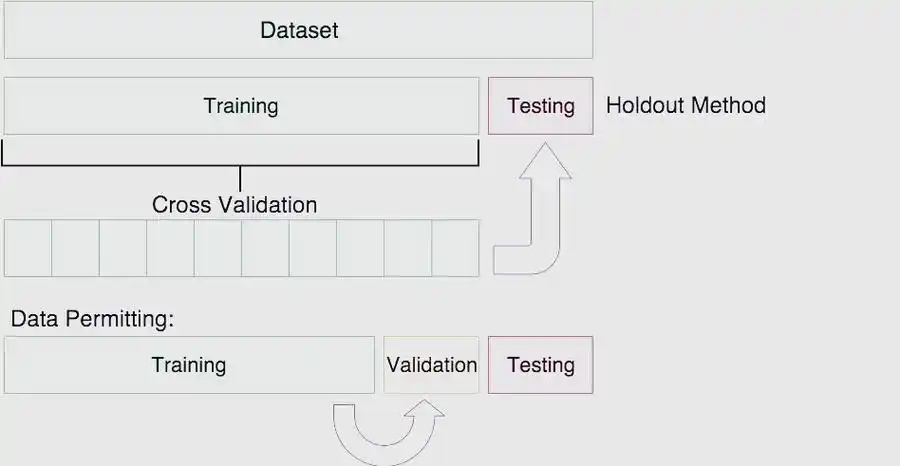
微调数据集的训练集、验证集、测试集比例没有通用最优值,先看三件事:数据总量、任务类型,以及验证集要承担什么职责。数据只有几百条时,按比例切出来的验证集波动会很大;数据有几万条时,1% 的验证集也可能足够。常见起步做法是 8:1:1 或 9:0.5:0.5;如果有独立的测试集,就把验证集和测试集的职责分开:验证集用于早停和选超参,测试集只在最后一次使用。划分之前先去重、按标签分层,比纠结具体比例更重要。
建议先按 8:1:1 或 9:0.5:0.5 起步:几千条以上的数据集,验证集留出几百条就能看趋势;几百条以内的小数据集,靠比例划分意义有限,更适合交叉验证。划分前先去重并按标签分层,切完立刻固定测试集,只用于最后一次评估。
先确认当前场景和目标
动手切分之前,先把下面几项信息写成一句话,写不出来说明还没到划分阶段:
- 任务类型:分类、抽取、生成或对话。分类任务要保证每个类别在验证集里都有足够样本,稀有类别可能只有几条,随机切分会直接掉光。
- 数据总量与来源:总量决定了比例的下限。几百条量级的数据,验证集只有几十条,指标抖动会盖过模型改进本身。
- 验证集的用途:只是看 loss 走势,还是要做超参搜索和早停。要搜索超参,验证集就不能太小,否则选出来的参数是被噪声选出来的。
- 是否存在天然分组:同一个用户、同一篇文档切出的多个片段、同一段多轮对话,都属于同一组,必须整组进入同一个集合。
- 是否有独立测试集:如果已经有一批人工标注的留出数据,就不要再从训练数据里切测试集,避免评估口径混乱。
这些条件确认完,比例才有讨论基础。数据量小、类别多、有分组结构,任何一种情况都会让“标准 8:1:1”失效。
按这个顺序处理
顺序错了,后面怎么调比例都补不回来。建议按下面几步走:
- 清洗与去重:先去掉完全重复样本,再用文本前缀哈希或相似度做近重复检查。跨集合的近重复是微调评估里最常见的数据泄漏来源。
- 先切测试集,再切验证集:从全量里先拿出测试集固定下来,剩下的再分成训练和验证。这样测试集不会被后续调整反复污染。
- 按标签分层,同时看一眼长度分布:分层保证各集合的类别比例接近,长度分布偏差过大时,验证集 loss 和训练集 loss 不可比。
- 固定随机种子并落盘索引:把每个集合的样本 id 存成文件,后续换参数复现时直接读索引,不要每次重新随机。
- 有分组字段时改用分组切分:确保同一组的样本只出现在一个集合。
from sklearn.model_selection import train_test_split
import json

# records: [{"id": ..., "text": ..., "label": ...}, ...]
labels = [r["label"] for r in records]

# 先切出测试集,锁住
rest, test = train_test_split(
    records, test_size=0.1, stratify=labels, random_state=42)

# 再从剩余数据切验证集
rest_labels = [r["label"] for r in rest]
train, val = train_test_split(
    rest, test_size=0.11, stratify=rest_labels, random_state=42)

for name, part in [("train", train), ("val", val), ("test", test)]:
    with open(f"{name}_ids.json", "w") as f:
        json.dump([r["id"] for r in part], f)

print(len(train), len(val), len(test))
代码里的 test_size 只是示例,换成自己的目标比例即可。输出三个数量后先人工确认:验证集和测试集里每个类别是否都还有样本,最小类别是否已经空掉。
改完后怎么验证
切分完成后,不要立刻开始训练,先做几项检查,这些检查比看指标更早暴露问题:
- 规模与分布:打印三个集合的样本数、各标签占比、文本长度分位数。验证集与训练集的标签占比差距明显时,回到分层切分。
- 泄漏检查:把训练集文本和验证集文本做一次前缀或 n-gram 重叠比对,命中的样本要人工看一遍,确认不是同一来源的重复表述。
- 基线训练:先跑一个短轮次的训练,观察训练 loss 与验证 loss 的走势。验证 loss 很早就开始上行、训练 loss 持续下降,通常意味着验证集太小或分布偏了,而不是模型过拟合这么简单。
- 测试集只评一次:最终指标用测试集评一次并记录,不要拿测试集反复调参。如果必须用测试集判断方案优劣,说明验证集没有承担起职责。
预期信号是:验证集指标随训练平稳变化,不同随机种子之间差异在可接受范围内,测试集结果与验证集结论方向一致。差异过大时,先怀疑切分和泄漏,再怀疑模型。
容易忽略的边界
以下几种情况不适合直接套用比例划分,需要换思路:
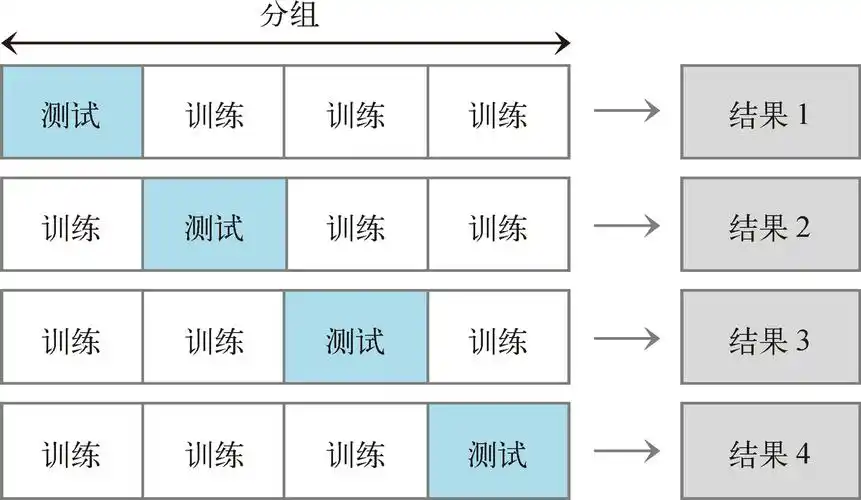
- 数据量在几百条以内:按比例切出的验证集太小,指标不可信。可以先用交叉验证评估,或把验证集换成固定的人工评估集。
- 时序或流式数据:不能随机切分,要按时间切,用较早数据训练、较晚数据验证,否则相当于用未来信息评估过去。
- 多轮对话与长文档切片:按会话或按文档整组切分,按轮次或按段落随机切会把同一上下文拆散到训练和验证两侧。
- 类别极度不平衡:分层切分后仍可能有类别在验证集里为空,这时需要合并稀有类别、单独取样,或改用不依赖单类指标的评估方式。
- 分布漂移:训练数据来自历史批次、验证数据来自新批次时,比例再合理,验证结果也只能说明跨分布表现,不能直接当作同分布指标。
回退建议:如果按目标比例切分后发现验证集指标抖动过大、稀有类别缺失或泄漏检查不通过,先退回更保守的做法,即扩大验证集、减少训练集占比,再重新洗数据和分组,而不是靠调整训练轮次或学习率去掩盖切分问题。