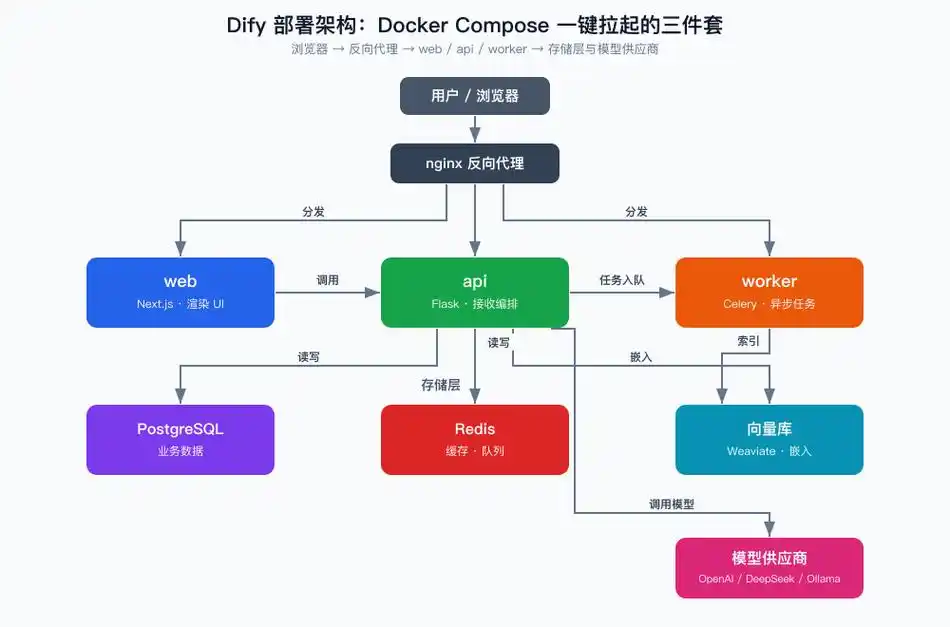
把 AI 知识库跑在 Docker 里,实际是把四个东西拼起来:向量库、负责切片与检索的后端服务、负责向量化的嵌入模型,以及前面的 Web 界面或网关。能不能一次启动成功,通常取决于三件事有没有先想清楚:文档放在哪、向量化放在本地还是走外部接口、机器内存和磁盘够不够。下面按“先确认—再动手—再验证—最后划边界”的顺序给出一套可以直接替换参数的通用做法,具体端口、健康检查路径和镜像名需要结合你选的组件确认。
Docker 部署 AI 知识库的适用前提是:文档可以集中放进一个挂载目录,嵌入模型要么能在本机跑、要么接受调用外部接口,机器内存能同时容纳向量库与模型进程。操作上建议先只起向量库和后端两个容器,跑通“上传一份文档→提问能命中”再补前端和网关。验证看三处:容器状态、健康检查返回、一次带引用的问答结果。边界在于向量维度必须与向量库 collection 一致、数据卷必须持久化、端口不要直接暴露到公网,镜像 tag 不建议长期用 latest。
先确认当前场景和目标
不是所有知识库都适合用同一套 Docker 组合。先确认下面几项,判断条件对不上就先改方案,而不是先写 compose 文件:
- 文档规模与格式:几十份 PDF 和几十万条工单是两种部署,前者单机容器足够,后者需要评估向量库的分片与磁盘占用。
- 数据能否出网:如果文档涉密,嵌入模型必须本地部署,这会直接决定是否需要 GPU 或至少更大的内存。
- 使用者数量:只有自己用,可以不装鉴权;多人使用就必须在网关层加登录和限流,否则后端接口等于对外开放。
- 更新频率:文档经常变,就要确认后端是否支持增量索引;只能全量重建的话,需要预留重建期间的可用性方案。
- 磁盘与备份:向量库、原始文档、模型权重通常要占掉可观空间,宿主机剩余空间和备份路径要提前规划。
如果以上任一项暂时无法确定,建议先用最小组合跑通流程:一个向量库容器 + 一个后端容器,嵌入模型先用外部接口,确认整条链路可用后再替换为本地模型。
按这个顺序处理
第一步,规划目录结构。把所有需要持久化的内容集中到项目目录下,不要留在容器内:
kb/
├── docker-compose.yml
├── .env
└── data/
    ├── vector/     # 向量库数据
└── docs/ # 原始文档,供后端读取与重建索引第二步,写配置。下面是一份通用骨架,镜像名、端口和数据路径都要替换成你所选组件实际使用的值,不要原样复制:
services:
  vector-db:
    image: <向量库镜像>:<固定版本tag>
    restart: unless-stopped
    volumes:
      - ./data/vector:/var/lib/data
    ports:
      - "127.0.0.1:6333:6333"

  kb-api:
    image: <知识库后端镜像>:<固定版本tag>
    restart: unless-stopped
    env_file: .env
    depends_on:
      - vector-db
    volumes:
      - ./data/docs:/app/docs
    ports:
      - "127.0.0.1:8080:8080"
端口前面绑定 127.0.0.1 是有意为之:只有本机能访问,需要外部访问时再通过反向代理转发并加鉴权,避免容器直接暴露在公网。
第三步,填环境变量。把密钥和模型参数写在 .env 里,不要写进镜像或 compose 明文:
VECTOR_DB_URL=http://vector-db:6333
EMBEDDING_PROVIDER=local
EMBEDDING_MODEL=<模型名>
EMBEDDING_DIM=<向量维度,需与向量库collection一致>
CHUNK_SIZE=800
CHUNK_OVERLAP=100
ADMIN_TOKEN=<自行生成的长随机串>第四步,先起依赖再起服务。向量库要先就绪,后端启动时通常会连接并检查 collection:
docker compose pull
docker compose up -d vector-db
docker compose logs -f vector-db   # 等到出现监听端口或就绪日志
# 另开终端
docker compose up -d kb-api第五步,导入文档。把文件放进 ./data/docs,再通过后端的导入接口或自带命令行触发索引。这一步的具体命令取决于你选的后端,判断标准只有一个:日志里能看到切片数量与写入成功的记录,且没有维度不匹配的报错。
改完后怎么验证
验证不要只看容器是不是 Up,建议按下面顺序逐项确认:
- 看容器状态与日志:
docker compose ps确认没有反复重启,docker compose logs --tail=100 kb-api中不应出现连接超时或向量维度错误。 - 打健康检查接口:
curl -s http://127.0.0.1:8080/health,返回内容以你所选后端的实际定义为准;没有健康接口时,用一次列表或统计请求代替。 - 做一次可判断对错的问答:先放一份只有你知道答案的文档,例如一份内部操作说明,然后提问一个只能从该文档得到答案的问题,观察返回内容是否带原文片段引用。
- 验证持久化:
docker compose down后重新up -d,再次提问同一个问题,命中结果应当仍然存在,以此确认数据确实落在挂载卷上而不是容器内部。 - 验证增量:往
data/docs加一份新文档并重新索引,再问一个只在新文档里出现的问题,确认能被检索到。
预期信号是:问答结果里能指出引用来源文件;如果回答通顺但引用为空,通常说明检索没有命中,问题在切片或嵌入环节,而不在生成模型。
容易忽略的边界
- 镜像版本:生产用途不建议长期使用 latest,向量库与后端的大版本升级可能改变接口或索引格式,建议固定 tag 并记录在案。
- 向量维度一致性:换嵌入模型时必须同步重建 collection,维度不一致会让写入静默失败或检索结果异常;这是最常见的一类“看起来跑起来了但答不出”的情况。
- 资源与并发:本地嵌入模型对内存和显存要求较高,容器不设资源限制时可能拖垮宿主机,建议在 compose 中加限制并结合机器实际负载调整。
- 权限与暴露面:管理接口、导入接口都应加鉴权;反向代理层建议同时限制上传大小和请求频率,避免被当作免费接口使用。
- 不适用条件:如果文档需要严格的按人授权(每人只能查自己可见的文档),通用开源组合通常需要自行在检索层做过滤,不能只靠容器隔离实现。
- 回退建议:升级前备份
data/vector和 compose 文件,出现索引不兼容时先回退镜像 tag 与数据卷快照,再排查维度或接口变化。